

MySQL InnoDB 索引数据结构详解

本文深入解析 MySQL InnoDB 存储引擎的索引数据结构,详细对比 B+Tree 与 B-Tree 的差异,计算基于逻辑页(16KB)和主键指针的树高影响。文章涵盖联合索引的查询匹配规则、使用限制以及自适应哈希索引特性,为掌握高性能 SQL 优化策略提供理论基础。
索引在数据库中的核心作用
索引(Index),通常也称为 key,是数据库优化中提升查询性能最有效的手段之一。其运作原理类似于查字典:通过索引定位页面位置直接读取,避免了全表扫描(即逐页翻找)带来的巨大时间成本。在数据量较大时,合理的索引构建能让 SQL 查询性能提升数个数量级。
尽管现代服务器广泛使用固态硬盘(SSD),其随机读写性能远优于机械硬盘,但这并不意味着可以忽视索引优化。磁盘介质的改变仅降低了无序索引带来的惩罚程度,而索引减少 IO 次数的根本原则在任何存储介质下依然适用。
InnoDB 的 B+Tree 索引结构解析
InnoDB 作为默认的存储引擎,采用可插拔设计。其索引建立在存储引擎层,而非服务器层,这意味着不同存储引擎可能采用完全不同的索引方案。本文将聚焦于 InnoDB 中广泛应用的 B+Tree 索引结构。
B+Tree 与 B-Tree 的核心差异
为了便于理解,假设存在一张包含 username、age 等字段的表,并建立联合索引后,数据在磁盘上的物理存储表现为多路平衡查找树。B+Tree 相较于 B-Tree 具有显著的工程优势:
- 非叶子节点只存索引: B+Tree 的非叶子节点不保存指向具体数据的指针,仅保存关键字索引和子节点地址。这使得单个磁盘页(Page)能容纳更多的键值,从而降低树的总高度,减少 I/O 次数。查询所有数据时,B+Tree 只需到达叶子节点即可。
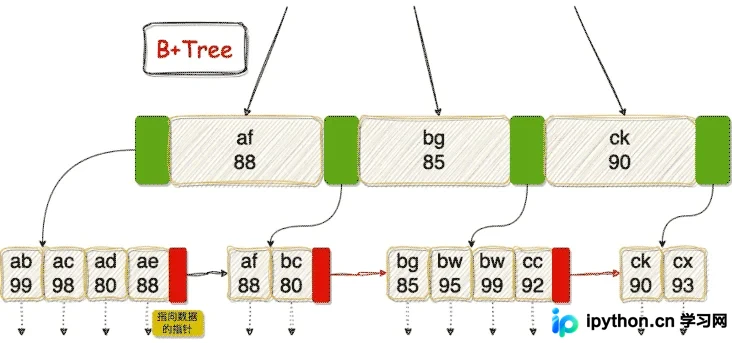
- 叶子节点链表连接: B+Tree 的叶子节点之间通过指针相互连接(如左边叶子指向右边叶子)。这极大地优化了范围查询(Range Query),例如查找 'ac' 到 'bc' 之间的记录,找到起点后顺藤摸瓜即可,无需像 B-Tree 那样在不同分支间回溯。
- IO 稳定性: 由于 B+Tree 所有关键数据都在叶子节点,无论目标数据在哪里,查询路径长度一致,I/O 代价稳定;而 B-Tree 可能在分支节点命中,导致查询效率波动。
- 遍历优势: InnoDB 进行全表扫描或范围遍历时,直接顺序遍历叶子节点链表即可,效率极高。
- 回表机制: 在 InnoDB 中,非聚簇索引(二级索引)的叶子节点存储的是对应记录的主键值。若查询条件未覆盖索引,需根据主键去聚簇索引中查找完整记录,此过程称为“回表”。
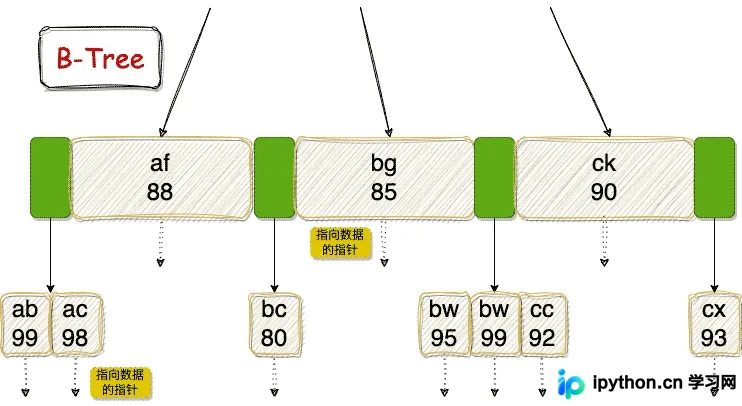
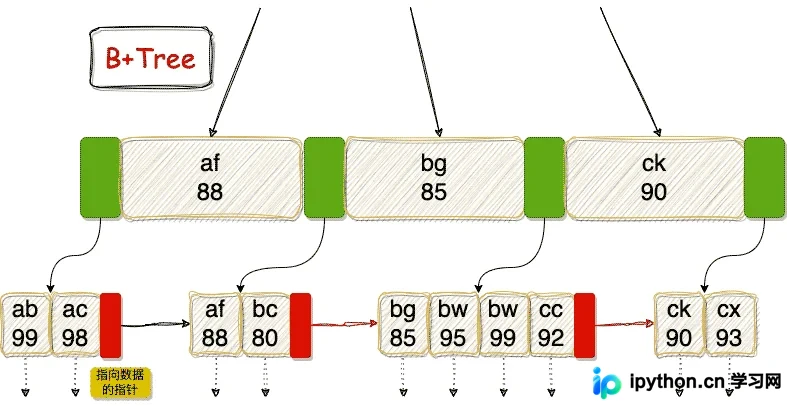
在搜索过程中,数据就像被链表串联并按多路平衡树组织。利用根节点二分查找可以快速锁定目标区间,远比线性扫描链表高效。
树高与数据量估算
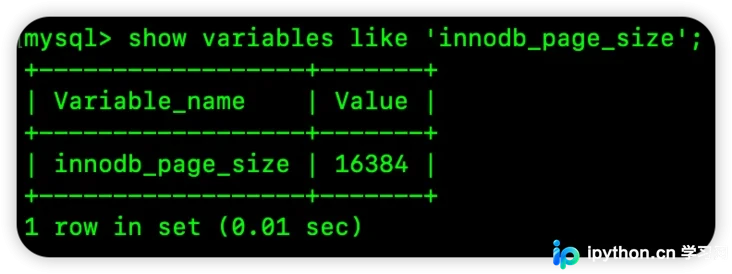
InnoDB 操作磁盘的最小单位是逻辑页(默认 16KB)。每次 I/O 操作将至少 16KB 的数据加载到内存。这一特性决定了树高的计算公式。
1. 验证页大小
可以通过以下命令查看当前实例的逻辑页大小配置:
2. 容量与高度推算
假设每条记录大小为 1KB,一个 16KB 的叶子节点大约可以存放 16/1 = 16 条数据。在非叶子节点中,每个条目主要存储主键值(以 bigint 为例占 8 字节)和指向子节点的指针(6 字节),加上少量的内部开销,我们估算一个节点可指向的子节点数约为:16 * 1024 / (8 + 6) ≈ 1170。
基于此推演三层 B+Tree 的容量:
1170(第二层节点数) × 1170(第三层节点数) × 16(每叶节点行数) ≈ 2190 万行
由此可见,典型的三至四层 B+Tree 即可支撑千万级别数据的检索。由于每次页查找代表一次 I/O,通过主键索引查询一条记录,最多只需要 2 到 4 次 I/O,这体现了极高的效率。
索引生效的查询场景
并不是所有查询都能充分利用索引,以下几种常见模式能有效匹配 B+Tree 结构:
- 全值匹配: 精确匹配联合索引中的所有列(如 `username='ab' AND age=99`),可直接定位。
- 最左前缀匹配: 对于联合索引,只匹配最左侧的列即可触发索引(如只查 `username`)。
- 前缀匹配: 针对字符串字段使用前缀模糊搜索(如 `LIKE 'a%'`)可以使用索引。
- 范围匹配: 搜索某个范围内的数据(如 `age BETWEEN 80 AND 90`)。找到范围内起始点后,顺着叶子节点链表扫描结束。
- 前等后范混合: 如果前面的列是等值匹配,后面的列可以进行范围匹配。因为等值匹配锁定了前缀,子节点按后续列排序的特性得以保留(如 `username='bw' AND age >= 90`)。
- 覆盖索引: 如果查询所需的列全部包含在索引树中,则不需要回表,直接从索引节点获取结果。
索引使用的限制与误区
在使用联合索引时需特别注意以下约束:
- 跳跃列无效: 跳过索引前列直接使用后面列会导致失效。例如联合索引 `(username, age)` 仅按 `age` 查询无法使用索引,因为在该树下 age 是无序的。
- 右侧范围失效: 如果中间列出现范围查询,其右侧的列将无法再通过索引直接定位。例如 `where username like 'a%' and age=99`,虽然 `username` 能用上索引,但因为前缀范围筛选出的结果中 `age` 不再有序,所以 `age=99` 只能在回表或执行索引下推(ICP)时过滤,而不能直接作为 B+Tree 的导航条件。
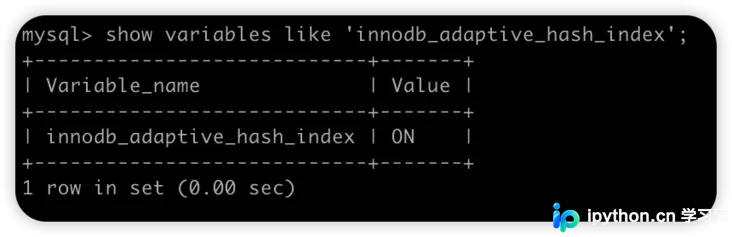
自适应哈希索引(AHI)
InnoDB 除了标准的 B+Tree 外,还内置了自适应哈希索引(Adaptive Hash Index)。虽然传统的 Hash 索引在 InnoDB 中需显式声明,但 AHI 是全自动运作的。当系统监控发现某些索引值的访问频率异常高时,它会自动在现有的 B+Tree 之上构建 Hash 映射,利用 O(1) 的查找复杂度加速热点数据的访问,完全无需人工干预。
总结
合理使用索引能够显著减少服务器的数据扫描量,避免不必要的排序与临时表操作,并将随机的 I/O 转化为顺序 I/O。深刻理解 B+Tree 的数据分布规律及其在 I/O 层面的表现,是进行深层 SQL 优化的基石。
以上就是MySQL索引数据结构入门详细教程的详细内容,更多关于MySQL索引数据结构的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









