

MySQL 索引合并原理解析:Intersection、Union 及性能优化策略
本文详细解析MySQL索引合并机制,涵盖Intersection(交集)、Union(并集)及Sort-Union三种类型。重点说明在等值匹配、主键范围过滤下的适用条件,对比单索引回表与多索引合并的成本差异,并提供通过联合索引替代索引合并以提升查询性能的优化建议。
2026-10-15
7

本文详细解析MySQL索引合并机制,涵盖Intersection(交集)、Union(并集)及Sort-Union三种类型。重点说明在等值匹配、主键范围过滤下的适用条件,对比单索引回表与多索引合并的成本差异,并提供通过联合索引替代索引合并以提升查询性能的优化建议。
本文深入解析MySQL InnoDB引擎中死锁产生的核心机制,重点剖析因加锁顺序不一致、GAP锁范围冲突等典型场景。通过具体案例说明如何复现死锁,并提供使用`INSERT ... ON DUPLICATE KEY UPDATE`、统一加锁顺序等实用的预防与解决方案。
本文详解如何通过MySQL自带的慢查询日志功能定位执行缓慢的SQL语句。涵盖启用日志、设置阈值(long_query_time)、查看日志文件及解析关键字段的方法,并补充了pt-query-digest等高效分析工具的使用场景,帮助DBA快速识别并优化数据库性能瓶颈。
本文介绍SQL Server ErrorLog文件的存储机制与管理方法。默认保留7个日志文件,可通过DBCC ERRORLOG或sp_cycle_errorlog存储过程手动循环日志以释放空间。文章详述了日志轮转原理及操作风险,强调旧数据覆盖前需做好备份,并提供了相关的系统表查询与事务日志压缩的通用处理方法。
介绍两种核心MySQL数据恢复方法:一是基于表结构的.ibd文件导入,适用于磁盘文件损坏但保留数据和结构文件的场景;二是利用Binlog日志进行精确时间点的回滚或重放,用于修复误删、误改等逻辑错误操作。本文详述前提条件、具体命令及参数说明,并提供Windows与Linux下的操作指引。
在MySQL数据库中,NULL值不等于任何具体数值,使用等号或不等号查询往往无法得到预期结果。本文结合Navicat环境,详解如何使用IS NULL和IS NOT NULL精确筛选数据,并指出开发中常见的“不等于”漏查NULL的坑,提供完整的排查思路与解决方案。
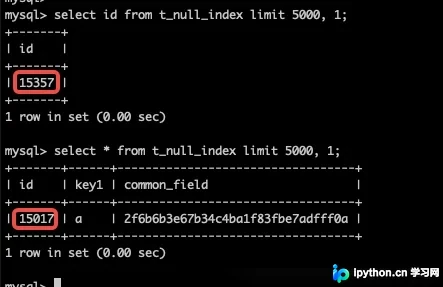
本文深入解析MySQL中LIMIT的执行过程。通过对比`SELECT id`走索引覆盖与`SELECT *`全表扫描的差异,揭示了因Server层截断记录导致的回表成本差异。同时解释了为何看似相同的ORDER BY + LIMIT语句会返回不同的结果集,核心在于隐式排序规则(主键)与显式排序规则(二级索引+主键)的一致性。
本文通过转账案例深入解析 MySQL 事务机制,阐述如何利用 START TRANSACTION、COMMIT 和 ROLLBACK 保证数据原子性与一致性。详细说明事务的 ACID 特性及 Undo/Redo Log 的作用,并对比脏读、幻读等并发异常,指导用户根据业务场景选择合适的隔离级别以平衡性能与数据安全。
在MySQL中避免插入重复记录,除了使用唯一索引外,还可以利用 INSERT ... SELECT WHERE NOT EXISTS 语句实现条件插入。该方法通过子查询检查主键或特定字段是否已存在,仅当记录不存在时执行插入操作,适用于单条及批量数据的去重处理,有效保障数据完整性。
MySQL查询缓慢通常源于数据扫描量大、执行计划不佳或缺少索引。通过避免SELECT *,利用索引覆盖扫描减少回表,并结合EXPLAIN分析扫描行数与Extra列指标,可显著降低服务器开销并提升查询速度。
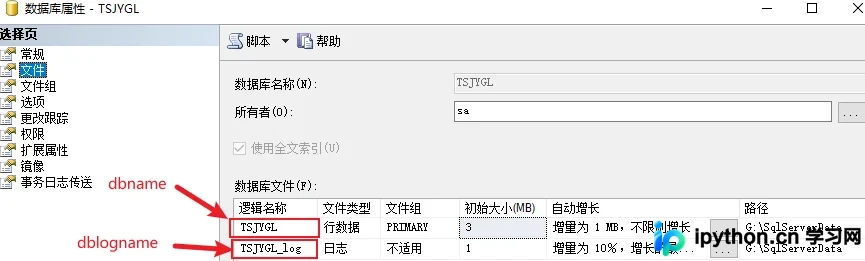
针对 SQL Server 日志文件 (.ldf) 占用过大磁盘空间的问题,本文提供通过修改数据库恢复模式并执行 DBCC SHRINKFILE 命令来释放未使用空间的详细方法。操作需切换至简单模式截断日志,收缩后再恢复完整模式,以兼顾空间回收与数据安全。
本文详细讲解 MySQL 命令行的进入与退出方法,提供 Linux/Mac 下服务启停命令。涵盖创建/删除库表、导入 SQL 文件及增删改查等核心基础操作。同时包含基于 GRANT 语句的用户权限分配示例及密码策略注意事项,帮助初学者快速掌握终端数据库管理技巧。