

MySQL DQL数据查询语言全解:从基础到高阶操作
本文详细解析MySQL数据查询语言(DQL),涵盖基本查询、别名与去重、运算符比较、排序、聚合函数(COUNT/SUM/AVG)、分组及Having筛选、分页Limit,以及正则表达式匹配。通过商品表与学生表的实例,深入讲解SQL执行顺序、WHERE与HAVING的区别及复杂逻辑处理,提供可复用的代码模板与分析思路。
2026-10-16
8

本文详细解析MySQL数据查询语言(DQL),涵盖基本查询、别名与去重、运算符比较、排序、聚合函数(COUNT/SUM/AVG)、分组及Having筛选、分页Limit,以及正则表达式匹配。通过商品表与学生表的实例,深入讲解SQL执行顺序、WHERE与HAVING的区别及复杂逻辑处理,提供可复用的代码模板与分析思路。
使用MySQL命令行还原phpMyAdmin导出的含有中文的SQL文件时,常因字符集不匹配导致乱码。关键在于通过文本编辑器确认文件实际编码,并在执行导入前设置正确的 `set names` 参数。本文详细演示如何避免编码误区,确保中文数据完整导入。
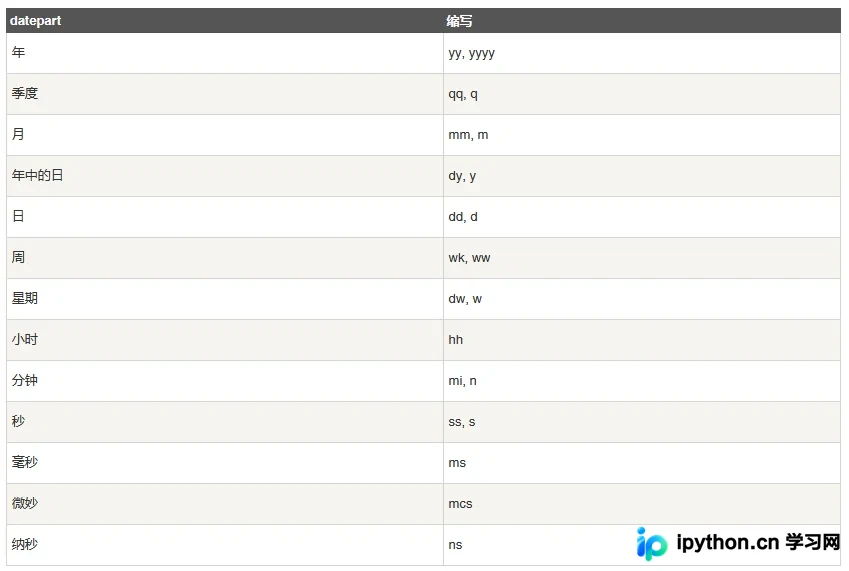
本文详细解析SQL Server中的DATEDIFF函数,用于计算两个日期之间的差值。文章介绍了DATEDIFF(datepart, startdate, enddate)的标准语法,重点列举了常见的datepart参数(如dd天数、hh小时、mi分钟)及其具体取值含义,并通过多个实战代码示例展示了如何在不同精度下计算时间间隔,帮助开发者快速掌握T-SQL日期处理技巧。
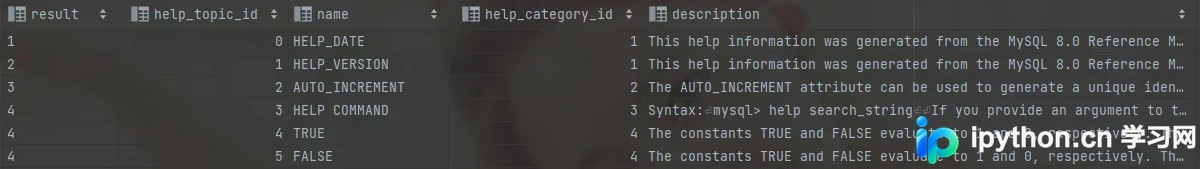
本文介绍在MySQL中如何将单行包含逗号分隔值的字段高效拆分为多行记录。核心方案是利用mysql.help_topic表结合SUBSTRING_INDEX函数实现,并提供无权限时的临时表替代方案及函数参数解析,适用于数据清洗与格式转换场景。
本文详解SQL Server中行列互转的两种核心场景。行转列推荐使用PIVOT操作或动态CASE WHEN聚合,适用于将多行记录合并为单行宽表;列转行推荐使用UNPIVOT或UNION ALL拼接,适用于将宽表数据还原为长表格式。文章提供从SQL Server 2000到2005+版本的动态SQL生成逻辑及静态示例,涵盖静态列、动态列及聚合统计(如总和)的实现细节。
本文介绍 SQL Server 中删除数据库重复记录的四种常用方法。涵盖基于 Cursor 游标的动态删除、全字段去重的临时表法,以及部分字段重复记录的分组处理。针对常见需求(保留最新或最早记录)提供具体 T-SQL 代码操作,帮助用户高效清理脏数据并确保业务逻辑正确性。
本文详细梳理了MySQL数据库的23项关键安全与配置注意事项。涵盖从网络连接加密、防火墙策略到密码强度设置,再到防止SQL注入、精细化的权限控制及启动参数优化。通过规范的用户管理、数据备份及异常处理机制,帮助开发者与管理员构建更安全、稳定的数据库环境。
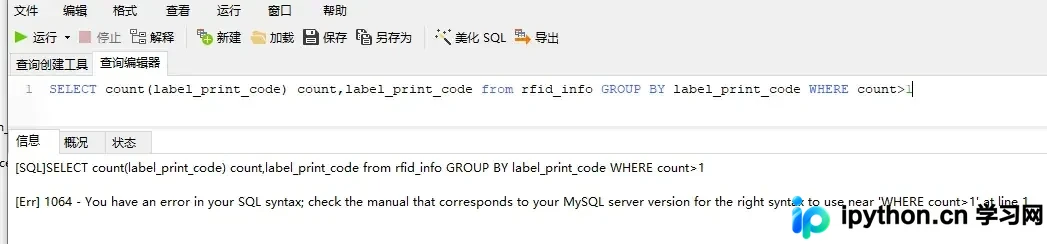
在生产环境中遇到数据重复(如标签重复)时,可利用MySQL的GROUP BY和HAVING语句快速定位问题。本文通过实际案例,演示如何编写SQL查询提取重复记录,结合临时表进行数量统计与频次占比分析,并详细解析WHERE与HAVING的区别,帮助开发者高效排查数据库异常。
本文介绍在Linux系统中如何利用crontab实现MySQL数据库的定时自动备份。通过编写自定义Shell脚本并结合系统定时任务,可每日自动执行数据库导出或文件打包操作,确保数据安全并便于按日期归档管理。
本文详解SQL Server中两种常用的表数据复制语句:INSERT INTO SELECT和SELECT INTO。前者需目标表已存在,支持指定列或全部列复制;后者自动创建目标表,但要求目标表不存在且通常只能执行一次。通过具体代码案例对比两者优先级、适用场景及语法细节,帮助开发者高效进行数据备份与迁移。
本文详细介绍MySQL中LOCATE和POSITION函数的用法,涵盖基本语法、参数说明及大小写敏感特性。通过具体SQL示例演示如何查找子串首次出现位置及指定起始位置后的索引,帮助开发者高效处理字符串匹配查询任务。
本文详解MySQL中非空约束(NOT NULL)的用法。通过具体案例演示如何在创建表时定义非空字段,如何修改现有表添加或移除非空约束,并提供完整的SQL语句及运行结果参考,帮助用户规范数据库设计。