

Python数据分析基础:Jupyter、NumPy与SciPy稀疏矩阵及Matplotlib入门
本文介绍Python数据分析的核心工具链。首先讲解Jupyter Notebook的基本操作与帮助获取方法;随后深入NumPy数组的创建、索引及形状变换;接着详解SciPy稀疏矩阵(CSR/LIL)在机器学习中的高效存储与格式转换;最后演示Matplotlib在Jupyter中的内联绘图及多种图表类型,为机器学习预处理提供基础支持。
2026-10-14
6

本文介绍Python数据分析的核心工具链。首先讲解Jupyter Notebook的基本操作与帮助获取方法;随后深入NumPy数组的创建、索引及形状变换;接着详解SciPy稀疏矩阵(CSR/LIL)在机器学习中的高效存储与格式转换;最后演示Matplotlib在Jupyter中的内联绘图及多种图表类型,为机器学习预处理提供基础支持。
本文深入解析 Python Scipy 库中 stats 模块的正态分布应用,重点讲解 stats.norm.cdf 与 stats.norm.pdf 两个核心函数的语法、参数及实际代码示例。同时梳理 Scipy 主要子模块功能,帮助开发者快速掌握统计计算与数据处理技巧。
本文详解Python中利用scipy.stats模块生成指定概率分布随机数的方法。重点讲解norm.rvs函数的loc和scale参数对期望与标准差的设定,以及size参数控制数组形状。通过具体代码实例展示如何生成正态分布等随机数,适用于统计分析场景。
本文介绍利用Python将图片文件读取为矩阵数据,以及将矩阵数据保存为图片文件的具体实现方法。通过示例代码展示了使用matplotlib读取图像和scipy保存图像的操作流程,为图像处理相关开发提供参考。
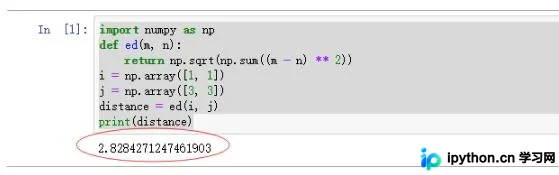
本文介绍在Python中使用Numpy计算两个向量之间欧氏距离的两种方法:通过平方和开方手动计算,以及利用numpy.linalg.norm直接求解。此外,还展示了如何定义函数计算单个点到数据集中所有点的距离总和,并提供了基于Scipy和Pyplot的可视化示例代码。
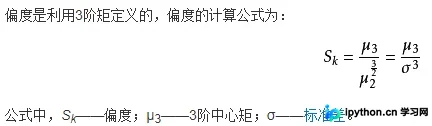
本文详细介绍在Python中使用scipy库进行数据正态性检验的多种方法。涵盖Shapiro-Wilk检验(适用于小样本)、K-S检验、normaltest、Anderson-Darling检验以及偏度和峰度检验。通过具体函数定义、参数说明及代码示例,帮助开发者掌握如何判断数据是否符合正态分布,为T检验等统计分析奠定基础。
本文介绍Python中scipy.stats库处理连续与离散分布的核心方法。涵盖随机变量生成(rvs)、概率密度(pdf/cdf)、生存函数(sf)及分位点函数(ppf/isf)的使用,并解析stats与moment参数计算。通过正态分布实例演示参数估计与期望值计算,帮助开发者掌握统计分布的基础操作。
本文介绍如何使用SciPy库中的optimize.minimize函数解决带有复杂约束条件的样本抽样问题。通过构建以KL散度为目标的优化函数,并设置参数初始值、边界及等式/不等式约束,实现从多类别样本中抽取符合特定分布比例的数据集。文章详细解析了关键参数设置、算法选择及常见收敛问题的处理方法。
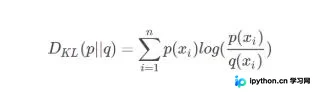
本文详解Python中scipy.stats库的核心用法,涵盖正态分布随机数生成、概率密度函数(pdf)、累计分布函数(cdf)及分位点函数(ppf)的具体实现。通过代码示例解析loc与scale参数对分布的影响,并梳理常见连续与离散分布的调用方法,为数据科学中的统计分析提供实用参考。
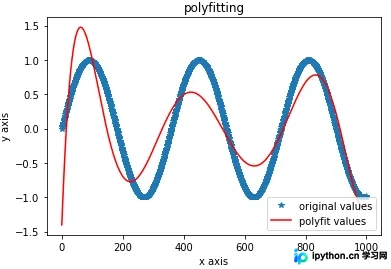
本文介绍在Python中计算波峰波谷值(极值点)的四种常用方法。通过scipy库的find_peaks检测极大值,利用np.polyder求导寻找导数为零的点,以及使用argrelextrema直接获取极大极小值索引。结合np.polyfit进行数据拟合,可灵活处理不同场景下的极值点定位需求。
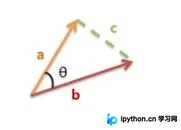
本文详细介绍在Python中计算向量相似度的两种核心方法:夹角余弦与皮尔逊相关系数。通过具体代码示例,展示如何利用NumPy和SciPy库实现这两种算法,并深入解析它们在平移不变性、尺度不变性及方向相关性上的区别与适用场景。
本文系统介绍Python SciPy库中optimize模块的核心用法。涵盖非线性方程组求解(fsolve)、最小二乘拟合(leastsq与curve_fit)、局部极小值算法(Nelder-Mead等)及全局优化策略(basinhopping)。通过具体代码示例解析参数传递、雅可比矩阵加速及初始值敏感性等关键问题,为数据拟合与数值优化提供实用参考。