

利用SciPy optimize.minimize实现带约束的样本抽样优化

本文介绍如何使用SciPy库中的optimize.minimize函数解决带有复杂约束条件的样本抽样问题。通过构建以KL散度为目标的优化函数,并设置参数初始值、边界及等式/不等式约束,实现从多类别样本中抽取符合特定分布比例的数据集。文章详细解析了关键参数设置、算法选择及常见收敛问题的处理方法。
受限优化问题描述
问题场景涉及一组包含多个固定标签属性的样本数据,例如(性别:男/女,年龄:24岁,地点:上海)。目标是从这批样本中抽取一个子集,使得该子集的标签分布严格满足预设的目标分布P(x)。具体而言,需要确保抽取后的样本中,各项特征的比例符合预期,如男女比例为49%:51%,年龄段20岁与30岁的比例为9%:11%等。
KL散度作为优化目标
在优化过程中,选用KL散度(Kullback-Leibler Divergence)作为目标函数,旨在最小化抽样分布与目标分布之间的差异。
KL散度,亦称为相对熵,是衡量两个概率分布差异的重要指标。
在机器学习语境下,P通常代表样本的真实分布,例如向量[1,0,0]表示样本属于第一类;而Q代表模型预测或抽样的分布,例如[0.7,0.2,0.1]。
直观理解上,若使用P来描述样本,则分布完美契合;若使用Q描述,虽能大致近似,但信息量不足,需额外的“信息增量”才能与P达到同等完美程度。若通过反复训练使Q能完美描述样本,则无需额外信息增量,此时Q等价于P。
KL散度的数学公式如下:
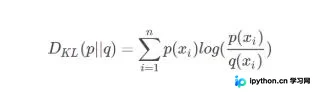
SciPy optimize.minimize参数详解
借助SciPy库中的optimize.minimize模块执行优化计算。
def minimize(fun, x0, args=(), method=None, jac=None, hess=None,
    hessp=None, bounds=None, constraints=(), tol=None,
    callback=None, options=None):
调用该函数时需关注几个核心参数:
fun:定义需要最小化的目标函数(the objective function to be minimized);
x0:参数的初始猜测值,形式为包含实数元素的数组,尺寸为(n,)(Initial guess. Array of real elements of size (n,));
bounds:针对L-BFGS-B、TNC、SLSQP和trust-constr方法,设定变量的取值范围限制(Bounds on variables for L-BFGS-B, TNC, SLSQP and trust-constr methods.);
constraints:定义约束条件,仅适用于COBYLA、SLSQP和trust-constr方法(Constraints definition (only for COBYLA, SLSQP and trust-constr));
Constraints for COBYLA, SLSQP are defined as a list of dictionaries.
Each dictionary with fields:

 type : str
  Constraint type: 'eq' for equality, 'ineq' for inequality.
 fun : callable
  The function defining the constraint.
 jac : callable, optional
  The Jacobian of `fun` (only for SLSQP).
 args : sequence, optional
  Extra arguments to be passed to the function and Jacobian.
)
tol:目标函数的误差容忍度,用于控制迭代终止条件(optional Tolerance for termination. For detailed control, use solver-specific options.);options:其他可选参数,是一个字典,包含所有方法通用的选项(dict, optional A dictionary of solver options. All methods accept the following generic options:)
求解过程与代码实现
具体的求解流程如下:
首先定义优化目标函数。
在定义的obj_function(x)中,x为待优化的变量向量。在本案例中,样本分为480个类别(如:男、24岁、上海等组合),每类样本数量在10到1000个之间不等。x代表从每一类中抽取的比例。目标是抽取总计50000个样本,同时满足22个约束条件,例如男女比例50%:50%,年龄20岁与30岁的比例9%:11%等。
以男性需占总样本50%为例,其约束表达式为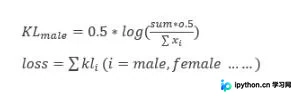 。
选择合适的优化算法。SciPy中支持bounds参数的算法包括L-BFGS-B、TNC、SLSQP和trust-constr;支持constraints参数的算法包括COBYLA、SLSQP和trust-constr。
参数调整方面,optimize.minimize提供统一接口,但不同优化算法拥有各自特有的参数,具体列表需参考源码文档。
执行优化:res = optimize.minimize(sample_fun, np.array(x0), bounds=bound, method='L-BFGS-B', tol=1e-11, options={'disp': True, 'maxiter': 300, 'maxfun': 1500000})。最终优化结果存储在res.x中。
常见收敛问题处理
若程序未达到指定迭代次数便提前停止,可能由以下两种原因导致:
错误提示:STOP: TOTAL NO. of f AND g EVALUATIONS EXCEEDS LIMIT。解决方法是增大maxfun参数;
错误提示:CONVERGENCE: REL_REDUCTION_OF_F_<=_FACTR*EPSMCH。解决方法是调小tol参数。
以上关于利用SciPy中optimize.minimize实现受限优化问题的介绍即为全部内容,希望能对读者有所帮助,也欢迎大家继续支持相关技术社区。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









