Python Requests模块基础:怎么实现HTTP数据抓取自动化
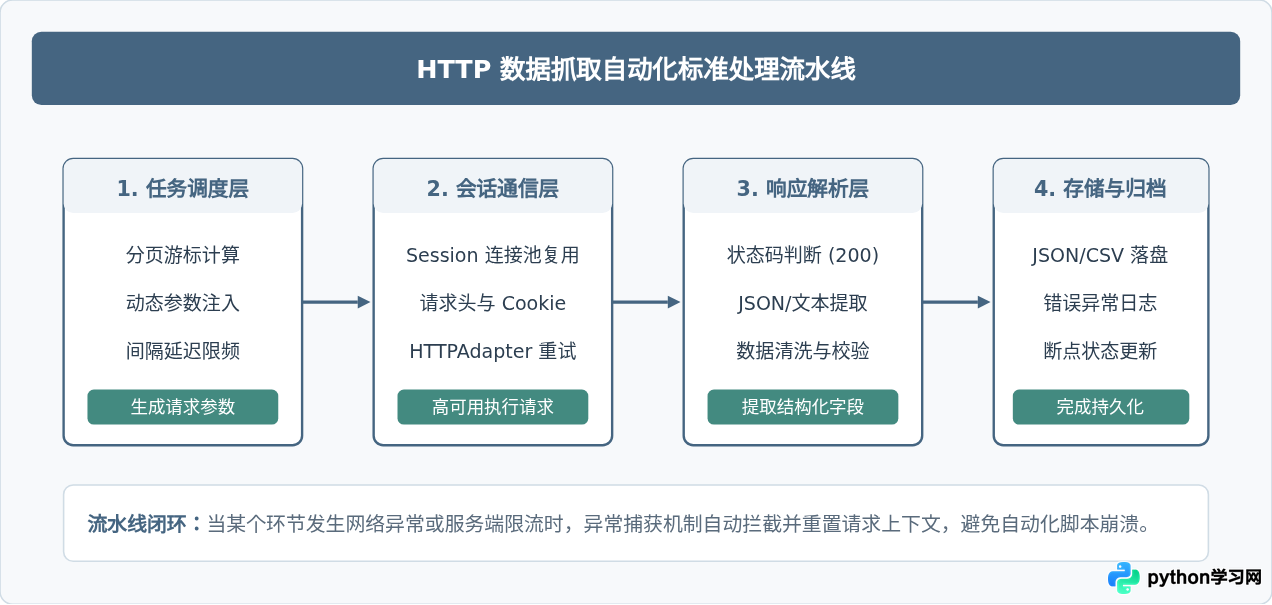
系统介绍如何使用Python Requests模块构建高可用的HTTP数据抓取自动化流程,涵盖请求参数配置、Session会话保持、超时防御、自动重试机制与数据解析落盘实战。
2026-10-29
40


系统介绍如何使用Python Requests模块构建高可用的HTTP数据抓取自动化流程,涵盖请求参数配置、Session会话保持、超时防御、自动重试机制与数据解析落盘实战。
本文详细介绍Python中requests模块的安装、导入及核心用法。涵盖GET与POST请求的参数传递方式,包括application/x-www-form-urlencoded、application/json及multipart/form-data三种常见格式,并提供封装返回JSON数据模块的示例代码,适用于接口自动化测试场景。
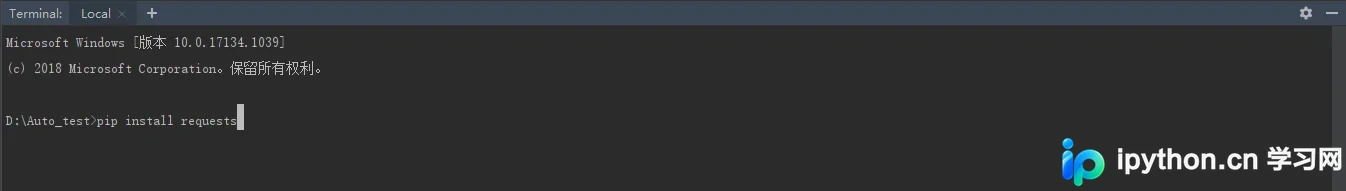
本文介绍Python中广泛使用的HTTP库requests。它基于Apache2许可证,旨在提供比标准库urllib2更简洁、人性化的API。文章涵盖通过pip或easy_install安装requests的方法,并演示了GET、POST等常见HTTP请求类型、参数传递、响应处理、编码设置及代理配置等核心功能,帮助开发者快速上手网络请求开发。
本文详解如何在Python3中利用requests模块实现文件下载进度的实时显示。通过设置stream参数启用流式传输,结合Response.iter_content分块读取数据,并自定义ProgressBar类利用\r控制光标刷新,从而在控制台输出美观的下载进度条。
本文详细介绍如何在Python中使用requests模块发起HTTP请求。涵盖GET和POST两种常用方法,演示如何导入模块、选择请求方式及处理响应报文。通过百度访问示例说明HTML解析与编码设置,通过登录接口示例讲解字典参数传递与JSON响应处理,并展示如何获取响应头、编码格式及状态码等关键信息。
本文介绍Python爬虫的基础流程,包括指定URL、发送请求及数据存储三步。详细讲解requests外部库的安装方法,并通过完整代码示例演示如何爬取搜狗首页并保存为HTML文件,帮助初学者快速掌握网络数据抓取的基本操作。
本文介绍Python3中requests库的基本特性及其在模拟浏览器行为中的应用。通过具体代码示例,详细讲解如何配置User-Agent、代理服务器及处理HTTP请求,帮助开发者实现更灵活的网络数据抓取与交互操作。