

Python3 使用 requests 库发送携带账号密码的 POST 请求
本文介绍如何在Python3中利用requests库发送POST请求并携带账号密码数据。通过构建URL、headers及data参数,演示如何发起请求并获取响应内容。若请求失败,通常需排查跨域问题或检查参数格式是否正确。
2026-10-13
6

本文介绍如何在Python3中利用requests库发送POST请求并携带账号密码数据。通过构建URL、headers及data参数,演示如何发起请求并获取响应内容。若请求失败,通常需排查跨域问题或检查参数格式是否正确。
本文详细介绍使用Python抓取豆瓣影评数据的两种方法。首先通过PC端网页分析URL参数,利用Requests和BeautifulSoup解析HTML并递归获取评论;随后介绍更高效的移动端模拟策略,通过修改User-Agent直接调用豆瓣移动端API接口获取JSON数据,简化解析流程并提高抓取效率。
本文详解Python爬虫中设置代理IP的方法,解决高频访问导致的封禁问题。通过requests和bs4库从西刺代理获取免费IP列表,构建随机代理字典,并演示如何在get请求中应用。针对反爬机制提供定时抓取建议,帮助开发者有效规避IP封锁风险。
本文介绍了使用Python3和requests库判断URL链接是否返回404状态码的方法。通过发送HEAD请求获取状态码,结合pymysql数据库操作,自动更新标记字段。代码展示了完整的查询、判断及更新流程,供开发者参考。
本文介绍在Python中验证代理IP可用性的几种方法。通过urllib2构建代理 opener、使用requests库简化代码,以及利用telnetlib进行端口连通性测试。重点解析如何判断代理是否有效,并将可用IP存入Redis以便后续爬虫调用,帮助解决IP被封问题。
本文提供使用Python爬取哈尔滨天气信息的完整代码示例。环境基于Windows7与Python3.4,需安装requests和BeautifulSoup4库。文章详细解析了open函数的file、mode、buffering、encoding、errors及newline等参数用法,并附带可执行的爬虫代码,涵盖获取HTML、解析数据及写入CSV文件的全过程,适合Python初学者参考学习。
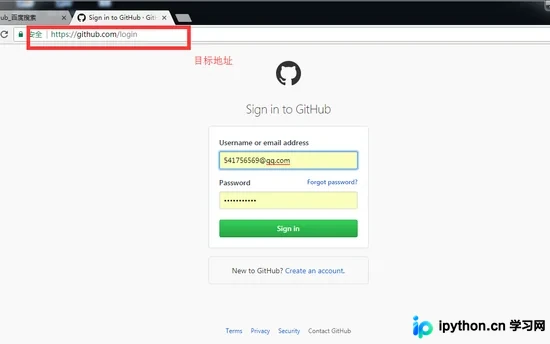
本文详细解析使用Python爬虫登录GitHub的技术流程。通过分析登录页面,提取CSRF Token与初始Cookie,利用Requests库发送GET请求获取必要参数,随后构造POST请求提交用户名和密码完成身份验证。最后演示如何携带登录后的Cookie访问个人详情页,实现自动化信息查看。
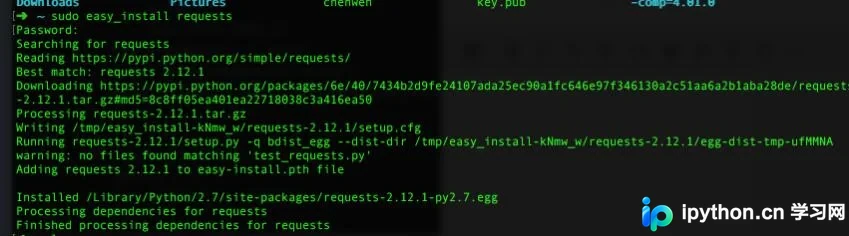
本文介绍在macOS系统中安装Python网络请求库requests的方法。通过执行sudo easy_install requests命令,用户可快速完成安装。安装成功后,即可在Python项目中正常使用requests进行网络请求操作。
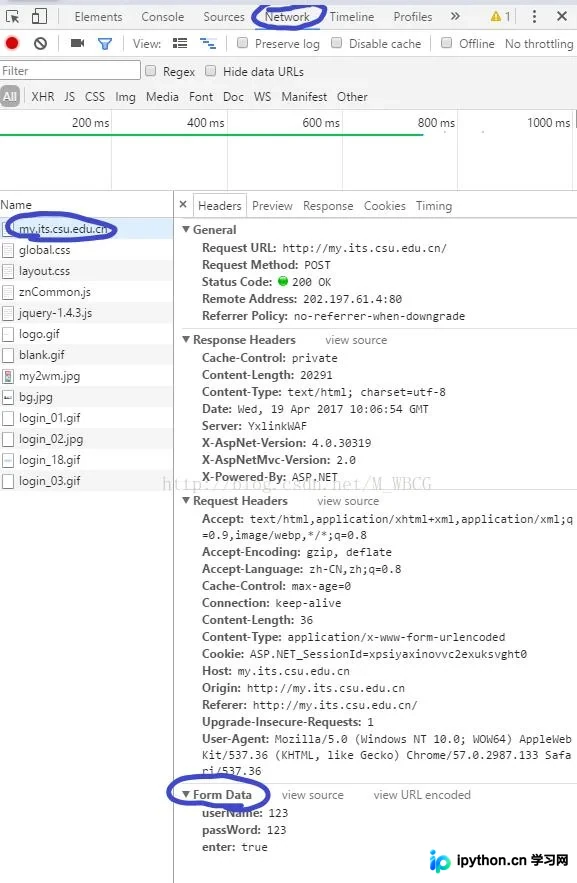
本文详解利用Python进行网站模拟登录的完整流程。通过开发者工具分析Network请求,提取登录所需的隐藏参数,并使用requests库建立Session以维持状态。文章展示了如何获取HTML源码、正则提取数据、提交POST请求以及获取登录后页面内容,提供基础代码参考。
本文介绍如何在Python3中利用requests库结合IP代理池实现随机IP生成。通过从预设代理列表随机选择IP,配置请求头信息,并访问测试网站验证当前IP。该方法适用于需要隐藏真实IP或进行网络爬虫开发的场景,代码简洁实用,可直接参考使用。
本文介绍如何利用Python爬虫技术解决校园网频繁掉线问题。通过Firefox浏览器抓包获取登录接口、参数及Header信息,结合requests库编写自动登录脚本。脚本包含死循环检测网络状态,断网时自动重新提交POST请求,并可打包为exe实现开机自启,无需手动操作。
本文详细介绍如何利用Python的requests库发起接口请求,并结合unittest框架搭建自动化测试体系。通过封装测试用例、使用TestSuite管理测试集,以及自定义统计逻辑,实现对接口返回码、通过/失败数量的自动化统计与报告生成,为接口测试提供完整的解决方案。