Python Pandas中extract与contains方法实战解析
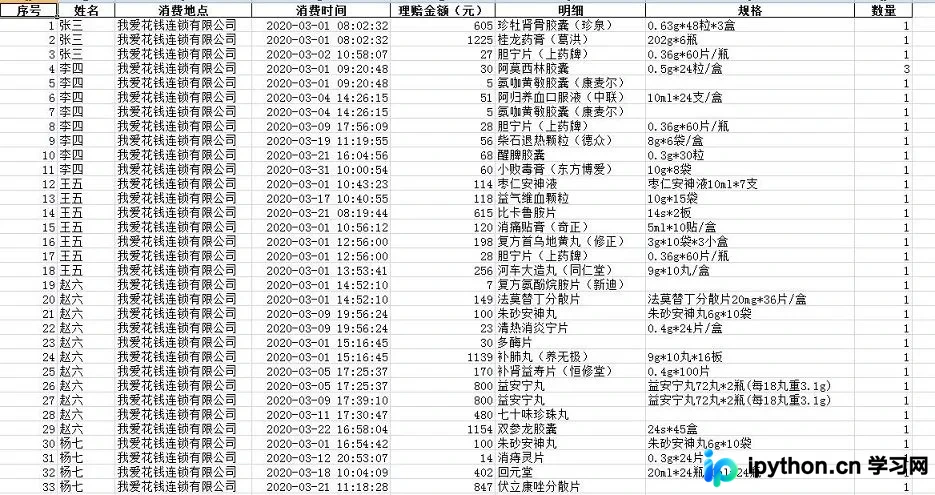
本文详细讲解Python Pandas库中extract和contains两个字符串处理方法的实际应用。通过具体代码案例,演示如何利用extract结合正则表达式从复杂字段中提取明细与规格,以及如何使用contains进行字符串模糊匹配与数据筛选,帮助开发者高效处理DataFrame中的文本数据。
2026-10-14
6

本文详细讲解Python Pandas库中extract和contains两个字符串处理方法的实际应用。通过具体代码案例,演示如何利用extract结合正则表达式从复杂字段中提取明细与规格,以及如何使用contains进行字符串模糊匹配与数据筛选,帮助开发者高效处理DataFrame中的文本数据。
本文深入解析Python中字符串搜索、替换及格式化的常用方法。重点介绍如何使用str.replace()处理简单模式,利用re.sub()结合正则表达式处理复杂文本替换,并通过re.IGNORECASE标志实现忽略大小写的匹配。此外,还涵盖了利用ljust/rjust/center及format()函数进行字符串对齐格式化的具体技巧,帮助开发者高效处理文本数据。
本文详解PHP中正则表达式的贪婪与非贪婪模式。通过`preg_match`实例对比,展示默认贪婪匹配会尽可能多地捕获字符,而添加问号`?`启用非贪婪模式后仅匹配最短符合部分。掌握这一特性可有效优化URL提取、标签解析等场景的正则逻辑。
本文介绍如何使用Python正则表达式自动从非结构化文本中提取时间信息,重点解决dateutil和datefinder模块对中文及特殊格式支持不足的问题。通过自定义正则模式匹配,实现了对中文年月日、相对时间(如“3小时前”)及多种分隔符格式的精准识别,并附带完整测试用例与运行结果分析。
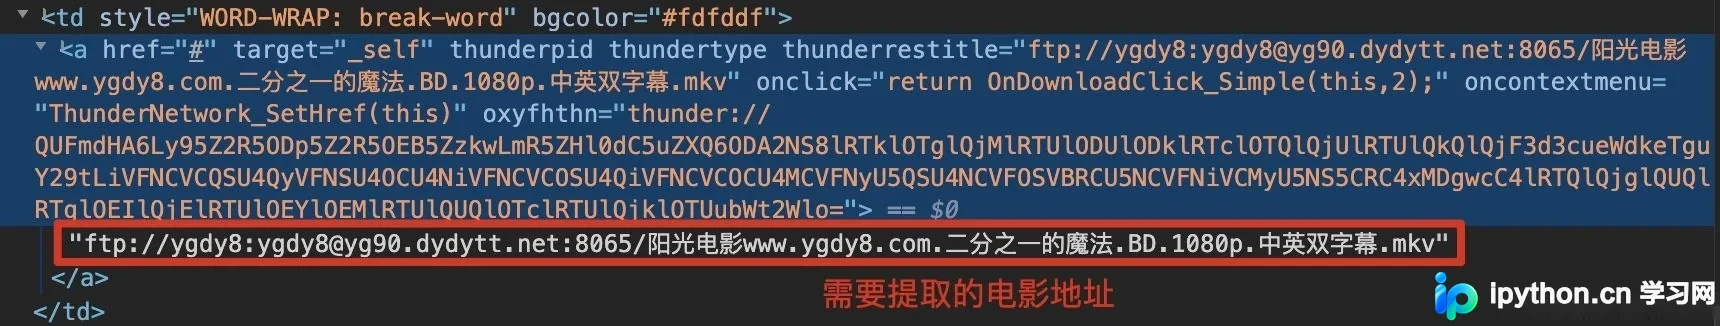
本文介绍如何利用 Python 的 re 和 requests 模块,通过正则表达式从网页 HTML 中快速提取电影 FTP 下载地址。相比繁琐的标签遍历,正则匹配能显著减少代码量并提高提取效率。文章包含完整的代码示例、编码处理技巧及运行结果分析,帮助开发者掌握高效的网页信息抓取方法。
在C# WinForm开发中,限制TextBox仅接收数字输入可提升用户体验。通过绑定KeyPress事件拦截非数字字符,并配合TextChanged事件使用Regex过滤已输入的非法内容,可有效防止粘贴操作引入错误数据,确保数据纯净性。
在PHP开发中,常需从HTML片段中提取特定样式的节点。本文演示如何使用cURL获取数据,并通过正则表达式精准匹配带有特定class的div标签及其内部内容,同时提供更推荐的DOMDocument解析方案以应对复杂HTML结构。
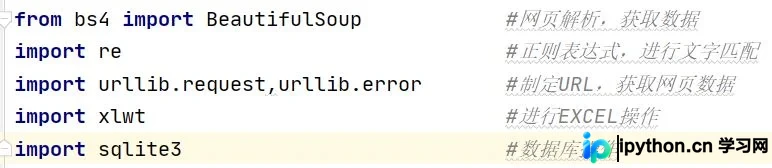
本文详细演示了如何使用Python编写爬虫程序,通过正则表达式和BeautifulSoup解析豆瓣电影Top250网页。文章涵盖了从构建请求头、提取电影链接与名称,到将数据保存为Excel文件和SQLite数据库的完整流程。代码包含完整的函数封装,适合初学者学习网络数据采集与本地存储技术。
本文详解Python中正则表达式的贪婪匹配机制及其导致的错误结果,通过引入问号修饰符将模式转换为非贪婪模式,从而精确获取分隔符间的最短文本。文章提供具体代码示例与原理分析,帮助开发者避免常见匹配陷阱,提升正则处理的准确性。
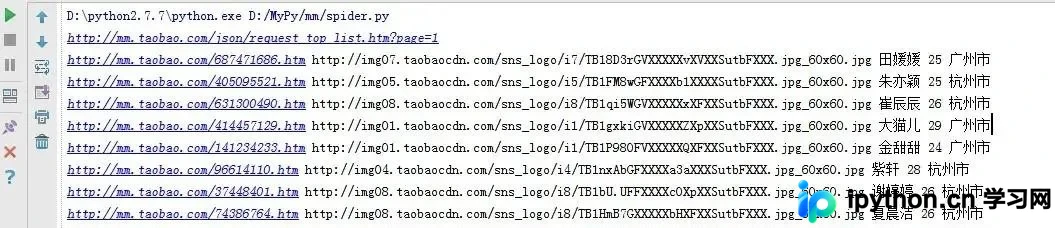
本文详解使用Python编写爬虫抓取淘宝MM首页信息的完整流程。通过解析HTML获取头像、姓名、年龄及详情页链接,利用正则表达式提取数据,并演示如何将图片与个人简介按文件夹保存至本地。代码涵盖页面请求、数据提取、文件创建及写入逻辑,适合Python初学者学习网络爬虫基础操作。
本文详解 Python 中正则表达式处理多行文本的常见陷阱。当使用点号(.)匹配任意字符时,默认无法匹配换行符。文章介绍了两种解决方案:一是通过非捕获组(?:.\n)显式包含换行符;二是利用 re.compile 的 re.DOTALL 标志,使点号能匹配包括换行符在内的所有字符。同时对比了两种方法的适用场景,建议复杂模式优先使用标志位以提高代码可读性和维护性。
本文详细介绍Python抓取指定网页图片的两种核心方法:基于正则表达式匹配URL与基于BeautifulSoup解析HTML标签。通过完整代码示例,演示如何获取网页源码、提取图片链接并保存至本地,同时提供优化建议,如结合两种方法提高抓取效率及添加请求头规避反爬机制。