

Python爬取微博评论实战:从接口分析到代码实现
本文详细讲解使用Python爬取微博评论的完整流程。内容涵盖微博爬虫的难度分级、接口URL构造、HTML标签去除及正则表达式应用,并提供了基于requests和pandas的两种代码实例,帮助开发者掌握从确定用户ID到保存CSV文件的实际操作步骤。
2026-10-15
5

本文详细讲解使用Python爬取微博评论的完整流程。内容涵盖微博爬虫的难度分级、接口URL构造、HTML标签去除及正则表达式应用,并提供了基于requests和pandas的两种代码实例,帮助开发者掌握从确定用户ID到保存CSV文件的实际操作步骤。
本文整理了PHP与JavaScript中常用的正则表达式,涵盖中文、Email、网址、邮编、IP地址及中国大陆身份证号码的匹配规则。提供具体的代码示例,帮助开发者快速实现前端表单验证与后端数据清洗功能。
本文详细汇总了Python下载网络图片的多种方法,涵盖从已知URL直接下载到通过正则表达式和BeautifulSoup解析HTML获取链接的批量处理技巧。针对动态网页和反爬机制,提供了User-Agent模拟、Referer设置、IP池及Cookie管理等解决方案,并介绍了Selenium动态加载与Pyautogui模拟点击等进阶策略,帮助开发者高效完成图片抓取任务。
本文详解如何利用Python抓取微博移动端指定关键词的搜索结果。通过获取Cookie并分析XHR接口,构造请求参数获取数据。重点讲解使用正则表达式提取标题、评论及点赞数,并解决Unicode编码转换问题,提供完整代码示例供学习参考。
在PHP开发中,直接截取包含XML或HTML标签的字符串往往会导致标签闭合错误。本文介绍一种基于复杂正则表达式的PHP函数解决方案,该函数能够智能识别标签结构,在指定长度截断时自动扩展范围以确保结束标签存在,从而保持标记语言的完整性。
本文介绍 JavaScript 中利用 String 和 Array 进行高效数据处理的方法。通过原型链扩展实现字符串重复,使用数组模拟 StringBuilder 优化拼接性能,并利用 split/join 配合 replace 的正则回调功能,实现更简洁、灵活的子串查找、替换及格式化操作。
整理Java开发中常用的正则表达式,涵盖数字、字符、邮箱、电话及身份证等常见场景的验证方法。文章同时提供了JavaScript环境下利用正则限制输入框文本的实操代码,以及IP地址转换算法。文末附带完整的正则表达式元字符与量词符号说明,帮助开发者快速查询与应用。
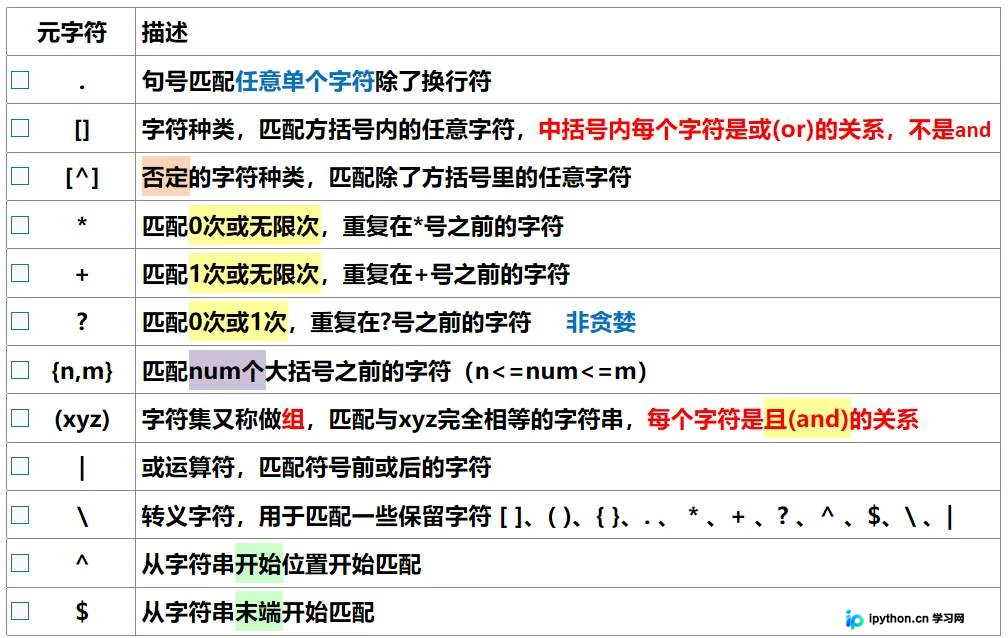
本文详细解析Python中re模块的正则表达式功能,涵盖数量词、字符匹配、边界匹配及分组等核心元字符。深入讲解findall、match、search和compile等关键方法的差异与使用场景,并通过包含大小写处理、贪婪与非贪婪模式、分组提取及字符串替换的完整代码示例,帮助开发者掌握高效的文本处理技巧。
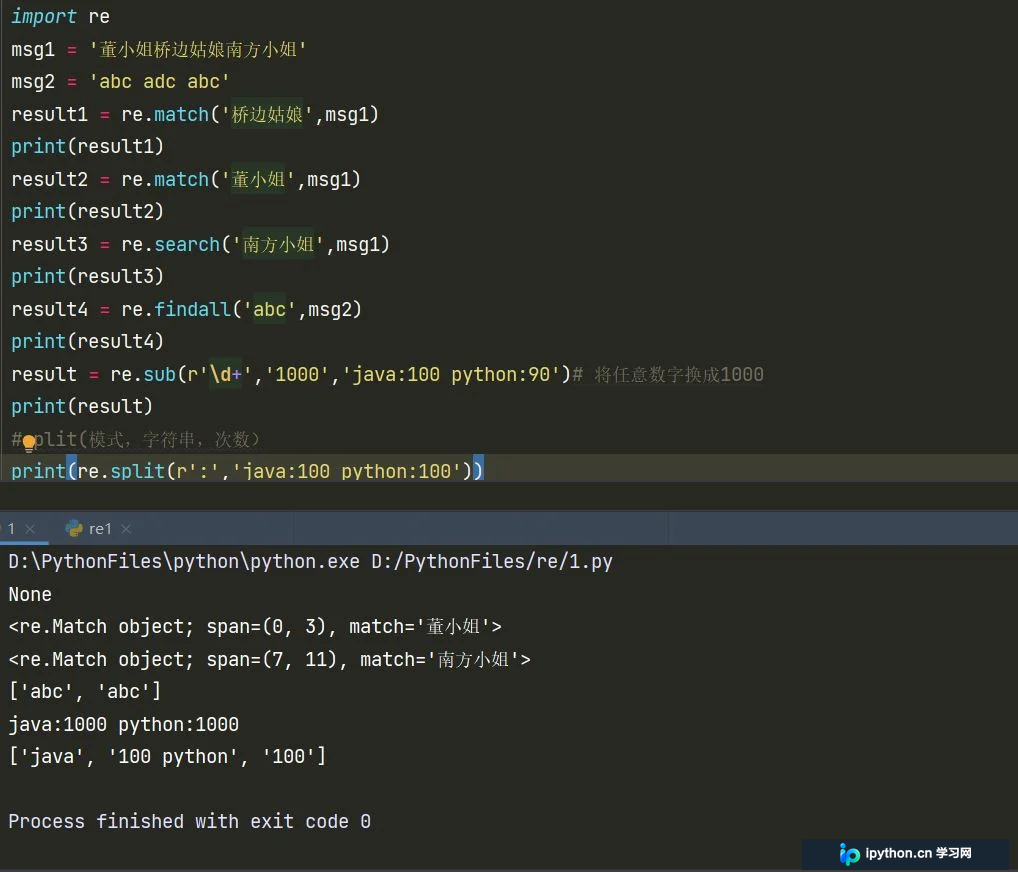
本文详解 Python 中正则表达式的基本概念、匹配原理及常用函数。通过 compile 与 match、search、sub、findall、split 等方法,展示如何高效进行字符串匹配、查找与替换,帮助开发者快速掌握正则表达式的实际应用。
本文整理了 C# 开发中常用的正则表达式集合,涵盖中文匹配、日期提取、HTML 清理、邮箱 URL 验证及各类数字格式校验。提供直接可用的代码片段,帮助开发者快速处理表单输入、数据清洗及文本解析任务,提升字符串处理效率。
本文介绍使用Python实现词频统计软件的方法。涵盖文件读取、大小写转换、特殊字符去除、单词统计、排序及结果写入文本等步骤。通过正则表达式清洗数据,利用字典统计词频,并按出现次数降序排列,最终输出高频单词及总数,适合初学者参考。
本文详细解析Python3正则表达式中的条件匹配语法(?(id/name)yes-pattern|no-pattern)。文章阐述了该语法的用途、参数含义及具体语法结构,并通过多个代码实例深入探讨了有组和无组、匹配成功与失败时的不同执行路径,最后总结了该特殊规则生效的关键条件及输出结果。