

C#中使用正则表达式的核心语法与常见场景实战
本文详细介绍在C#开发中如何使用System.Text.RegularExpressions命名空间进行字符串处理。涵盖正则基础符号(如括号、限定符)及常用转义字符的含义,提供身份证、Email、手机号等高频验证规则的精确写法,并演示Regex.IsMatch方法的实际调用步骤,帮助开发者快速实现高效的数据过滤与格式校验。
2026-10-16
5

本文详细介绍在C#开发中如何使用System.Text.RegularExpressions命名空间进行字符串处理。涵盖正则基础符号(如括号、限定符)及常用转义字符的含义,提供身份证、Email、手机号等高频验证规则的精确写法,并演示Regex.IsMatch方法的实际调用步骤,帮助开发者快速实现高效的数据过滤与格式校验。
本文介绍在 C# 开发中如何使用 System.Text.RegularExpressions 命名空间下的 Regex 类进行邮箱格式验证。提供了判断 QQ 邮箱的专用规则,以及支持 com、cn、net 后缀的通用邮箱验证代码,并附控制台测试实例,帮助开发者快速实现邮箱有效性校验。
本文解析 PHP 数据采集的核心流程,包括使用 fopen 获取网页源码、利用 preg_match_all 正则提取列表页的链接与标题,以及解决连续请求失效问题的 Meta Refresh 循环技巧。
本文详细讲解了在PHP中如何正确处理包含中文等多字节字符的字符串截取。重点分析了原生substr函数导致的乱码问题,并提供了基于UTF-8正则匹配、GBK编码处理以及BugFree经典算法等多种解决方案,帮助开发者准确截断字符串并保留完整编码结构。
本文介绍Python中从HTML提取纯文本的三种常用方法:使用正则表达式移除标签、调用NLTK库的clean_html函数以及自定义HTMLParser解析器。文章对比了各方案的代码实现、依赖要求及适用场景,帮助开发者根据项目需求选择最高效的文本提取方案。
本文深入解析Python中re模块的核心用法,涵盖match、search、findall及sub等关键函数。详细讲解正则表达式语法、标志位控制、分组与命名分组技巧,以及compile编译优化和贪婪/非贪婪模式的区别,帮助开发者高效处理字符串匹配与替换任务。
本文深入解析Python中正则表达式模块re的findall方法。通过具体代码示例,详细讲解如何提取字符串中的数字、单词及特定模式。重点阐述贪婪匹配与非贪婪匹配的区别,以及使用括号进行分组捕获的原理。同时涵盖多行字符串匹配时的re.S标志应用,以及结合sub和split函数进行数据清洗的实战技巧,帮助开发者高效处理文本数据。
本文详解Python中使用正则表达式re.sub匹配或替换反斜杠\\时的转义问题。由于正则语法与Python字符串解析器的双重转义机制,直接写入单个反斜杠会导致语法错误。文章通过对比分析,解释了为何需要四个反斜杠(\\\\)或使用原始字符串(r'\\')来正确匹配单个反斜杠,并提供了str.replace()作为替代方案。

本文系统梳理Python中re库的核心功能,深入解析元字符与预定义字符集的使用规则。重点对比match与search函数的匹配差异,详解sub与subn在字符串替换中的不同返回值,并介绍split分割逻辑。此外,通过具体代码示例演示命名捕获组的构建与应用,帮助开发者高效处理文本匹配、替换及提取任务。
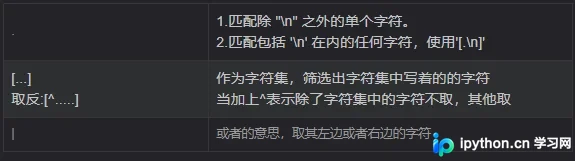
本文详细解析Python中正则表达式模块re的group()方法。通过实例说明如何利用括号进行分组匹配,解释group()、group(0)与group(n)的区别。重点分析匹配失败返回None导致的AttributeError,以及未定义分组引发的IndexError,帮助开发者避免常见编码错误。
本文深入解析Python中正则表达式 r'(.*) are (.*?) .*' 的匹配机制。通过对比贪婪模式 (.*) 与非贪婪模式 (.*?) 的行为,结合多个代码示例,详细阐述分组捕获、无分组匹配及多are分隔符下的匹配结果差异,帮助开发者准确掌握正则表达式的核心逻辑。
本文详解Python中正则表达式的使用,重点介绍re模块的核心函数如search、match、findall、split、sub等。涵盖基础语法符号、原生字符串处理及常见应用场景,帮助开发者快速掌握字符串匹配与处理技巧。