

Python正则表达式匹配IP、URL及邮箱详解
本文详细介绍如何利用Python的re模块通过正则表达式分别匹配IP地址、URL网址以及电子邮件地址。文章提供了具体的正则模式代码及测试示例,帮助开发者快速掌握网络数据格式验证的核心技巧。
2026-10-13
6

本文详细介绍如何利用Python的re模块通过正则表达式分别匹配IP地址、URL网址以及电子邮件地址。文章提供了具体的正则模式代码及测试示例,帮助开发者快速掌握网络数据格式验证的核心技巧。
本文介绍如何利用 Python 正则表达式精准匹配字符串中的 HTTP 及 HTTPS 链接。通过编译特定模式,可有效识别包含特殊字符、百分号编码及子域名的 URL。示例代码展示了从文本中提取短链接的全过程,为网络爬虫和数据清洗提供实用参考。
本文介绍如何利用Python的re模块及正则表达式,精准提取两个指定字符或字符串之间的内容。通过示例代码演示findall函数的用法,展示如何从包含特定标记的文本中获取目标子串,适用于日志解析及数据清洗场景。
本文介绍在Python中利用正则表达式清除两个特定特殊字符之间内容的实现方法。通过示例展示如何定位并移除指定范围内的文本,适用于日志清理、模板处理等场景。
本文介绍在Python文本预处理中,利用re模块的正则表达式功能,将字符串中的连续多个空格合并为单个空格,以及将连续数字替换为特定符号(如num)的方法。通过具体代码示例展示了re.sub函数的实际应用,适用于自然语言处理前的数据清洗场景。
本文介绍如何在Python中从HTML的div标签中提取纯文本。通过结合使用re.compile编译正则表达式与re.sub进行替换,配合BeautifulSoup解析HTML结构,可有效去除标签符号。文中详细解析了正则编译标志及原生字符串的使用,并提供了完整的抓取与保存示例代码。
本文介绍如何使用Python的urllib2库结合正则表达式,通过搜狗微信搜索接口爬取指定公众号的文章列表。教程涵盖从构建请求URL、解析HTML文本、提取JSON数据到拼接完整文章链接的完整流程,并提供可直接运行的代码示例,帮助开发者快速实现公众号文章抓取功能。
本文介绍如何在Python中处理包含多个不同分隔符的字符串。默认split()仅支持单一分隔符,通过引入re模块并使用正则表达式字符集,可一次性指定多个分隔符进行分割,适用于日志解析等场景。
本文详细介绍Django框架中基于正则表达式的URL分发机制。重点解析URL模式定义时省略前导斜杠的规范,以及使用Python原始字符串(raw string)处理反斜杠转义冲突的重要性。通过官方示例代码,展示如何正确配置年份、月份及文章详情的URL路由规则,帮助开发者避免常见的语法错误。
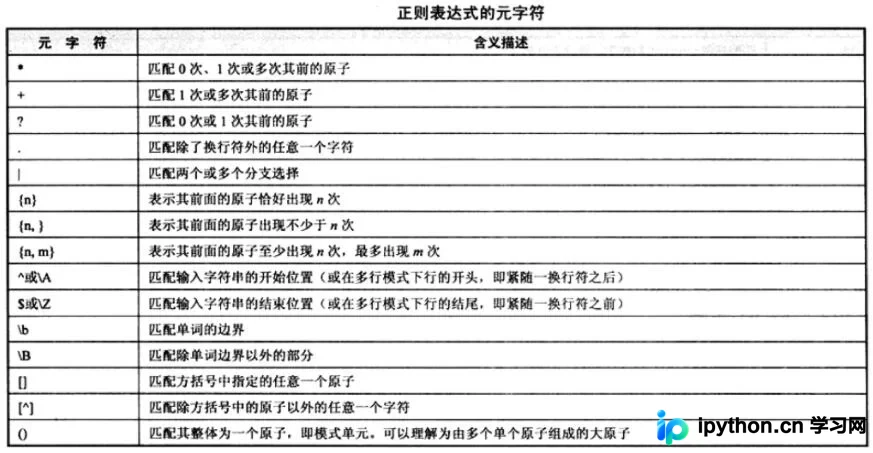
本文介绍在Python中利用正则表达式实现按多个空格分割字符串的方法。通过re.split函数配合特定模式,可有效处理包含连续空格的文本数据,并展示了从原始数据到处理结果的完整流程及代码示例。
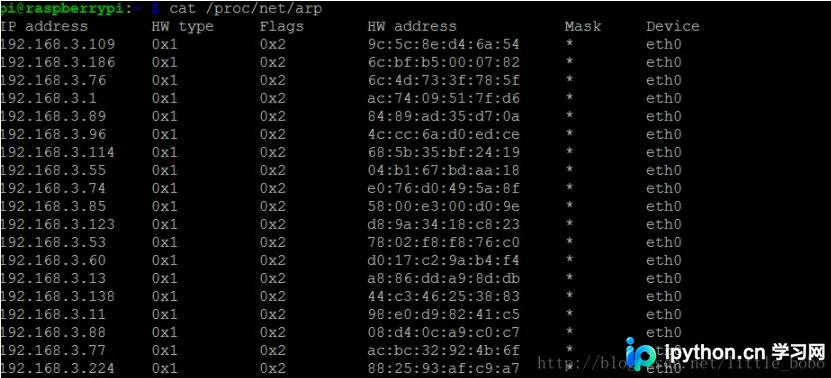
本文分析Python中使用正则表达式匹配网页图片URL时,因HTML源码包含换行符导致匹配失败的问题。通过对比单行与多行字符串匹配结果,指出默认模式下'.'不匹配换行符。解决方案为在re.compile中传入re.S标志,使点号匹配所有字符包括换行符,从而完美提取跨行显示的图片地址。
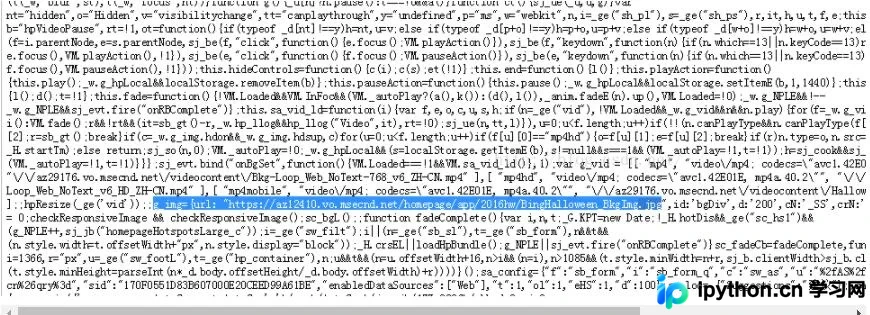
本文探讨Python网页采集中正则表达式匹配换行符的问题。默认情况下,正则中的点号(.)无法匹配换行符,导致数据采集失败。通过示例展示使用[\s\S]组合可匹配包括换行在内的任意字符,并简要介绍\s与\S的定义,帮助开发者解决HTML解析中的换行匹配难题。