

Python爬虫UnicodeDecodeError异常处理与通用解码方案
本文详解Python爬虫中常见的UnicodeDecodeError异常原因,并提供两种通用解码策略:通过HTML标签提取charset自动解码,以及遍历utf-8、gbk等常用编码并配合errors='replace'参数尝试解析。通过对比数据完整性,推荐以实际数据表现选择最佳编码方式,有效解决网页抓取中的乱码问题。
2026-10-13
6

本文详解Python爬虫中常见的UnicodeDecodeError异常原因,并提供两种通用解码策略:通过HTML标签提取charset自动解码,以及遍历utf-8、gbk等常用编码并配合errors='replace'参数尝试解析。通过对比数据完整性,推荐以实际数据表现选择最佳编码方式,有效解决网页抓取中的乱码问题。

本文介绍使用Python抓取中国天气网城市近7天天气预报的完整流程。通过F12开发者工具分析HTML结构,定位日期、温度、风向等关键标签,编写Requests请求与BeautifulSoup解析代码,实现数据提取与格式化输出,并提供完整示例供参考。
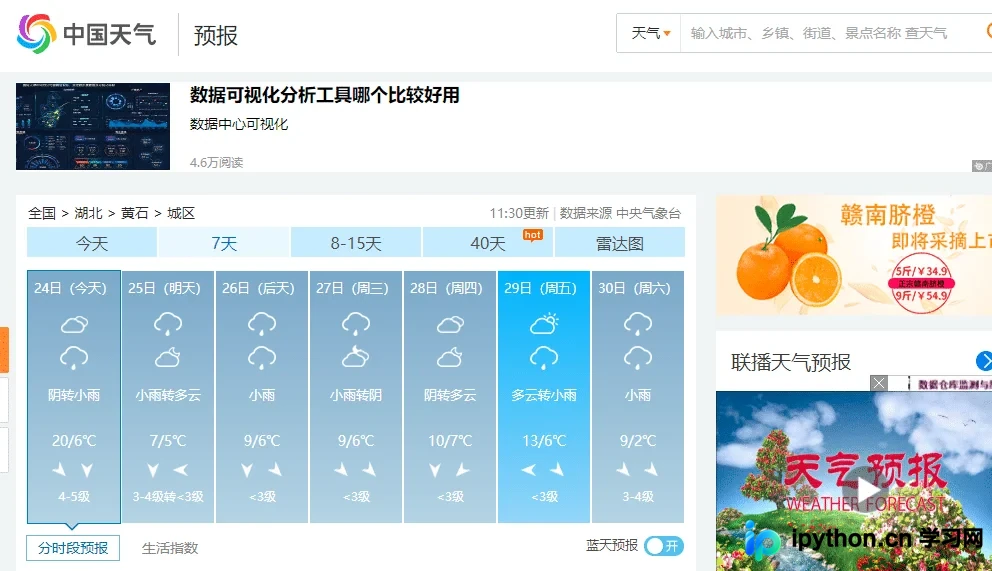
本文详细介绍如何使用Python编写校园通知监控脚本。通过urllib和re库抓取教务处、图书馆等网站的新通知,利用Twilio发送短信、smtplib发送邮箱提醒。文中还涵盖了处理编码异常、多收件人发送、Windows中文环境兼容性及使用PyInstaller打包为exe可执行文件的完整流程与常见故障排除。
本文详解如何使用Python编写爬虫程序,通过BeautifulSoup解析HTML并配合正则表达式过滤有效词条链接,实现维基百科“六度分隔理论”的自动化遍历。文章涵盖链接提取、随机路径生成及随机数种子设置等核心步骤,旨在帮助开发者理解单域名遍历爬虫的基本逻辑与注意事项。
本文介绍Python爬虫在抓取网站内链时识别页面类型的三种核心方法:通过URL结构判断、检测特定HTML字段存在性、以及利用DOM标签定位。同时深入讲解Python面向对象设计,通过基类与子类继承机制,实现不同页面类型(如产品页、文章页)的数据结构复用与扩展,提升爬虫代码的可维护性。
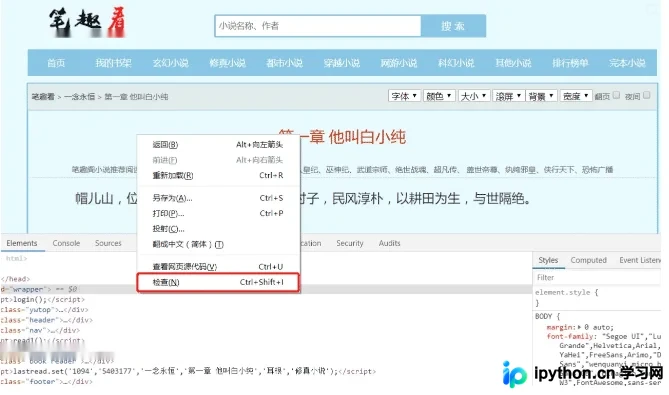
本文详细介绍如何使用Python编写爬虫程序,从笔趣网爬取小说《一念永恒》。重点讲解BeautifulSoup库的安装与使用,包括通过开发者工具定位HTML元素、构造带User-Agent的HTTP请求以及解析响应数据的具体步骤。旨在帮助初学者掌握基础的网络数据采集技巧,同时强调支持正版阅读的重要性。
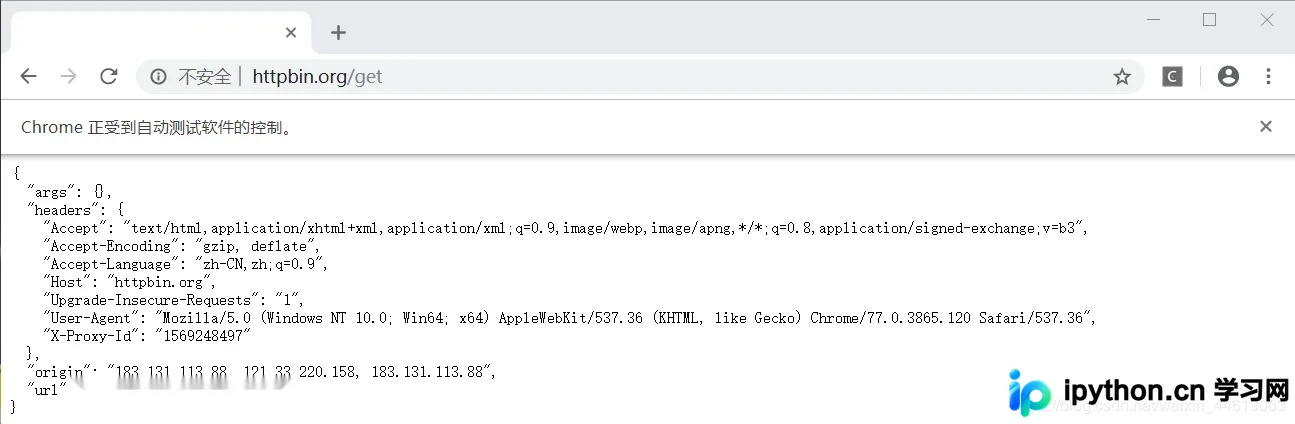
本文详解Python爬虫中代理IP的配置方法,涵盖Urllib、Requests及Selenium三种主流库的代理设置。通过搭建代理池接口获取IP,并结合httpbin.org验证IP伪装效果,帮助开发者解决IP被封禁问题,提升爬虫稳定性与效率。
本文详解如何利用Python的browsercookie模块自动从Chrome、Firefox等主流浏览器中提取已保存的Cookie,解决爬虫登录验证难题。通过安装配置、代码示例及requests库结合使用,实现无需手动输入账号密码即可访问需登录状态的网页内容,提升数据采集效率。
本文详细介绍如何在Python中利用Selenium配合Headless Chrome进行网页内容抓取。文章涵盖Chrome及Chrome Driver的安装配置,解决国内源安装问题,并提供完整的Python代码示例,包括无头模式启动、页面加载超时设置及元素提取方法,适用于Linux环境下的自动化数据采集场景。
本文深入解析Pyppeteer作为Selenium替代方案的用法。介绍其基于Python async机制的异步优势,详解launch方法的headless、args等关键参数配置,并通过实例演示如何自动处理Chromium依赖及结合pyquery解析JS渲染页面,实现高效网页数据抓取。
本文详解Python爬虫中多线程的使用,重点介绍如何利用标准库Queue解决线程间数据共享与交换的安全性问题。通过糗百图片抓取的实战案例,展示如何构建URL队列、启动多线程并发请求,并控制线程数量以优化抓取速度,确保数据一致性与程序稳定性。
本文详解Python 2中urllib2模块的核心用法,涵盖urlopen基础请求、Request对象构造及HTTP报头设置。通过实例演示如何获取网页源码、添加User-Agent伪装浏览器身份,并处理POST数据与自定义Header,帮助开发者掌握基本的网页抓取技巧。