Python爬取豆瓣电影Top100实战:从请求到存储
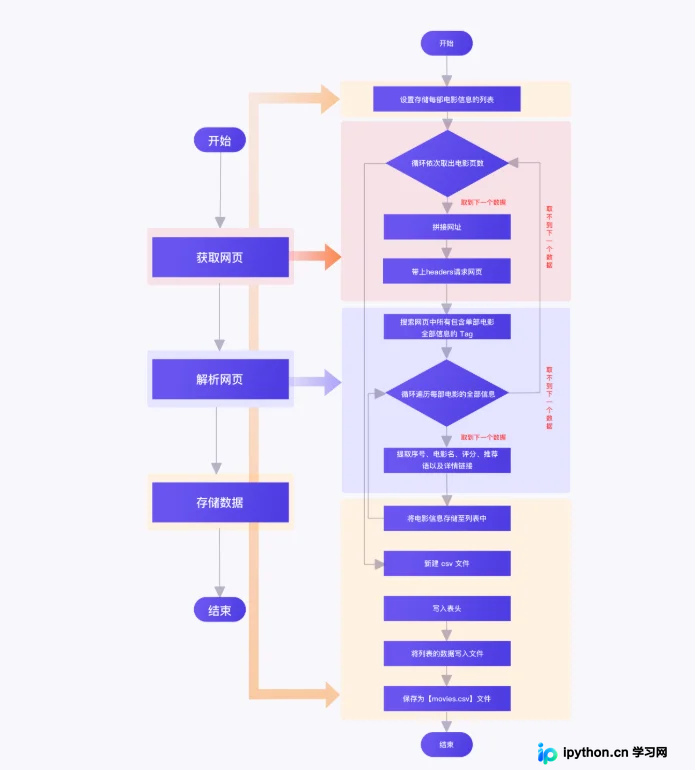
本文详细介绍如何使用Python爬取豆瓣电影Top100的数据。通过Requests库模拟浏览器请求,利用BeautifulSoup解析HTML结构提取电影信息,并采用CSV模块将结果持久化存储。文章涵盖网页规律分析、Headers设置、Robots协议检查及数据清洗存储等关键步骤,适合Python初学者学习网络爬虫基础。
2026-10-15
1

本文详细介绍如何使用Python爬取豆瓣电影Top100的数据。通过Requests库模拟浏览器请求,利用BeautifulSoup解析HTML结构提取电影信息,并采用CSV模块将结果持久化存储。文章涵盖网页规律分析、Headers设置、Robots协议检查及数据清洗存储等关键步骤,适合Python初学者学习网络爬虫基础。
本文介绍如何使用Python编写一个简单的爬虫程序,从特定图片网站批量下载图片。通过Requests发起HTTP请求获取页面源码,利用Lxml结合XPath定位封面链接及高清图片地址,最后将图片保存至本地文件夹。文章包含完整代码示例及优化建议。
本文详细介绍如何利用 Python 的 Selenium 和 Requests 库爬取西瓜视频。通过构建 embedUrl 获取 group_id,使用无头浏览器模拟访问提取视频真实地址,最后拼接 http 协议并下载二进制数据保存为 mp4 文件。
本文详解如何使用Python的requests库实现豆瓣登录及会话状态保持,通过Session对象自动管理Cookie,进而批量抓取《荒野生存》影评数据。结合正则表达式提取内容,利用结巴分词与词云库进行数据分析,完整展示从登录接口分析到数据可视化的全流程。
本文介绍如何使用Python的requests库抓取腾讯新闻疫情实时数据接口,并通过json解析提取全国及江苏省各地级市的确诊、新增及治愈数据。结合PrettyTable美化输出,最后利用matplotlib库对江苏各地市疫情分布进行可视化分析,直观展示扬州等地疫情状况。
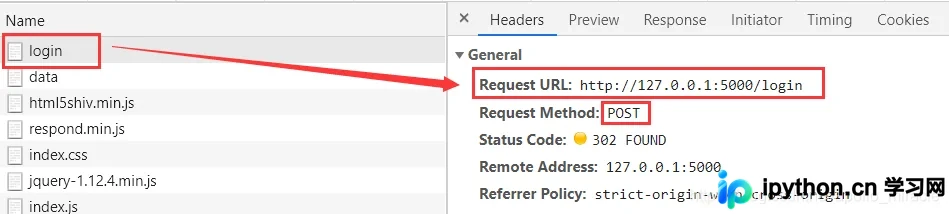
本文详解Python如何使用requests库通过HTTP协议上传文件。重点解析登录保持Session、利用fiddler抓包分析请求参数,以及data与files参数的配合使用。特别强调在上传文件时,headers中严禁手动指定Content-Type,需交由requests库自动生成,否则会导致上传失败。
本文深入解析Python requests库中timeout参数的两种设置方式:单一值与元组形式。重点指出连接超时默认21秒而读取超时无默认值易导致程序永久挂起的风险,并提供针对高并发场景的超时配置建议及常见卡死问题的解决方案。
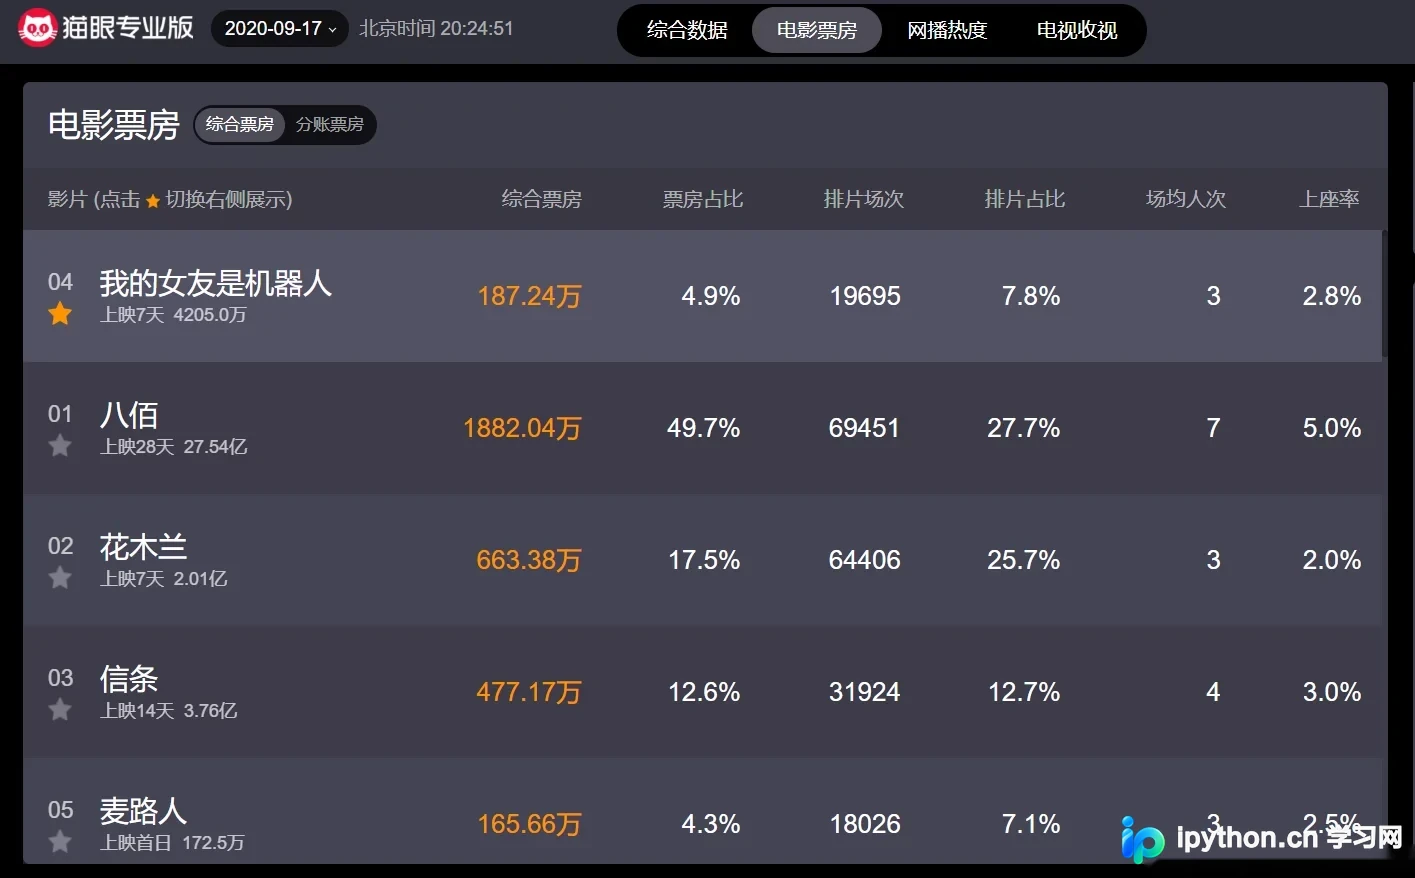
本文详细介绍如何使用Python抓取猫眼电影最近上映电影的票房信息。通过配置Python 3.6环境,利用requests模块发送HTTP请求获取JSON数据,解析电影名、票房、排片占比等关键字段,并最终将结果保存至CSV文件。适合Python初学者进行数据抓取实战练习。
针对办公环境网络隔离导致VBA开发不便的问题,本文介绍如何利用Python结合Selenium与Requests库,从微软官方文档网站抓取VBA API数据。通过遍历导航树获取链接,下载主体页面内容,并基于jstree构建本地离线查询工具,实现无网环境下的VBA参考查阅。
本文通过Python 3.7环境,演示如何使用Requests发起HTTP请求并处理GBK编码,结合BeautifulSoup解析HTML结构以提取51job职位列表。文章详细讲解了数据获取、解析及保存至JSON文件的完整流程,并探讨了多线程、动态渲染及数据库存储等进阶优化方向。
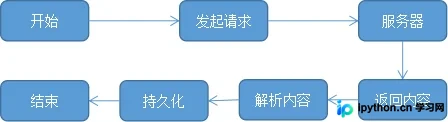
本文详解如何利用Python从www.weather.com.cn批量爬取指定数量的图片。通过对比单线程与多线程两种实现方式,展示请求头构造、HTML解析、正则提取图片链接及本地保存的完整流程。重点解析多线程模块threading的使用及异常处理,帮助开发者提升数据抓取效率。
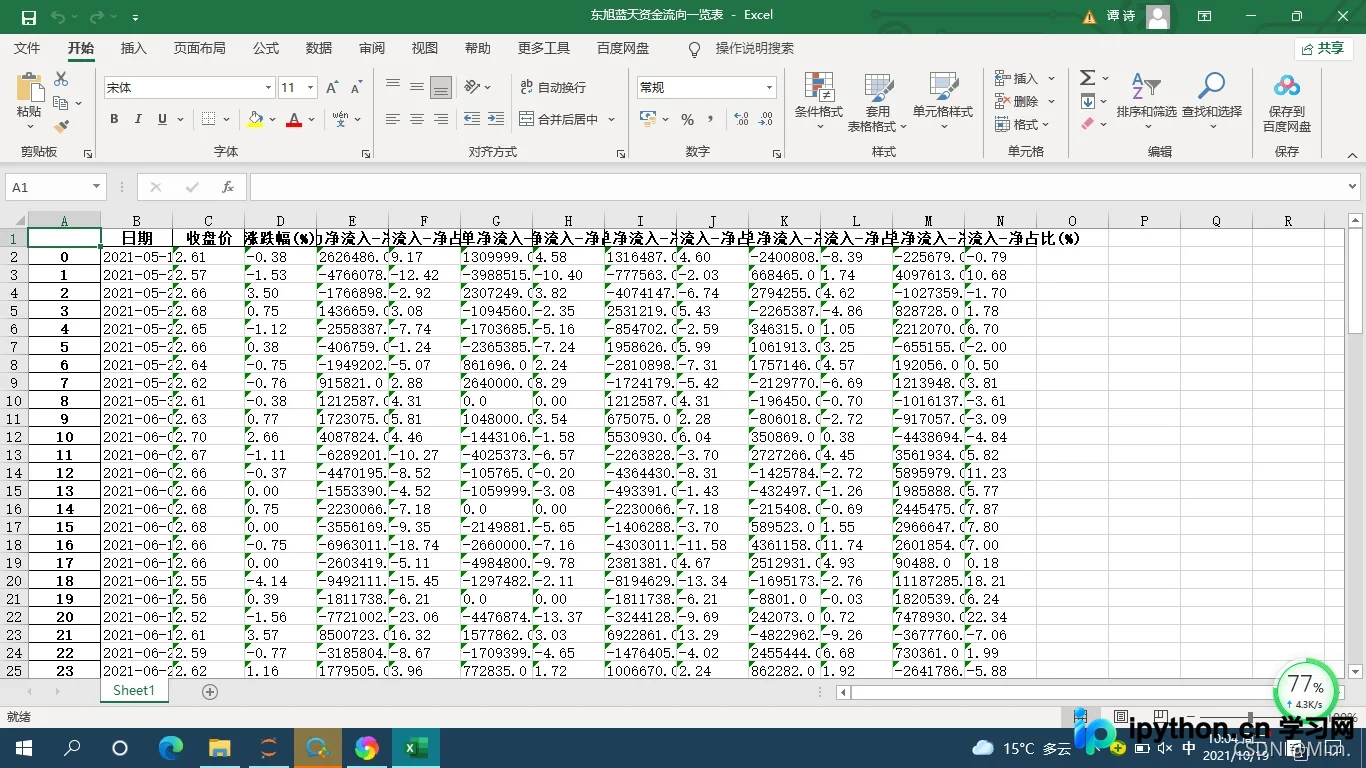
本文详解如何使用Python的Requests库发起HTTP GET请求,通过构造特定的URL参数和Headers获取东方财富网的股票资金流向数据。接着利用正则表达式和JSON模块解析返回的嵌套数据结构,提取关键财务指标。最后结合Pandas库将清洗后的数据整理为DataFrame并导出为Excel文件,实现从数据采集到可视化的完整流程。