

Python正则表达式实战指南:从基础语法到re模块应用

本文深入解析Python中正则表达式的应用,涵盖字符匹配、预定义字符、数量限定及断言等核心语法。重点讲解re模块中compile、match、search、findall、split和sub六大常用方法,结合代码示例演示如何高效进行数据验证与字符串处理,帮助开发者掌握正则表达式在爬虫及数据处理中的实战技巧。
正则表达式基础与Python应用概述
正则表达式是程序开发中不可或缺的工具,广泛应用于数据格式验证、字符替换以及字符串内容提取等场景。然而,许多开发者仅停留在基础使用层面,一旦面临如网络爬虫等大规模正则表达式应用的复杂情况,往往难以应对。本文将通过Python语言系统讲解正则表达式的使用。阅读前建议具备Python或其他编程语言的基础,因为各语言中正则表达式的核心逻辑是相通的。
零、正则表达式基础
字符匹配与预定义字符
1.提取字符(串) 当需要从字符串中截取特定内容时,逐字遍历不仅效率低下且易出错。此时,正则表达式的字符匹配功能便派上用场。正则表达式提供了4种主要的字符匹配方法,具体见下表:
| 语法 | 说明 | 例子 | 可匹配字符串 |
|---|---|---|---|
| . | 匹配除了换行符 “\n” 以外的任意字符 | a.b | acb、adb、a2b、a~b |
| \ | 转义,将转移字符后面的一个字符改变原来的意思 | a[b\.\\]c | abc、a.c、a\c |
| [] | 匹配括号内的任意字符 | a[b,c,d,e]f | abd、acf、adf、aef |
| [^] | 除了括号内的字符外,其他的字符都匹配 | aa,b,c,d,ef | a1f、a#f、azf、agf |
2.预定义字符 预定义字符是正则表达式中用于匹配格式化内容的专用符号,例如使用 \d 匹配数字,使用 \s 匹配空白符。利用这些预定义字符可以快速定位符合特定格式的内容。虽然这些内容也可通过前述字符匹配方式实现,但预定义字符能显著减少代码量。以下是常见的预定义字符列表:
| 语法 | 说明 | 例子 | 可匹配字符串 |
|---|---|---|---|
| ^ | 以什么字符串开始 | ^123 | 123abc、123321、123zxc |
| $ | 以什么字符串结尾 | 123$ | abc123、321123、zxc123 |
| \b | 匹配单词边界,不匹配任何字符 | \basd\b | asd |
| \d | 匹配数字0-9 | zx\dc | zx1c、zx2c、zx5c |
| \D | 匹配非数字 | zx\Dc | zxvc、zx$c、zx&c |
| \s | 匹配空白符 | zx\sc | zx c |
| \S | 匹配非空白符 | zx\Sc | zxac、zx1c、zxtc |
| \w | 匹配字母、数字和下划线 | zx\wc | zxdc、zx1c、zx_c |
| \W | 匹配非字母、数字和下划线 | zx\Wc | zx c、zx$c、zx(c |
在使用预定义字符时,需注意以下几点:
- \b 仅匹配一个位置,该位置一侧为单词字符,另一侧为非单词字符、字符串起始或结束位置。\b 属于零宽度匹配。
- \w 在不同编码环境下的匹配范围不同:在ASCII编码语言中,它匹配 [a-zA-Z0-9];而在Unicode编码语言中,除了上述字符外,还匹配汉字及全角符号等特殊字符。
数量限定与断言语法
3.限制数量 当需要匹配重复内容时,可使用数量限定模式。具体语法如下表所示:
| 语法 | 说明 | 例子 | 可匹配字符串 |
|---|---|---|---|
| * | 匹配0到多次 | zxc* | zx、zxccccc |
| + | 匹配1次到多次 | zxc+ | zxc、zxccccc |
| ? | 匹配0次或1次 | zxc? | zxc、zx |
| {m} | 匹配m次 | zxc{3}vb | zxcccvb |
| {m,} | 匹配m次或多次 | zxc{3,}vb | zxcccvb、zxccccccccvb |
| {,n} | 匹配0次到n次 | zxc{,3}vb | zxvb、zxcvb、zxccvb、zxcccvb |
| {m,n} | 匹配m次到n次 | zxc{1,3} | zxcvb、zxccvb、zxcccvb |
4.断言 断言(又称零宽断言)指当断言表达式为真时才进行匹配,但不消耗断言表达式本身的字符。与 ^(开头)、$(结尾)、\b(单词边界)类似,先行断言和后行断言也仅匹配特定位置,不占用字符,故称为零宽。所谓位置,指字符串首字符左侧、尾字符右侧或相邻字符中间。零宽断言包含四种形式:
- 零宽度负回顾后发断言 (?<!exp),当表达式不成立时匹配断言后的位置,成立时则不匹配。例如 \w+(?<zxc)\d,用于匹配不以 zxc 结尾的字符串;
- 零宽度负回顾先行断言 (?!exp),匹配断言前的位置,若断言成立则不匹配。例如:\d(?!zxc)\w+,用于匹配不以 zxc 开头的字符串;
- 先行断言 (?=exp),当断言为真时匹配断言前的位置。例如在字符串 “a regular expression” 中提取 regular 中的 re,可写作 re(?=gular);
- 后发断言 (?<=exp),当断言为真时匹配断言后的位置。例如在字符串 “egex represents regular expression” 中,若要匹配除 regex 和 regular 之外的 re,可使用 re(?!g),该表达式限定了 re 右侧位置,确保其后不紧跟字符 g。先行与后发的区别在于该位置之后的字符是否能匹配括号内的表达式。
贪婪模式与其他高级语法
5.贪婪/非贪婪 正则表达式默认采用贪婪模式,即尽可能多地匹配字符。然而,贪婪模式有时会导致过度匹配,例如在字符串 “Jack123Chen123Chen” 中,贪婪模式会匹配整个字符串而非预期的 “Jack123Chen”。此时需使用非贪婪模式,常用表达式如下:
| 语法 | 说明 |
|---|---|
| *? | 匹配0次或多次,但要尽可能少重复 |
| +? | 匹配1次或多次,但要尽可能少重复 |
| ?? | 匹配0次或1次,但要尽可能少重复 |
| {m,}? | 匹配m次或多次,但要尽可能少重复 |
| {m,n}? | 匹配m次或n次,但要尽可能少重复 |
6.其他 上述内容为正则表达式的常用部分,以下介绍一些不常用但功能强大的语法。
- OR 匹配(又称分支匹配)指只要有一个分支匹配成功即视为匹配,类似于编程中的 OR 语句。利用 | 分割分支即可实现。例如匹配英文姓名时,姓和名之间可能由 · 或空格分隔,可通过 OR 匹配处理,格式如下:[A-Za-z]+·[A-Za-z]+|[A-Za-z]+\s[A-Za-z]+
- 组合(分组)将多个项组合为一个单元,该单元可通过 *、+、?、| 等符号修饰,并能记住匹配结果以供后续引用。分组使用 () 表示。例如日期正则表达式可写为:\d{4}-(0[1-9]|1[0-2])-(0[1-9]|12|3[01])。其中第一个分组 (0[1-9]|1[0-2]) 匹配月份,第二个分组 (0[1-9]|12|3[01]) 匹配日期。
Python re模块核心方法详解
一、Python 使用正则表达式
在Python中使用正则表达式十分便捷,主要依赖 re 模块。使用步骤共三步:
- 将正则表达式字符串转换为 Pattern 实例;
- 使用 Pattern 实例处理待匹配字符串,匹配结果为一个 Match 实例;
- 利用 Match 实例执行后续操作。
Python中常用的 re 方法有六种:compile、match、search、findall、split 和 sub。下面将逐一讲解这些方法的具体用法。
compile与match方法使用
compile 方法用于将正则表达式字符串转换为 Pattern 实例,接受两个参数:pattern(字符串类型,接收正则表达式)和 flags(整数类型,接收匹配模式编号,非必填,默认为 0,表示忽略大小写)。flags 支持以下 6 种模式:
| 匹配模式 | 说明 |
|---|---|
| re.I | 忽略大小写 |
| re.M | 多行匹配模式 |
| re.S | 任意匹配模式 |
| re.L | 预定义字符匹配模式 |
| re.U | 限定字符匹配模式 |
| re.V | 详细模式 |
上述六种模式在实际开发中较少使用,了解即可。compile 的使用示例如下:
import re
pattern = re.compile(r'\d')
2.match 方法利用 Pattern 实例从字符串左侧开始匹配,若匹配成功返回 Match 实例,否则返回 None。
import re
def getMatch(message):
pattern = re.compile(r'(\d{4}[-年])(\d{2}[-月])(\d{2}日{0,1})')
match = re.match(pattern, message)
if match:
print(match.groups())
for item in match.groups():
print(item)
else:
print("没匹配上")
if __name__ == '__main__':
message = "2019年01月23日大会开始"
getMatch(message)
message = "会议于2019-01-23召开"
getMatch(message)
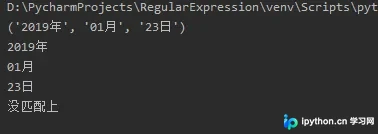
代码中使用了 groups 方法来获取匹配出的字符串组。部分读者可能会疑惑,为何第一段内容能匹配出年月日,而第二段不能?这是因为 match 方法仅从字符串起始位置进行匹配。代码运行结果如图:
search与findall方法应用
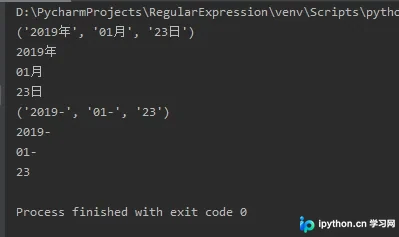
3.search 方法与 match 功能相似,但 search 会对整个字符串进行匹配。只需将前一小节代码中的 getMatch 方法改为使用 search,即可匹配出第二段内容中的年月日。
import re
def getMatch(message):
pattern = re.compile(r'(\d{4}[-年])(\d{2}[-月])(\d{2}日{0,1})')
match = re.search(pattern, message)
if match:
print(match.groups())
for item in match.groups():
print(item)
else:
print("没匹配上")
if __name__ == '__main__':
message = "2019年01月23日大会开始"
getMatch(message)
message = "会议于2019-01-23召开"
getMatch(message)
上述代码运行结果如下图:
4.findall 方法用于匹配整个字符串,并以列表形式返回所有匹配结果。
import re
def getMatch(message):
pattern = re.compile(r'\w+')
match = re.findall(pattern, message)
if match:
print(match)
else:
print("没匹配上")
if __name__ == '__main__':
message = "my name is 张三"
getMatch(message)
message = "张三 is me"
getMatch(message)
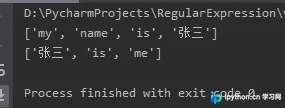
代码运行结果如下图:
split与sub方法实战
5.split 方法利用指定字符分割字符串。
import re
def getMatch(message):
pattern = re.compile(r'-')
match = re.split(pattern, message)
if match:
print(match)
else:
print("没匹配上")
if __name__ == '__main__':
message = "2018-9-12"
getMatch(message)
message = "第一步-第二步-第三步-第四步-and more"
getMatch(message)
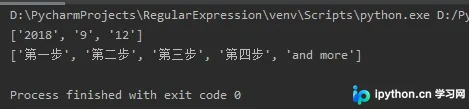
上述代码运行结果如下图:
6.sub 方法用于替换字符串,接受5个参数,其中常用的有三个:
- pattern,Pattern 实例
- string,等待替换的字符串
- repl,表示替换的新字符串或需要执行的替换方法
- count,替换次数,默认为0表示全部替换
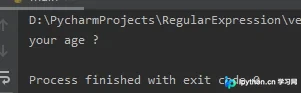
import re
def getMatch(match):
return match.group(0).replace(r'年龄', 'age')
if __name__ == '__main__':
message = "your 年龄 ?"
pattern=re.compile(r'\w+')
print(re.sub(pattern,getMatch,message))
代码运行结果如下图:
三、总结
Python中的正则表达式使用非常便捷,文中展示的代码可直接复制并稍作修改后应用于项目中。本文篇幅有限,主要侧重代码使用讲解,希望读者能充分理解并掌握正则表达式的写法。
作者简介: 朱钢,笔名喵叔,国内某技术博客认证专家,.NET高级开发工程师,拥有7年一线开发经验。曾参与电子政务系统和AI客服系统的开发,以及互联网招聘网站的架构设计,目前就职于一家初创公司,从事企业级安全监控系统的开发。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









