

Python爬取豆瓣Top250电影信息实战:从基础到多线程
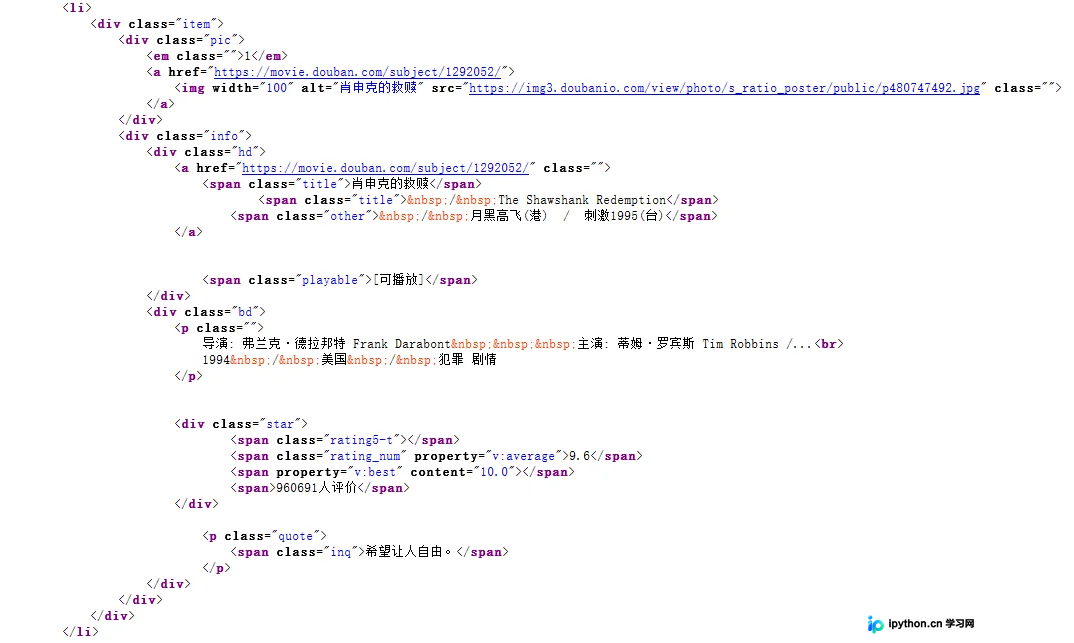
本文详解使用Python requests库与正则表达式爬取豆瓣电影Top250的完整流程。涵盖获取页面源码、解析电影序号、名称、评分及经典台词,并将结果以字典形式追加写入TXT文件。此外,文章对比了常规循环与多线程Pool的实现方式,提供高效获取电影数据的代码示例。
2026-10-13
6

本文详解使用Python requests库与正则表达式爬取豆瓣电影Top250的完整流程。涵盖获取页面源码、解析电影序号、名称、评分及经典台词,并将结果以字典形式追加写入TXT文件。此外,文章对比了常规循环与多线程Pool的实现方式,提供高效获取电影数据的代码示例。
本文详细介绍Python中基于socketserver模块实现非阻塞网络通信的方法。通过ThreadingTCPServer创建多线程服务端,配合自定义handle方法处理客户端连接,实现消息收发与随机响应。文章提供完整的服务端与客户端代码,并展示多客户端并发交互的运行结果,帮助开发者掌握Python网络编程基础。
本文深入解析Python多线程编程中的互斥锁(Rlock)与信号量(Semaphore)机制。通过对比分析Rlock的加锁解锁流程、Semaphore的计数逻辑以及BoundedSemaphore的上限检查特性,结合生产者-消费者模型代码示例,阐述如何利用锁机制保护共享数据一致性,避免并发冲突,提升程序安全性与执行效率。
本文介绍基于Python 3.6.7的端口扫描器实现。通过socket模块建立连接,利用threading模块进行多线程并发扫描,提升效率。代码包含参数解析、超时设置及结果统计,适用于1至1024端口范围的快速检测。
本文介绍使用Python编写脚本,从百度搜索结果中批量采集包含特定关键词或模式的URL链接。通过多线程加速抓取,支持自定义搜索关键词、页数及线程数,并将结果保存至文件,适用于安全测试或数据收集场景。
本文深入解析Python多线程开发中的同步问题,通过实例演示线程不安全现象及互斥锁解决方案。详细阐述生产者与消费者模式如何利用Queue模块实现解耦,并介绍ThreadLocal在隔离线程局部数据中的应用,帮助开发者构建高并发下的稳定应用。
本文介绍Python中使用多线程分块读取大文件的实现方法。通过继承threading.Thread创建Reader类,结合Partition类划分文件区间,实现高效并发读取。代码包含行对齐处理、线程启动与同步逻辑,适用于需要快速处理大文本文件的场景。
本文详细解析Python中threading模块的基本使用方法,包括如何正确传递元组参数、启动与等待线程执行。重点介绍守护线程(Daemon Thread)的设置及其对主线程结束的影响,通过代码示例说明setDaemon(True)的正确使用时机及注意事项,帮助开发者避免线程挂起或意外终止的问题。
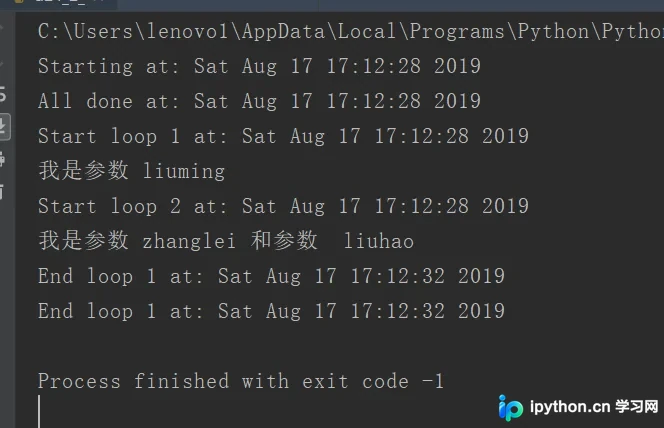
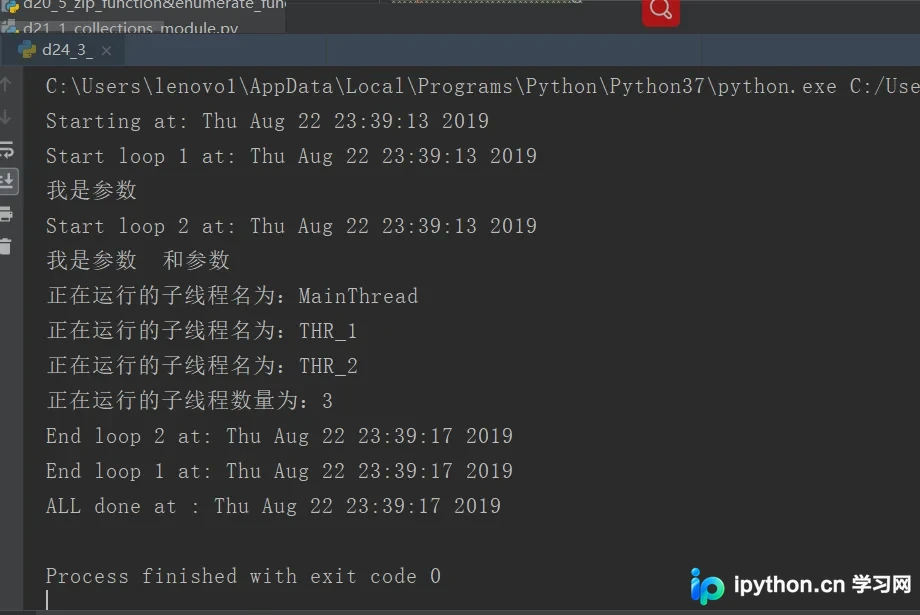
本文详解Python中threading模块的常用属性,包括currentThread、enumerate、activeCount及线程命名方法。同时介绍如何通过直接继承threading.Thread类并重写run函数来创建自定义线程,结合代码示例说明子线程的创建、启动与参数传递机制,帮助开发者掌握多线程编程核心技巧。
本文详解Python多线程中共享变量引发的数据竞争问题,通过加减法示例展示非原子操作导致的错误结果。重点讲解使用threading.Lock进行上锁与释放的操作流程,确保资源访问的原子性,并对比线程安全与不安全的容器类型,提供完整代码参考。
本文介绍使用Python多线程技术并发搜索TXT文件内容的方法。通过继承threading.Thread创建搜索线程,利用threading.Lock全局锁确保多线程写入文件时的数据一致性,避免读写冲突。代码展示了如何划分搜索区间、执行搜索并将结果安全写入指定文件,适用于大文件快速内容检索场景。
本文详解Python中创建多线程的两种核心方式:通过函数直接实例化Thread类,以及继承Thread类并覆写run方法。文章深入解析了Thread构造函数的参数用法,并系统梳理了start、join、is_alive、daemon等常用线程控制API,帮助开发者掌握Python并发编程的基础技能。