Python爬取豆瓣Top250电影信息实战:从基础到多线程
本文详解使用Python requests库与正则表达式爬取豆瓣电影Top250的完整流程。涵盖获取页面源码、解析电影序号、名称、评分及经典台词,并将结果以字典形式追加写入TXT文件。此外,文章对比了常规循环与多线程Pool的实现方式,提供高效获取电影数据的代码示例。
2026-10-13
13

本文详解使用Python requests库与正则表达式爬取豆瓣电影Top250的完整流程。涵盖获取页面源码、解析电影序号、名称、评分及经典台词,并将结果以字典形式追加写入TXT文件。此外,文章对比了常规循环与多线程Pool的实现方式,提供高效获取电影数据的代码示例。
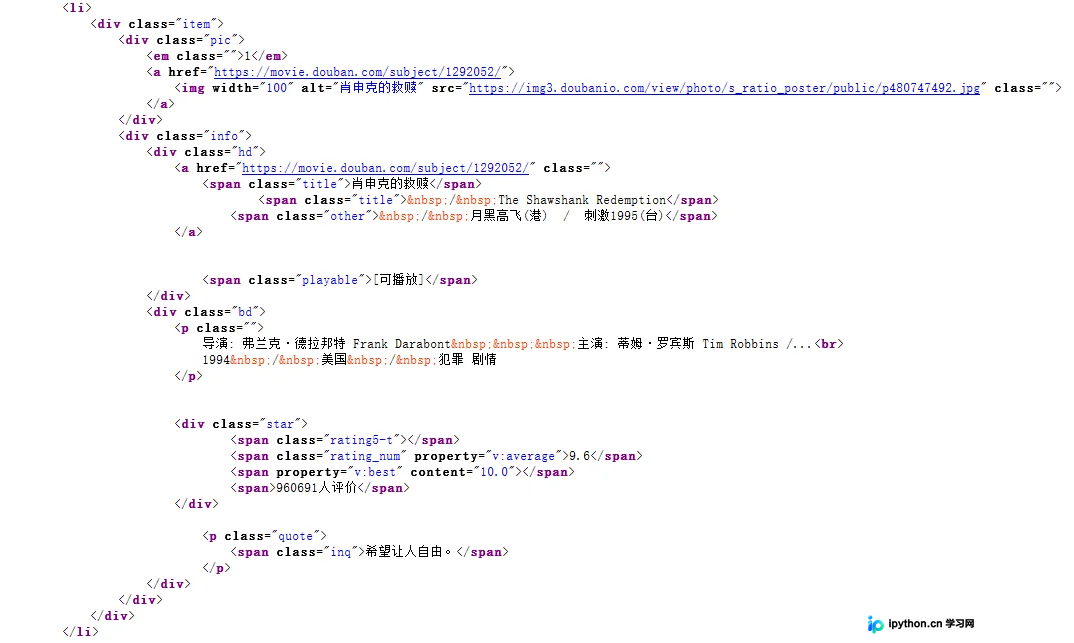
本文详解Python函数中的可变长参数,包括一个星号*args接收任意位置参数并转为元组,以及两个星号**kwargs接收关键字参数并转为字典。通过代码示例展示混合使用技巧,并强调关键字参数需置于位置参数之后及key不含冒号的注意事项。
本文详细介绍如何使用Python结合BeautifulSoup4库爬取名言网top10标签下的名言数据,并将包含名言、作者及标签的信息存储至MySQL数据库。代码涵盖网页解析、分页处理及数据库插入操作,适合Python初学者参考学习。
本文详细记录在Ubuntu 16.04环境下,使用Python 3.6、Django 1.11、Gunicorn 19.7.1及Nginx 1.10.3进行Web应用部署的完整流程。内容涵盖Django项目结构初始化、setting.py关键配置(DEBUG、ALLOWED_HOSTS、STATIC_ROOT)、静态文件收集,Gunicorn进程管理器的启动与配置,以及Nginx反向代理与静态文件服务的设置。同时提供常见错误排查方案,如端口不一致、静态文件404/403错误的解决方法,帮助开发者快速搭建生产环境。
本文提供一段Python实现的简易数据库查询小程序源代码。该程序通过解析类SQL语句,从文本文件中读取数据,并支持按指定字段进行条件筛选与结果输出。代码包含文件读取生成器、字段映射字典及条件处理逻辑,适合初学者理解Python文件操作与字符串处理。
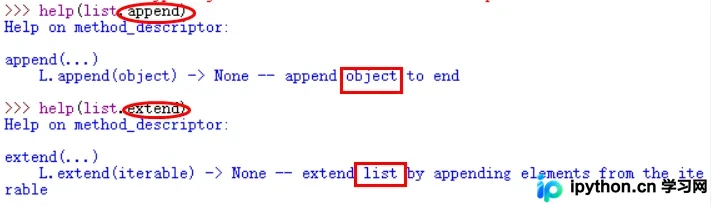
本文详细解析Python中列表追加元素的三种常用方法:append()、extend()和insert()。重点对比了append()将参数视为单个对象与extend()将参数视为可迭代对象并逐个展开插入的区别,同时介绍了insert()在指定位置插入元素的操作。通过具体代码示例,帮助开发者准确掌握不同场景下的最佳实践,避免类型错误。
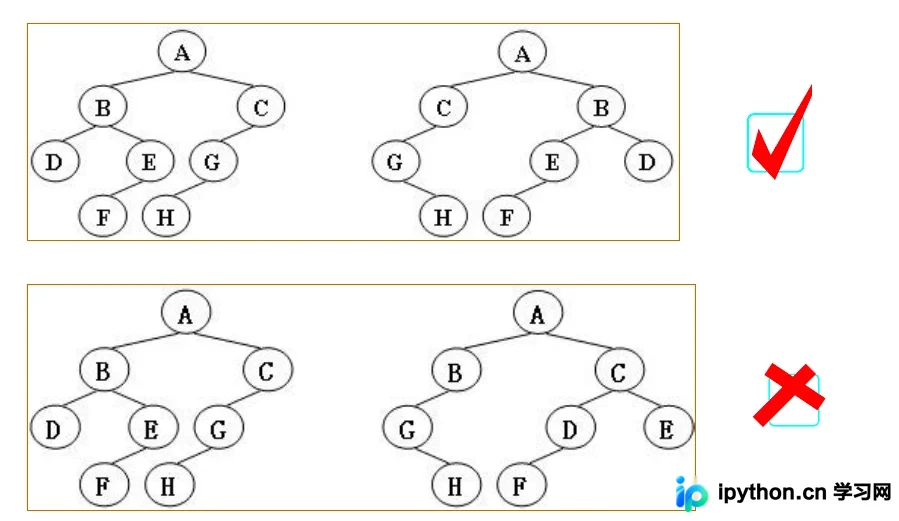
本文详细解析如何使用Python判断两棵二叉树是否同构。文章首先明确同构定义及包含空节点的输入格式,随后介绍一种基于单向链表的完整求解思路,并附带相关代码实现与注意事项,帮助开发者理解树结构处理与链表操作的综合应用。
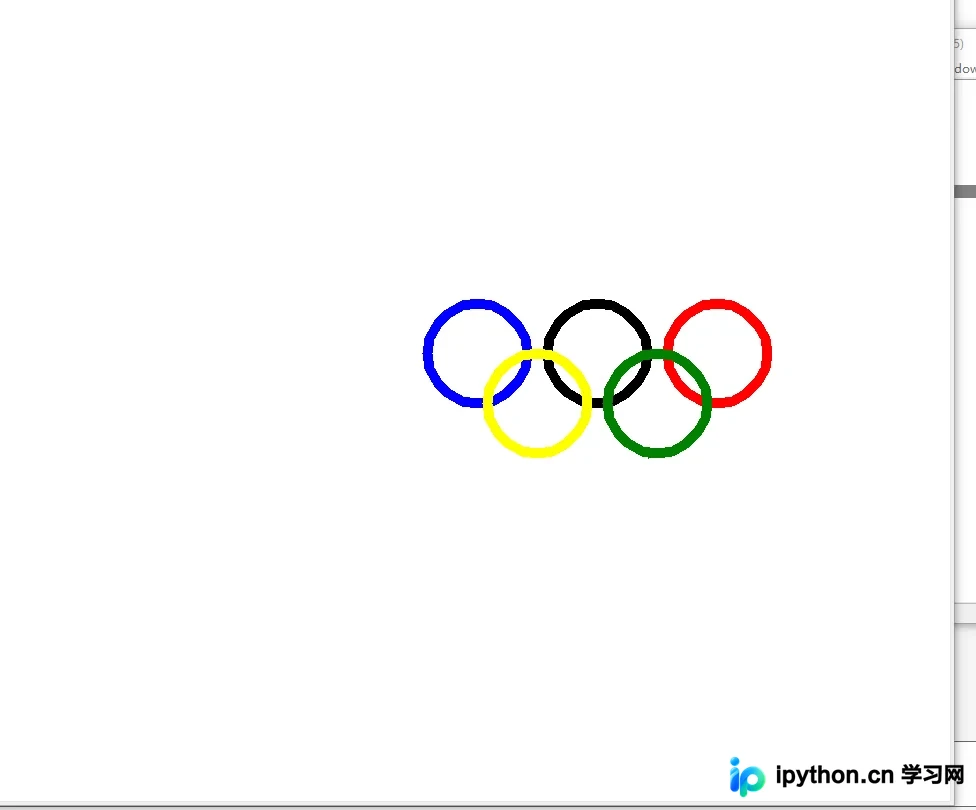
本文详细介绍如何使用Python的Turtle库绘制奥运五环。通过设置画笔宽度、颜色及坐标移动,分步演示蓝、黑、红、黄、绿五个圆环的绘制过程,帮助初学者掌握基本绘图指令与坐标定位技巧。
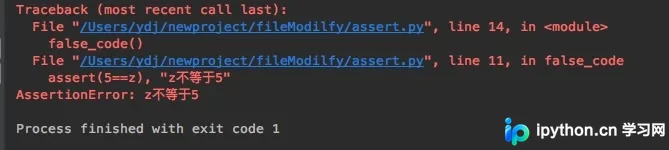
本文系统介绍了Python开发中常用的五种调试与排错方法。从基础的print打印输出,到测试人员常用的assert断言检查;从命令行交互式调试工具pdb的高级命令,到生产环境推荐的logging日志记录,以及IDE图形化调试器的使用。通过具体代码示例和命令说明,帮助开发者快速定位并解决程序错误,提升开发效率。
本文介绍如何使用Python的numpy和sklearn库将CSV数据矩阵划分为训练集和测试集。通过train_test_split函数,按7:3比例随机分割输入特征X和标签y,并支持指定random_state。最后将分割后的数据保存为CSV文件,便于后续模型训练。
本文详细解析Python中sys.stdin.readline()的用法,包括如何读取标准输入、处理换行符及类型转换。通过对比sys.stdin.readline()与input()在行为上的差异,如换行符保留、提示信息支持等,帮助开发者根据场景选择合适的方法,并提供完整代码示例说明多行输入处理技巧。
本文详细介绍Python3中将数据保存为TXT文件的方法,包括使用open()和write()函数进行基础写入,以及利用numpy库的savetxt()函数处理数组数据。同时涵盖使用save()和savez()保存二进制文件(.np/.npz格式)的操作,并附带读取数据的load()方法示例,帮助开发者高效管理数据存储。