

Python统计指定目录内文件的代码行数
本文介绍使用Python统计指定目录内各个Python文件的代码总行数、注释行数和空行数,并计算所占百分比的方法。
2026-10-13
13

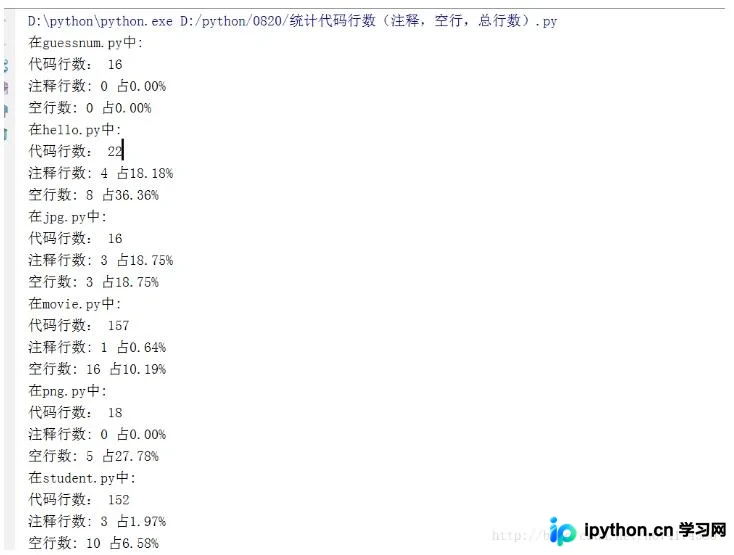
本文介绍基于Python3和easygui库开发的图形界面代码统计工具。程序通过递归遍历指定目录下的文件,忽略venv和.idea等无关目录,统计各类代码文件的行数并汇总展示。针对非UTF-8编码文件采用异常跳过机制,最终在GUI文本框中输出总行数、完成百分比及各类文件明细,为开发者提供便捷的项目规模评估手段。
本文深入解析 Python 函数默认参数的求值机制,重点探讨可变对象(如 list、dict)作为默认参数时引发的共享状态问题。通过代码示例说明默认值仅在定义时计算一次的特性,并提供使用 None 进行初始化的标准解决方案,帮助开发者避免常见的逻辑错误。
本文通过具体代码示例,详解Python中sorted函数的使用及自定义类的排序实现。内容涵盖利用key参数按字典元素首字母和年龄排序列表,以及通过重写__lt__方法实现Person类的自定义比较逻辑,帮助读者深入理解Python排序机制。
本文详细解析Python中函数参数传递的五种核心方式:位置传递、关键字传递、默认值传递、包裹位置参数(*args)及解包裹传递。通过具体代码示例,阐述各方式的语法特点、适用场景及注意事项,帮助开发者掌握灵活传参技巧,编写更健壮的Python代码。
本文深入解析Django模板系统的核心功能,涵盖ROOT_URLCONF配置、三种静态文件引入方式、模板导入与母版继承机制,以及通过自定义inclusion_tag返回HTML片段的完整步骤。通过具体代码示例,帮助开发者掌握页面布局复用与动态内容生成的最佳实践。
本文详细介绍如何使用Python实现英文字母与对应序数的双向转换。通过遍历字母表进行正向映射,以及利用split函数分割字符串实现逆向解析,提供了完整的代码示例。文章涵盖了从命令行输入处理到结果格式化的具体步骤,帮助开发者快速掌握这一基础字符串操作技巧。
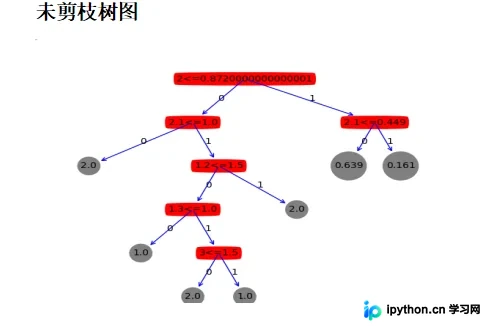
本文详细解析Python中决策树剪枝算法的实现。涵盖ID3算法基于信息熵的分裂逻辑,以及CART算法采用基尼指数进行二元划分的机制。通过完整代码示例,展示如何计算香农熵、处理连续变量划分,并实现预剪枝与后剪枝策略,帮助开发者掌握机器学习核心算法的底层实现。
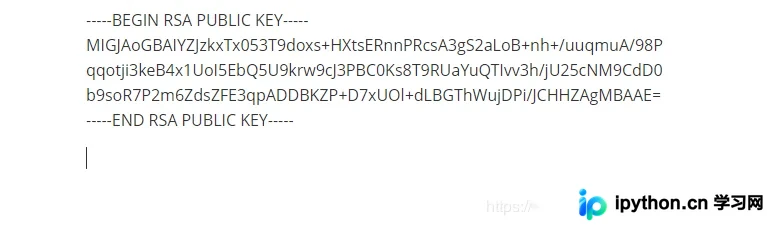
本文详细介绍如何使用Python的rsa库生成密钥对,实现数据的公钥加密私钥解密,以及API接口的私钥签名公钥验签功能。包含完整的安装步骤、核心代码实现及密钥保存方法,帮助开发者快速掌握RSA在Python中的应用。
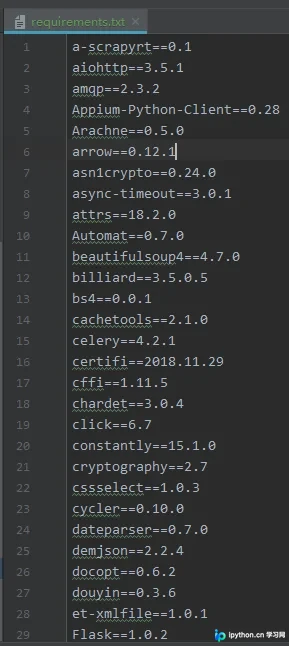
本文介绍在Python项目中生成requirements.txt文件的两种常用方法。第一种利用pip freeze命令,但需注意其会导出全局环境所有依赖,易造成冗余;第二种推荐使用pipreqs工具,它能智能分析代码实际导入的库,生成精简且准确的依赖列表,并支持指定编码和强制覆盖。
本文详细对比了Python2与Python3在进行网络爬虫开发时,使用urllib模块发起Get和Post请求的代码差异。重点解析了从urllib2到urllib.request的模块迁移,以及数据编码、请求构造和响应处理的具体实现方式,帮助开发者快速掌握版本升级后的代码适配方法。
本文详细解析Django中创建超级用户的完整流程,包括终端命令执行、交互式提示及密码输入注意事项。同时介绍如何在admin.py中注册模型以启用后台数据管理,并说明外键关联数据的自动处理机制,帮助开发者快速搭建后台管理系统。