

Python3调用腾讯云OCR接口提取图片文字完整指南
本文详解如何在Python3环境中使用腾讯云OCR服务提取图片文字。内容涵盖百度与腾讯OCR的效果对比、免费额度说明、账号注册与密钥申请流程,以及通过pip安装SDK和具体代码实现示例,帮助用户快速完成接口集成。
2026-10-13
10

本文详解如何在Python3环境中使用腾讯云OCR服务提取图片文字。内容涵盖百度与腾讯OCR的效果对比、免费额度说明、账号注册与密钥申请流程,以及通过pip安装SDK和具体代码实现示例,帮助用户快速完成接口集成。
本文介绍如何使用Python3实现字符串中单词的逆序排列,保持单词内部字母顺序不变。通过split和reverse方法,将句子按空格分割后反转列表,再重新拼接为字符串。
本文介绍Python中利用datetime模块进行日期与字符串相互转换的方法。通过strptime将格式化的字符串解析为datetime对象,再使用strftime将日期对象格式化为指定字符串。文章包含完整代码示例及类型输出说明,帮助开发者快速掌握时间处理技巧。
本文详细讲解Python中数组(列表)的并集、交集和补集计算方法。通过set集合转换、extend扩展及加减运算符,提供多种实现方式及完整代码示例,帮助开发者快速掌握列表去重与元素筛选技巧。
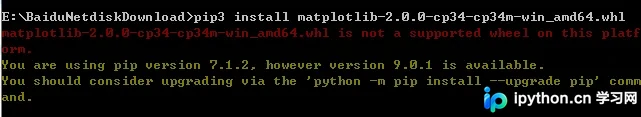
本文详细讲解在Python环境中通过pip3命令安装本地whl文件的具体步骤。针对安装过程中常见的“not a supported wheel on this platform”错误,提供了通过修改文件名中cp版本标识来解决的实用方案,帮助用户顺利完成第三方库部署。
本文介绍如何利用Python的re模块结合正则表达式来检测字符串中是否包含英文字母。通过编译匹配规则并遍历字符串,示例代码清晰展示了判断逻辑与输出结果,适用于需要处理文本内容的开发场景。
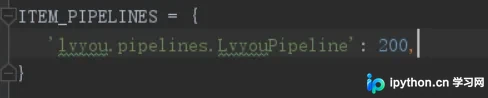
本文详细介绍 Scrapy 框架将数据持久化至 MySQL 数据库的两种核心方式:同步操作与基于 Twisted 的异步存储。文章涵盖 pipelines.py 配置、数据库连接池建立及错误处理机制,并针对中文乱码、特殊字符报错及重复数据累积问题提供具体解决方案,包括使用 pymysql.escape_string 和 scrapy-deltafetch 等插件实现增量爬取。
本文介绍在Python中处理不定长参数列表的方法。当面对长度未知的二维数组或列表集合时,直接传入zip函数会导致错误。通过利用解包操作符*,可以将列表中的元素作为独立参数传递给zip函数,从而实现对任意数量序列的并行迭代与组合。
本文解析Python中chardet库的字符编码检测原理,通过urllib请求网页并调用chardet.detect()方法,展示如何获取编码类型及置信度。通过对比手动识别与自动检测的差异,说明该库在简化编码处理流程中的实际应用价值。
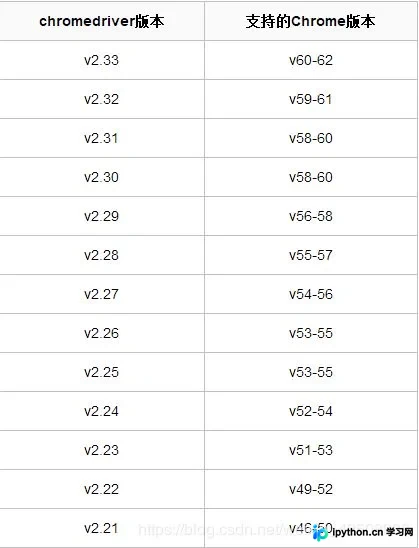
本文详解Selenium自动化测试中ChromeDriver找不到的常见原因及解决方案。重点介绍如何根据浏览器版本下载匹配的驱动,通过配置系统环境变量或直接在代码中指定executable_path路径来解决报错。针对即使配置环境变量仍报“cannot find Chrome binary”的情况,提供了具体的代码级路径指定方法,确保自动化脚本稳定运行。
本文详解Python中syslog模块的使用原理,涵盖openlog与syslog函数的参数配置,如ident、logoption及facility的设定。通过具体代码示例展示如何将日志输出至/var/log/messages,并提供一个封装好的mysyslog类,支持多种日志级别与选项,便于在实际项目中复用。

本文详细解析如何使用Python的pexpect库建立SSH连接至Linux服务器并执行远程命令。通过封装spawn、expect及sendcr等核心方法,实现自动处理密码输入与命令回显。代码包含完整的登录校验逻辑及文件列表查询示例,适用于需要自动化交互Linux环境的运维场景。