

Python enumerate() 函数详解:语法、参数与多类型应用实例
本文详细介绍 Python 内置函数 enumerate() 的核心功能与使用方法。该函数可将列表、元组或字符串等可遍历对象组合为索引序列,常用于 for 循环中。文章解析了 sequence 和 start 参数的具体作用,并通过包含列表、元组及字符串的多组代码实例,演示了默认索引与自定义起始索引的实际输出效果,帮助开发者高效处理数据遍历任务。
2026-10-14
6

本文详细介绍 Python 内置函数 enumerate() 的核心功能与使用方法。该函数可将列表、元组或字符串等可遍历对象组合为索引序列,常用于 for 循环中。文章解析了 sequence 和 start 参数的具体作用,并通过包含列表、元组及字符串的多组代码实例,演示了默认索引与自定义起始索引的实际输出效果,帮助开发者高效处理数据遍历任务。
本文详细解析Python中split()与rsplit()方法的原理、语法及参数设置。通过指定分隔符sep和分割次数count,可实现对字符串的精确切片。文章包含完整代码示例,展示默认分隔符行为及自定义分隔符下的左右分割差异,帮助开发者掌握字符串处理技巧。
本文详细解析 Python 中三种除法运算符 /、% 和 // 的具体行为。重点阐述 Python3 中 / 始终返回浮点数,而 // 执行向下取整的地板除逻辑;同时说明 % 用于计算余数。文章对比了 Python2 与 Python3 在整数除法上的版本差异,并通过具体代码示例展示正负数运算结果,帮助开发者准确掌握不同场景下的除法选择。
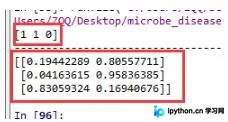
本文详细解析Python sklearn库中model.predict()与model.predict_proba()函数的核心区别。通过LogisticRegression示例代码,展示predict返回具体分类标签,而predict_proba返回各类别的概率分布。文章深入探讨了多分类场景下的概率输出逻辑,并解释了predict_proba结果如何依据self.classes_进行排序,帮助开发者准确理解模型输出格式。
在Keras与TensorFlow混编场景下,直接设置模型层的trainable=False属性往往无法阻止优化器更新权重。本文通过引入tf.variable_scope区分变量作用域,利用tf.get_collection筛选特定作用域内的可训练变量,并在优化器中通过var_list指定更新范围,从而有效解决该兼容性问题。
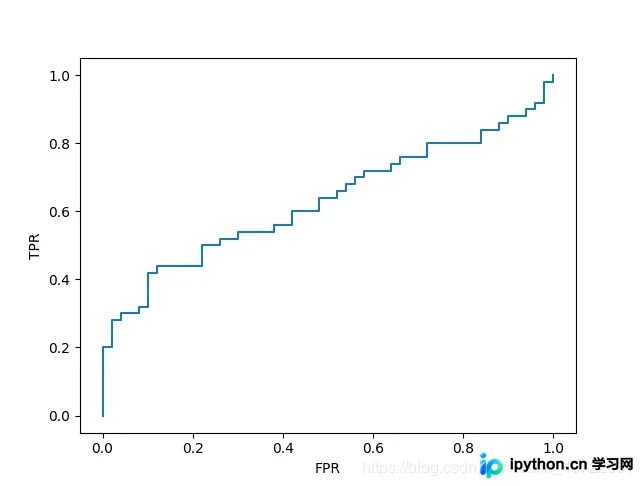
本文详细解析如何使用Python绘制ROC曲线。以鸢尾花数据集为例,通过回归拟合获取概率值,对测试数据进行排序,并基于TPR和FPR公式计算真阳性率与假阳性率。文章涵盖从数据预处理、模型预测到最终绘图的全过程,帮助读者理解分类模型的性能评估方法。
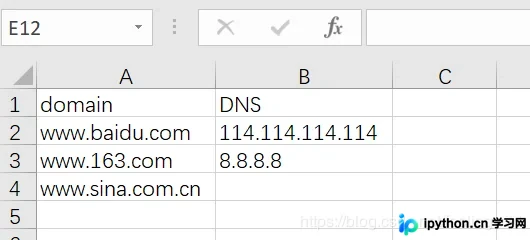
本文介绍如何使用Python脚本批量执行nslookup命令,实现多域名与多DNS服务器的组合解析。通过读取CSV文件获取域名和DNS列表,利用subprocess调用系统命令并解析返回结果,最终将解析数据保存为CSV文件,便于后续查看与分析。
本文详细介绍Python turtle库中画笔与运动控制的核心函数。涵盖抬起/落下画笔、设置画笔粗细与颜色(支持字符串及RGB值)、控制前进距离、绘制圆弧以及调整海龟方向等关键操作。结合蟒蛇绘制示例代码,解析setup、pensize、pencolor、circle及seth等函数的具体用法与参数含义,帮助开发者快速掌握基础绘图技巧。
本文详解sklearn中predict与predict_proba的区别:前者返回预测标签,后者返回各类别概率数组。重点指出当训练集缺失某些类别时,predict_proba列数会减少,导致predict结果与最大概率索引不一致。建议使用train_test_split的stratify参数保持数据分布一致,避免此类隐蔽Bug。
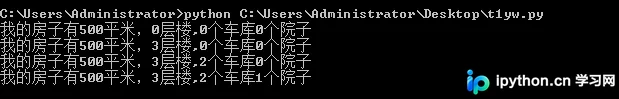
本文通过Python3代码示例详细解析建造者模式。该模式用于创建复杂对象,将创建过程与使用解耦。文章以建房子为喻,展示了House、HouseBuilder、Foreman和User类的实现,说明了如何通过指挥者协调多个步骤来构建对象,同时保持用户接口的简洁。
本文介绍利用Python内置fileinput模块实现文件内容的原地修改与写回,通过inplace参数避免繁琐的临时文件操作。同时提供两种在字符串中查找子串起始位置的Python实现代码,涵盖手动遍历与split分割法,适用于文本处理场景。
本文详细解析Python Pandas库中inplace参数的作用。当inplace设为True时,直接修改原对象且不返回新对象;设为False(默认值)时,创建并返回包含修改结果的新对象。文章通过代码示例对比两种情况,并指出该参数仅接受布尔值,传入整数会引发ValueError。