Python命令行参数定义及注意事项:argparse使用详解
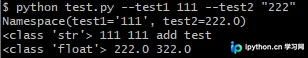
本文详细介绍Python中利用argparse库定义和获取命令行参数的方法。涵盖参数命名、类型转换、默认值设置及帮助信息输出等核心功能,并指出定义顺序的重要性。此外,通过实验验证了numpy数组在命令行传参时的局限性,帮助开发者避免常见错误。
2026-10-14
7

本文详细介绍Python中利用argparse库定义和获取命令行参数的方法。涵盖参数命名、类型转换、默认值设置及帮助信息输出等核心功能,并指出定义顺序的重要性。此外,通过实验验证了numpy数组在命令行传参时的局限性,帮助开发者避免常见错误。
本文针对Python初学者及数据需求者,梳理了主流爬虫工具。重点对比了云爬虫与本地采集器的区别,并详细解析了神箭手、八爪鱼和集搜客GooSeeker三大工具的核心功能与优势,涵盖自动化、可视化操作及反爬技术,助力高效获取网页数据。
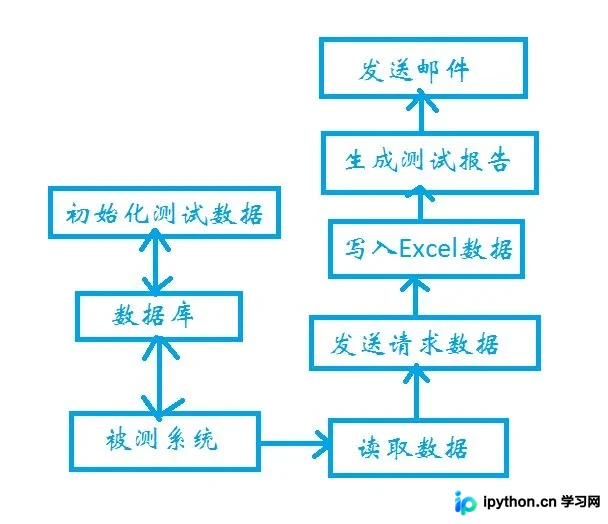
本文深入解析基于Python3、Selenium3、Unittest及DDT的接口自动化测试框架。针对开源工具在数据控制、加密接口及扩展性上的不足,详细阐述了从数据库初始化、Excel用例读取、请求发送、结果比对到报告生成的完整处理流程,并介绍了包含配置、核心模块及测试用例的标准目录结构。
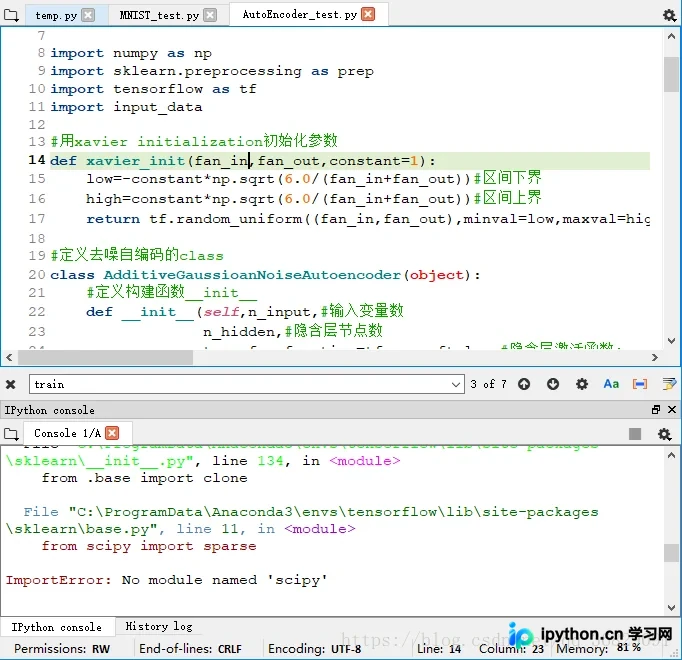
本文详细解决Python运行时报错no module named sklearn的问题。介绍通过pip install命令直接安装,以及在Anaconda/Spyder环境中使用conda activate激活环境后安装sklearn的方法。同时提供解决pip安装超时Read timed out错误的技巧,确保scikit-learn及相关依赖顺利部署。
本文详解Python标准库logging的高级用法,包括通过自定义Filter类添加server、ip等自定义字段,以及利用colorlog库实现控制台日志的彩色分级显示。提供完整代码示例,涵盖日志格式配置、文件轮转及颜色映射,帮助开发者优化日志可读性与调试效率。
本文介绍如何在Django项目中利用count()方法实现数据计数功能。通过修改apiviews.py获取统计值,并在apitest_manage.html模板中渲染展示,完成从后端逻辑到前端页面的完整数据展示流程。
本文详细解析利用 Python 爬取微信公众号文章的完整流程。通过 Selenium 模拟登录获取 Cookie 和 Token,结合 Requests 调用 searchbiz 与 appmsg 接口,提取 fakeid 并批量抓取文章数据。文中提供关键代码示例,并强调设置请求延迟以避免账号封禁的风险,适合希望掌握微信生态数据抓取技术的开发者参考。
本文介绍Python爬虫在遇到登录验证(如验证码、拖拽)时的两种主流解决方案:Cookie注入与模拟登录。通过获取浏览器Cookie并利用requests库复用会话,可绕过多数验证机制;同时简述基于requests的模拟登录思路。文中包含完整代码示例,展示如何配置代理、设置Cookie及处理登录状态,帮助开发者高效解决登录墙问题。
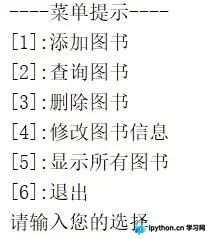
本文提供基于Python的图书管理系统完整代码,涵盖添加、查询、删除、修改及显示功能。系统采用TXT文件存储数据,支持按书名模糊查找并处理重复ID校验,适合Python初学者参考学习。
本文分享一个基于Python的猜拳游戏实现,利用openpyxl库将游戏过程、双方出拳及结果实时写入Excel文件。项目支持多用户独立Sheet管理,自动识别老玩家并显示历史积分,具备输入格式化、胜负判定及积分扣减机制,适合Python初学者学习文件操作与逻辑控制。
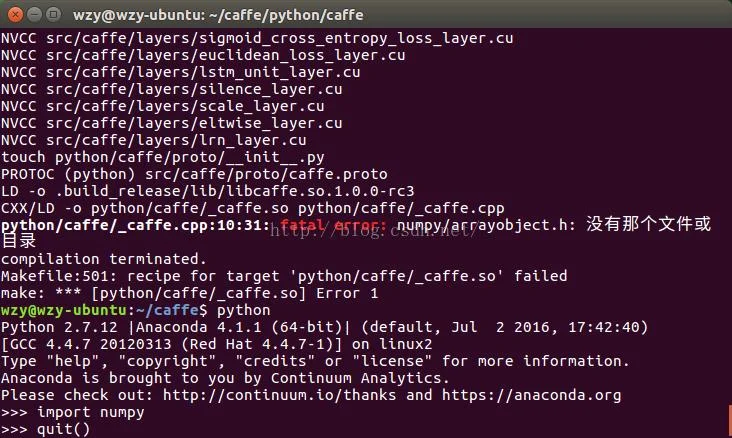
本文介绍编译pycaffe时遇到fatal error: numpy/arrayobject.h错误的解决方法。通过安装python-numpy模块或修正Makefile.config中PYTHON_INCLUDE路径,将/usr/lib改为/usr/local/lib即可解决该头文件缺失问题。
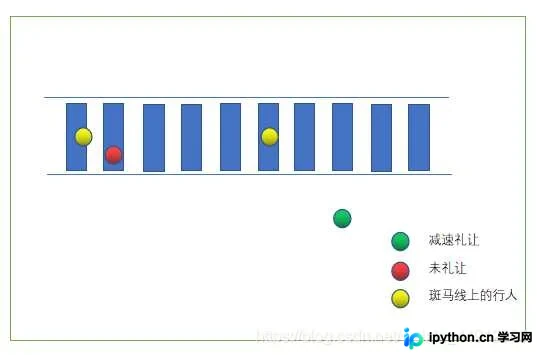
本文介绍利用Python和OpenCV进行斑马线检测的完整流程,涵盖灰度转换、高斯滤波、阈值处理及形态学操作。通过轮廓检测与感兴趣区域(ROI)筛选,实现斑马线定位,并结合车辆与行人坐标信息,探讨机动车礼让行行为的判定逻辑,为交通场景分析提供基础技术方案。