

Python制作简单的网页爬虫
本文演示如何使用Python的requests库与正则表达式编写一个简单的网页爬虫,用于批量抓取特定省份主要城市的历史天气信息。通过解析HTML结构、构造请求URL并遍历输出结果,仅需数十行核心代码即可完成基础数据采集。同时提供运行环境配置、编码处理优化及性能瓶颈说明,适合Web开发入门者参考学习。
2026-10-12
21

本文演示如何使用Python的requests库与正则表达式编写一个简单的网页爬虫,用于批量抓取特定省份主要城市的历史天气信息。通过解析HTML结构、构造请求URL并遍历输出结果,仅需数十行核心代码即可完成基础数据采集。同时提供运行环境配置、编码处理优化及性能瓶颈说明,适合Web开发入门者参考学习。
本文详细解析 Python 标准类型中的常用内建函数,重点对比 type()、str() 与 repr() 的核心差异。结合 Python 3 现代运行环境,提供类型检测、文本转换与调试快照的正确操作步骤,帮助开发者避开历史语法陷阱并提升编码效率。
本文详细对比 Python 中字典赋值、浅拷贝与深拷贝的实际行为差异,重点说明嵌套可变对象在内存中的引用关系,并讲解如何利用 __name__、__file__ 和 __doc__ 获取模块运行状态与路径信息,帮助开发者避免数据意外污染并规范脚本结构。
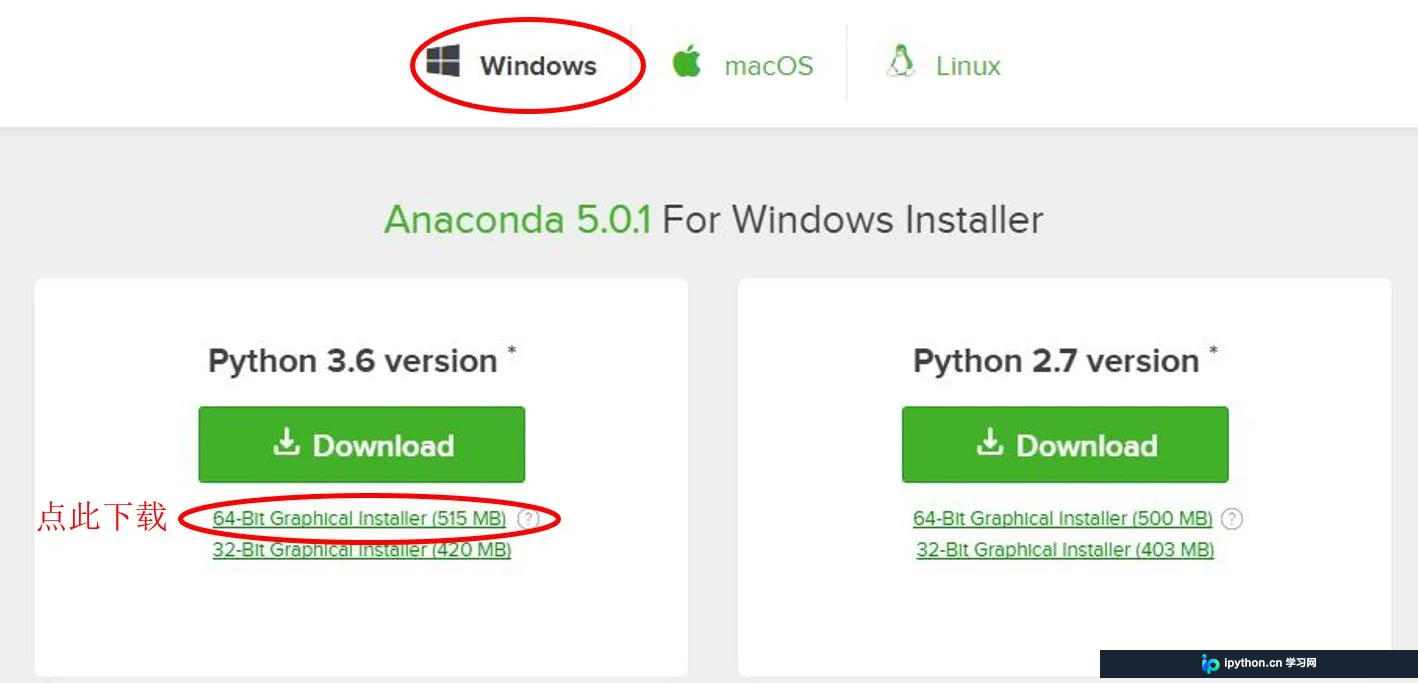
本文详细讲解在Windows系统中安装和配置Anaconda与PyCharm的步骤。从下载、安装到环境管理,再到IDE的配置与项目创建,提供完整的操作指南,帮助用户快速搭建Python开发环境。
本文详解如何通过HTML表单配合jQuery实现文件异步上传,并在Django后端通过request.FILES安全接收二进制流、分块写入磁盘并以UUID重命名。内容涵盖关键参数配置、路由对接要点及常见报错排查,适用于各类Web项目的附件传输场景。
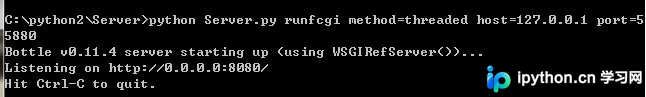
本文详解在Windows系统中配置Nginx前置代理、Python后端运行及MySQL数据库的完整流程。涵盖核心依赖安装、Nginx反向代理参数编辑、FastCGI服务启动验证及安全配置优化方法,提供可直接复用的命令行操作与路由配置方案。
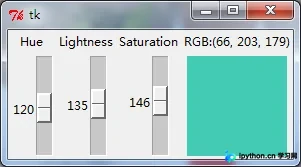
本文介绍如何利用Python内置的tkinter与colorsys模块,编写一个基于图形界面的颜色空间转换工具。通过滑动条实时调整色调、亮度与饱和度参数,程序会自动计算并输出对应的RGB数值及可视化色块,帮助开发者快速掌握基础GUI布局与颜色坐标映射逻辑。
本文详细讲解 Python 中字典、元组、列表与字符串之间的常用转换方法。通过标准内置函数实现基础结构互转,补充了使用 ast.literal_eval 安全解析字符串的最佳实践,并指出不可直接转换的限制条件,帮助开发者快速处理数据格式转换需求。
本文系统梳理Python标准库datetime模块的核心类与操作方法。通过实际代码演示date、time与datetime对象的创建、时间间隔计算(timedelta)、strftime格式化处理以及字符串与时间戳的双向转换流程,帮助开发者高效掌握Python中的日期时间处理技巧。
本文演示如何使用现代Python工具编写网页爬虫,以豆瓣电影Top100为例,讲解构建URL地址池、伪造请求头、利用BeautifulSoup稳定解析HTML结构,并将提取到的电影名称与相关图片安全保存至本地。全文已修复原代码的版本缺陷,提供更可靠的执行逻辑与反爬规避建议。
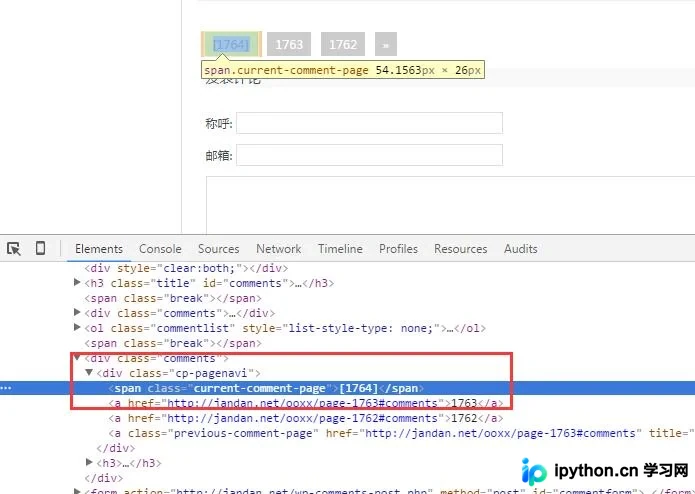
本文介绍如何使用Python编写网页图片批量抓取脚本。通过定位页码信息、利用正则表达式解析HTML获取目标链接,结合设置代理服务器与自定义请求头绕过基础拦截,最终将图片按原文件名保存至本地。文中附带完整请求封装代码及IP阻断、超时等常见问题的排错方案。
本文针对Python开发中频繁出现的UnicodeDecodeError错误,梳理字符集编码的核心逻辑。通过对比字节串与文本对象的区别,解析终端默认编码引发的隐式转换问题,并提供环境变量配置与显式编解码的最佳实践,帮助开发者彻底掌握跨平台文本处理技巧。