

Python编写网页图片批量下载脚本与反爬应对

本文介绍如何使用Python编写网页图片批量抓取脚本。通过定位页码信息、利用正则表达式解析HTML获取目标链接,结合设置代理服务器与自定义请求头绕过基础拦截,最终将图片按原文件名保存至本地。文中附带完整请求封装代码及IP阻断、超时等常见问题的排错方案。
Python实现图片批量抓取的执行逻辑与准备
编写自动化抓取脚本通常遵循“获取列表信息 → 解析目标元素 → 发起下载请求 → 落地存储”的标准路径。以特定图文板块为例,程序需要先读取最新页码,向前遍历每一页的源代码,从中匹配出图片的真实访问链接,最后定向写入本地文件夹。由于多数平台具备基础的频率检测机制,直接裸跑请求极易触发服务端拦截,因此需在初始化阶段同步构建携带标准浏览器标识的HTTP客户端。
第1步:定位动态页码索引
页面导航区域通常会标注当前所处的分页节点。通过观察源码DOM结构,可利用正则表达式精准捕获该数值,作为后续循环下载的起始基准。提取成功后,即可根据页码倒序或顺序生成待抓取的目标URL。
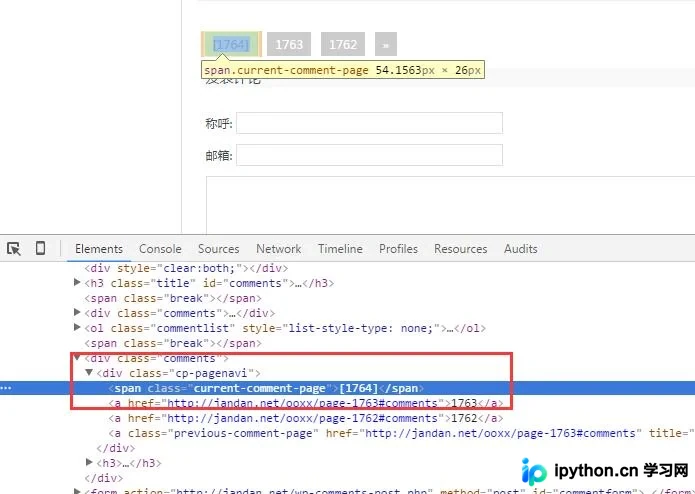
def __getNewPage(self):
    pageCode = self.Get(self.__Url)
    # 匹配当前评论/分页页码标识
    pattern = re.compile(r'<div .*?cp-pagenavi">.*?<span .*?current-comment-page">\[(.*?)\]</span>', re.S)
    newPage = re.search(pattern, pageCode)
    if newPage:
        return newPage.group(1)
    # 页码解析失败时的安全回退值
    return 1500
第2步:匹配单页全部资源链接
锁定有效页号后,拼接对应分页路径再次请求。在返回的文本流中,目标图片标签往往包裹在特定的父级容器内。编写非贪婪模式的匹配规则可高效提取完整路径,避免截断或引入干扰字符。
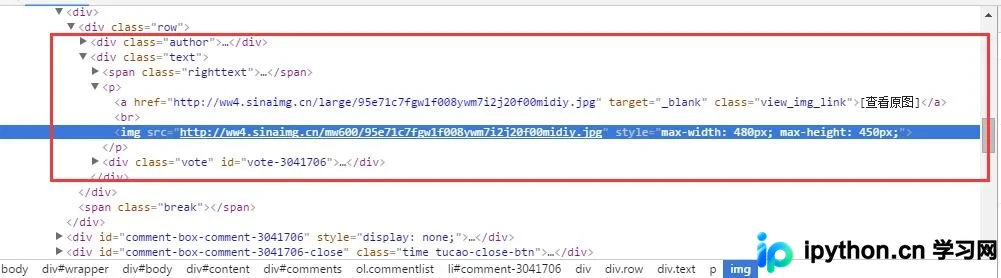
def __getAllPicUrl(self, pageIndex):
    realurl = self.__Url + "page-" + str(pageIndex) + "#comments"
    pageCode = self.Get(realurl)
    # 提取包裹在段落内的图片源地址
    pattern = re.compile('<p>.*?<a .*?view_img_link">.*?</a>.*?<img src="(.*?)".*?</p>', re.S)
    items = re.findall(pattern, pageCode)
    self.__savePics(items, self.__floder)
第3步:构建带代理的请求容器
频繁发起同频道的GET请求会迅速消耗信誉配额,服务端可能直接切断连接。此时程序将无法继续拉取数据,控制台日志常表现为获取到空内容或异常状态。解决方案是接入外部代理节点,并在请求管道中注入标准的User-Agent与Cookie管理机制。同时适当放宽Socket超时阈值,防止网络波动导致的中途断开。
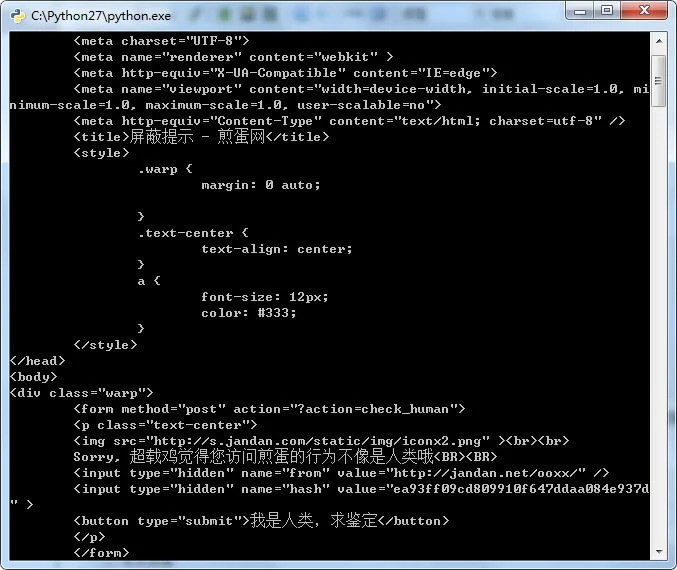
底层通信类需兼顾Header伪装、gzip解压校验与错误降级处理。以下为适配现代运行环境的封装示例:
import urllib.request, http.cookiejar, socket, zlib, io

class HttpClient:
    def __init__(self):
        self.__cookie = http.cookiejar.CookieJar()
        # 按需替换为稳定可用的出口节点
        proxy_handler = urllib.request.ProxyHandler({"http": "http://42.121.6.80:8080"})
        opener = urllib.request.build_opener(
            urllib.request.HTTPCookieProcessor(self.__cookie),
            proxy_handler
        )
        opener.addheaders = [
            ('Accept', 'application/javascript, */*;q=0.8'),
            ('User-Agent', 'Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.1; WOW64; Trident/5.0)')
        ]
        urllib.request.install_opener(opener)

    def Get(self, url, refer=None):
        try:
            req = urllib.request.Request(url)
            if refer:
                req.add_header('Referer', refer)
            response = urllib.request.urlopen(req, timeout=120)
            html = response.read()
            gzipped = response.headers.get('Content-Encoding')
            if gzipped == 'gzip':
                html = zlib.decompress(html, 16+zlib.MAX_WBITS)
            return html.decode('utf-8', errors='ignore')
        except urllib.error.HTTPError as e:
            return e.read().decode('utf-8', errors='ignore')
        except (socket.timeout, socket.error):
            return ''

    def Download(self, url, filepath):
        urllib.request.urlretrieve(url, filepath)
第4步:统筹调度与文件落盘
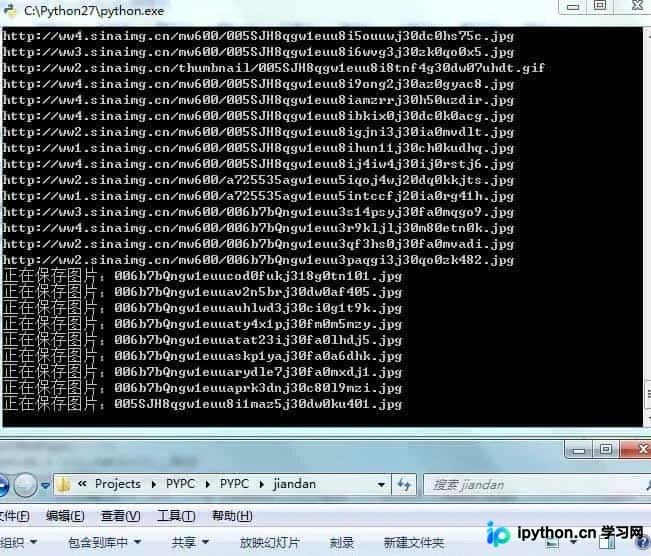
将网络获取的二进制流按原始后缀命名写入新建的缓存目录。若目录已存在则切换工作路径继续追加,未找到新页码标记时启用安全回退值终止循环。完整的主控类需继承上述通信层,串联页码推算、链接过滤与磁盘写入动作。
import sys, os

class JianDan(HttpClient):
    def __init__(self):
        self.__pageIndex = 1500
        self.__Url = "http://jandan.net/ooxx/"
        self.__floder = "jiandan"

    def __savePics(self, img_addr, folder):
        for item in img_addr:
            filename = item.split('/')[-1]
            print("正在保存图片:" + filename)
            self.Download(item, filename)

    def start(self):
        if not os.path.exists(self.__floder):
            os.mkdir(self.__floder)
        os.chdir(self.__floder)

        page = int(self.__getNewPage())
        # 按页码区间遍历抓取
        for i in range(self.__pageIndex, page):
            self.__getAllPicUrl(i)

if __name__ == '__main__':
    jd = JianDan()
    jd.start()
运行验证与常见排错指引
程序跑通后,可通过检查目标文件夹内的文件大小与数量确认抓取结果。若遇到以下状况,可按对应方向排查:
- 请求被拒或持续返回空字节:当前代理节点失效或处于高负载状态。更换优质IP段,并将
timeout参数调至150以上。 - 编码报错(UnicodeDecodeError):部分站点未统一声明字符集。可在解码前强制指定
utf-8或使用errors='ignore'跳过非法字节。 - IO阻塞或进度停滞:批量写入大体积图像时建议在循环内加入延时器(如
time.sleep(1)),降低对源站压力的同时提升自身队列稳定性。
总结
以上就是使用Python进行网页图片批量抓取脚本编写的详细内容,更多关于Python网络爬虫开发与反爬应对技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









