

Python自定义JSON序列化库实现:解决跨语言反序列化难题
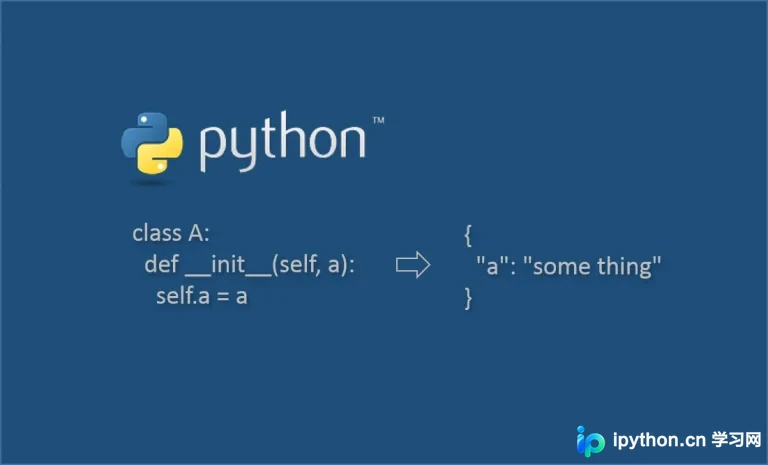
本文探讨Python中自定义对象JSON序列化的痛点,对比标准库与第三方库的局限,提出一种无需侵入代码即可实现任意对象序列化的方案。该方案通过内省机制自动识别属性,支持嵌套类反序列化及属性缺失时的默认值处理,完美解决跨语言通信中类型信息缺失导致的反序列化失败问题。
2026-10-12
24

本文探讨Python中自定义对象JSON序列化的痛点,对比标准库与第三方库的局限,提出一种无需侵入代码即可实现任意对象序列化的方案。该方案通过内省机制自动识别属性,支持嵌套类反序列化及属性缺失时的默认值处理,完美解决跨语言通信中类型信息缺失导致的反序列化失败问题。
本文介绍如何在Django项目中安全地将App名称及对应的数据库表名从大写改为小写。通过生成批量SQL语句直接修改MySQL表名,并配合修改代码中的模型引用、URL配置及Settings设置,实现无需执行Django migrate命令即可完成名称变更,确保ORM映射正确。
本文整理了2020版Python学习路线图,针对零基础开发者梳理从入门到就业的学习路径。Python凭借丰富的类库广泛应用于Web开发、运维、大数据及人工智能领域。文章提供了高清路线图获取方式及配套视频教程领取方法,帮助初学者避开常见误区,快速掌握Python核心技能。
本文介绍使用Python结合Selenium和TinyPNG接口实现图片批量无损压缩的方法。通过优化上传时机、采用多线程下载及遍历本地文件夹策略,显著提升处理效率。代码包含基础版与改进版,重点解决网络加载等待与并发下载问题,适用于Android项目等资源文件的自动化压缩场景。
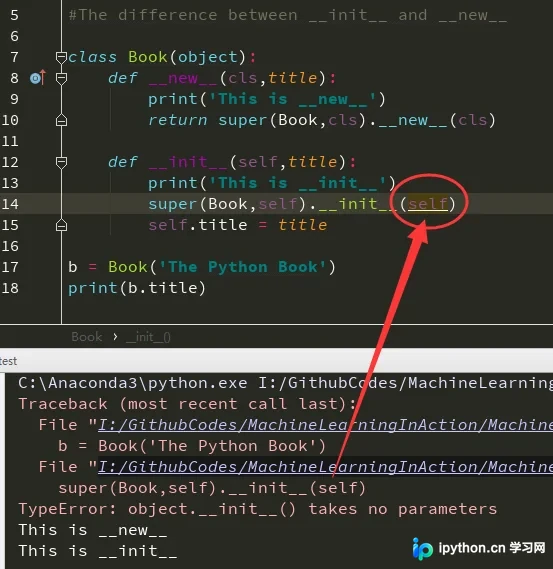
本文详细解析Python中__new__与__init__两个特殊方法的执行顺序与核心区别。__new__作为类级别的静态方法,负责创建并返回实例对象;__init__作为实例级别的方法,负责初始化已创建的实例。通过继承int等不可变类的示例,展示如何重载__new__实现自定义实例化逻辑,帮助开发者理解对象创建机制。
本文详解Python爬取动态网页的两种主流方案:Dryscrape与Selenium。重点讲解Selenium在Ubuntu下的安装步骤,包括geckodriver的下载与路径配置,以及解决Firefox版本兼容性问题。通过代码示例演示如何调用浏览器引擎获取JS执行后的页面源码,并解决常见报错,如模块调用错误及元素定位方法。
本文介绍 Python 中高效处理数据的五种常用技巧。涵盖利用列表推导式和 filter 筛选序列、使用 zip 翻转字典键值、借助 Counter 统计元素频度、通过 sorted 和 zip 对字典按值排序,以及利用 reduce 和集合运算查找多字典公共键。结合具体代码示例,帮助开发者提升数据处理效率。
本文系统梳理Python常用模块与函数,涵盖文件目录增删改查、基于time和datetime的时间处理、利用os.system与subprocess模块调用外部程序(如wget)的方法,以及结合pytest实现多线程自动化测试的技巧,提供完整代码示例与注意事项。
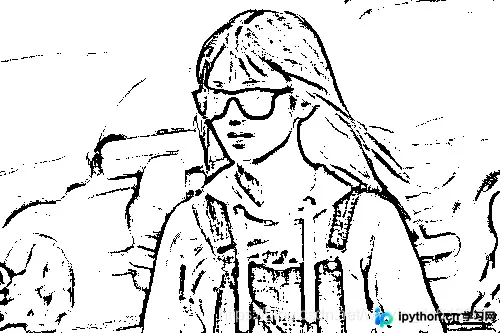
本文介绍使用Python和OpenCV库实现图片漫画风格特效的方法。通过灰度化、中值滤波及自适应阈值二值化提取轮廓,利用图像金字塔降分辨率结合双边滤波简化色彩,最后通过位‘与’运算合并轮廓与颜色,生成具有手绘感的漫画图像。
本文介绍如何利用Python构建一个可视化的大数据预测集成工具。通过整合sklearn进行多元回归模型训练,结合Tkinter开发GUI界面,实现了从数据读取、模型拟合到预测结果可视化的完整流程。工具支持手动输入与文件批量预测,旨在简化大数据预测的应用门槛,提供直观的决策辅助。
本文深入解析Python标准库collections中的核心容器类型。通过namedtuple实现可读性更强的元组,利用defaultdict避免KeyError并简化字典操作,借助Counter高效统计元素频次,以及使用deque实现高性能的双端队列操作。涵盖各类型的创建、常用方法及实际应用场景,帮助开发者减少重复代码,提升编程效率。
本文分享 Python 编程中的三个实用技巧。首先,通过重写 __repr__ 方法或使用 __dict__ 属性,将默认的对象内存地址输出转化为更易读的字符串形式。其次,利用 json 模块的 dumps 方法结合对象的 __dict__,快速将自定义类实例序列化为格式化的 JSON 字符串。最后,演示如何使用 lambda 表达式对包含自定义对象的列表进行多级排序,支持按单一字段或组合字段(如先名字后键值)进行升序排列,提升数据处理效率。