

Python多条件数据筛选:filter、pandas与循环实现对比
本文详解Python中实现多条件数据筛选的三种方法:内建filter函数、pandas库及普通循环。通过词性标注示例对比代码实现与运行结果,指出filter与pandas在速度上更具优势,适合高效处理结构化数据。
2026-10-13
21

本文详解Python中实现多条件数据筛选的三种方法:内建filter函数、pandas库及普通循环。通过词性标注示例对比代码实现与运行结果,指出filter与pandas在速度上更具优势,适合高效处理结构化数据。
本文介绍了一个基于Python的小型爬虫系统实现,涵盖URL管理、HTML下载、解析及输出模块。通过正则表达式提取链接,利用BeautifulSoup解析文本内容,并支持将抓取结果保存为HTML表格或TXT文件。代码展示了从初始URL到批量文档下载的全流程,适合Python初学者理解爬虫架构与核心逻辑。
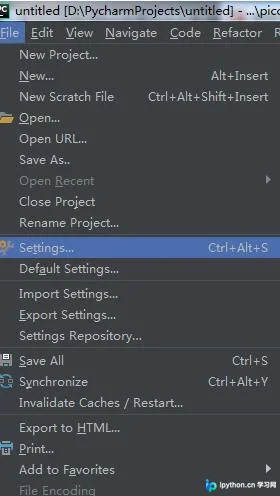
本文详细介绍在PyCharm中通过Project Interpreter安装Python包的完整流程。从点击File->Settings进入设置,到使用绿色加号添加新包,再到输入包名执行Install Package,最后提供查看已安装包的具体目录路径。适用于希望快速掌握PyCharm依赖管理的新手用户,确保模块正确安装并可在项目中调用。
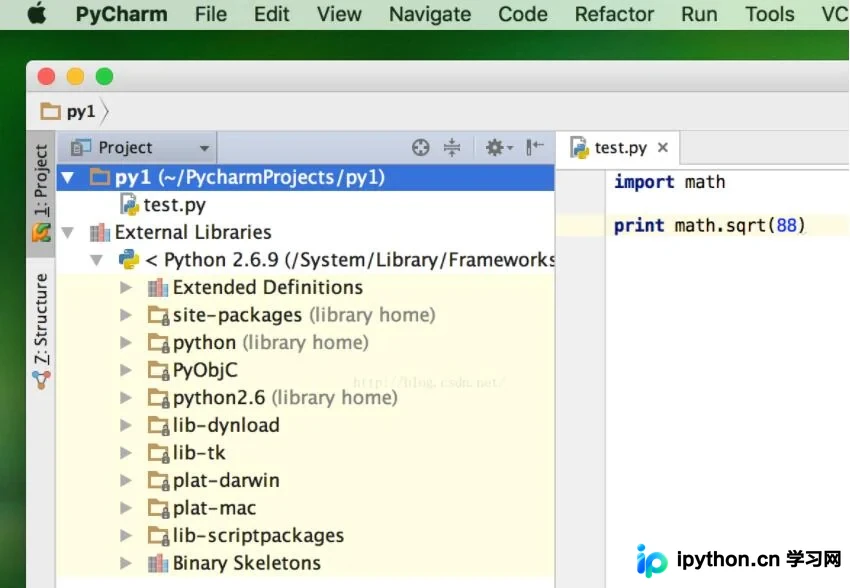
本文介绍在macOS系统中,当PyCharm默认使用旧版Python(如2.6)时,如何手动切换至系统自带的Python 2.7版本。通过检查系统已安装的Python版本,并在PyCharm的项目解释器设置中指定正确的解释器路径,完成External Libraries的配置,确保第三方库正常加载。
本文介绍利用Python和BeautifulSoup4技术,从足球直播吧网站抓取五大联赛积分榜数据的完整流程。通过解析HTML结构并处理URL请求,实现对各联赛排名信息的自动化采集,为数据分析提供基础素材。
针对淘宝、京东等动态加载网站,直接请求无法获取完整数据。本文介绍如何在Scrapy框架中通过中间件集成Selenium,利用无头浏览器模拟滚动和交互,获取渲染后的完整HTML源码,并构造HtmlResponse对象直接返回,从而绕过传统下载器,实现高效的数据抓取。
本文介绍使用Python3结合pymysql库,通过逐行读取方式将本地大容量JSON文件高效写入MySQL数据库的方法。针对3.55GB级别的yelp评论数据,该方案避免内存溢出,解决文本文件存储导致的字符错乱问题,提供完整的建表与插入代码示例。
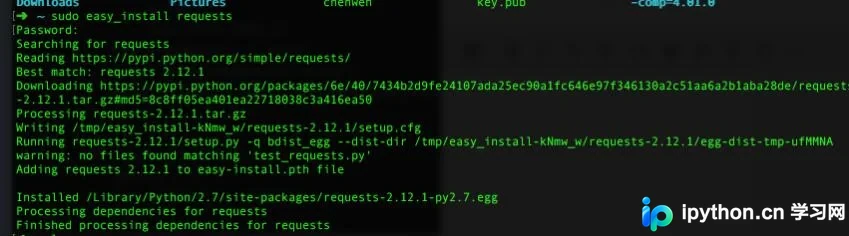
本文介绍在macOS系统中安装Python网络请求库requests的方法。通过执行sudo easy_install requests命令,用户可快速完成安装。安装成功后,即可在Python项目中正常使用requests进行网络请求操作。
本文介绍在Mac系统中通过Homebrew安装Python 3后,利用自动生成的pip3工具快速安装requests和Scrapy第三方库的方法。文章简要说明了从Python 2过渡到Python 3的需求,并提供了具体的命令行安装步骤,帮助用户解决Mac环境下Python库配置问题。
本文解决在Mac系统(如OSX 10.11及更高版本)中安装Python爬虫框架Scrapy时遇到的“Operation not permitted”错误。该问题通常由旧版Python(如2.7)与新系统权限机制冲突导致,通过升级Python版本即可有效解决。
本文详细介绍在Python中调用Linux Shell命令的几种常用方法,包括os模块的exec、system和popen,commands模块,以及推荐的subprocess模块。通过对比各方法的返回值处理、灵活性及适用场景,帮助开发者选择最适合的调用方式,并提供了具体的代码示例和注意事项。
本文针对CentOS6.x系统升级Python至3.5版本后出现的pip命令失效及插件导入报错问题,提供了详细的排查与修复步骤。通过验证Python版本、检查/usr/local/bin目录下的pip链接,并明确使用pip3.5进行插件安装,成功解决了程序运行时的ImportError错误。