

朴素贝叶斯分类算法原理详解与Python实战代码
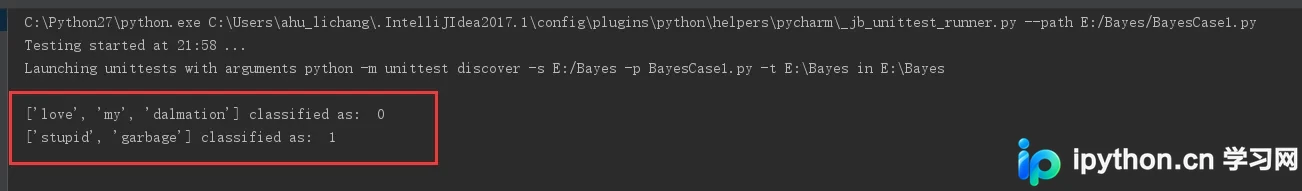
本文深入解析朴素贝叶斯分类算法的核心原理,包括条件概率独立性假设与贝叶斯公式应用。通过电商评论情感分析案例,演示从特征提取到概率计算的完整流程,并提供Python代码实现,帮助开发者掌握该算法在文本分类中的实际使用方法。
2026-10-13
21

本文深入解析朴素贝叶斯分类算法的核心原理,包括条件概率独立性假设与贝叶斯公式应用。通过电商评论情感分析案例,演示从特征提取到概率计算的完整流程,并提供Python代码实现,帮助开发者掌握该算法在文本分类中的实际使用方法。
本文深入解析pandas中merge函数的默认行为及参数控制。默认merge执行内连接(inner),仅保留键的交集;通过设置how='outer'可执行外连接(outer),保留所有键并填充NaN。文章通过具体代码示例展示了如何处理键值匹配、笛卡尔积扩展及缺失值填补,帮助开发者掌握不同场景下的数据合并策略。
本文详解Python中sum函数的用法,包括参数iterable和start的作用。通过解析计算差值平方和的代码案例,深入讲解sum与列表推导式的结合使用,帮助读者理解简洁高效的Python语法技巧。
本文介绍一种在 Python 3.x 中实现列表降维(扁平化)的实用技巧。通过将嵌套列表转换为字符串,移除所有方括号后重新解析为列表,可快速将多维结构展平为一维。该方法适用于结构简单的场景,代码简洁直观,适合初学者参考。
本文介绍在Python中对多个长度相同的列表进行对应元素求和的三种实现方式。首先通过定义函数遍历相加,其次利用NumPy库直接执行数组加法,最后使用NumPy的sum函数配合axis参数实现纵向求和。文章对比了各方法的代码实现及返回数据类型差异,为数据处理提供实用参考。
本文介绍在Python中查找第n个子串的方法。通过嵌套调用find或index,利用起始位置加1实现连续查找。重点对比find返回-1与index抛出异常的差异,强调find的健壮性。文章还解析了字符串切片左闭右开特性及递归实现逻辑,助开发者高效处理复杂字符串匹配场景。
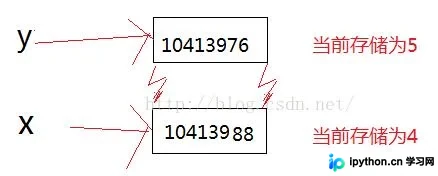
本文深入解析Python中变量在内存中的分配原理。通过id()函数查看内存地址,揭示Python变量本质为指向对象的指针。对比C语言中变量地址固定与值可变的特点,阐明Python中“不可变对象”与“可变引用”的区别。同时探讨小整数缓存机制及大整数内存分布规律,帮助开发者理解Python内存管理的底层逻辑。
本文通过具体代码实例,详细演示了Python中字符串(str)、列表(list)和集合(set)之间的相互转换方法。内容涵盖利用list()、set()及join()函数实现类型互转的具体操作,并解析了转换过程中的去重与无序特性,为开发者提供实用的类型处理参考。
本文介绍利用Python的xlrd库读取Excel文件,通过遍历工作表、提取特定列数据并进行正则表达式处理,实现两个表格内容的自动化对比。脚本包含分支检查、计数统计及结果输出功能,适用于系统运维、安全管理等领域的合规性数据比对场景。
本文介绍了Python中在数组或字典内查找特定值的三种算法实现。第一种为随机索引遍历法,第二种为从末尾开始的线性查找,第三种为基于递归的二分查找策略。文章提供了对应的Python代码示例,展示了不同思路下的具体实现方式。
本文介绍如何利用 NumPy 的 argpartition 函数高效寻找数组中最大的前 K 个元素。通过示例代码展示具体实现步骤,无需全排序即可定位目标值,适用于大数据量下的性能优化场景。
本文介绍在Python中如何统计List和NumPy数组内特定数值的出现次数及定位其索引。List可通过count()获取个数、index()获取首个位置;NumPy则利用np.sum()结合布尔判断统计个数,使用np.where()获取所有匹配元素的索引坐标,适用于数据清洗与算法开发场景。