

Python比较两个字符串是否相同的实例解析
本文介绍在Python中比较两个字符串是否相同的方法。通过实例分析ord()函数处理多字符时的限制,展示利用切片技术逐个提取字符并比较其整数编码的实现方式,帮助初学者理解字符串处理细节。
2026-10-13
21

本文介绍在Python中比较两个字符串是否相同的方法。通过实例分析ord()函数处理多字符时的限制,展示利用切片技术逐个提取字符并比较其整数编码的实现方式,帮助初学者理解字符串处理细节。
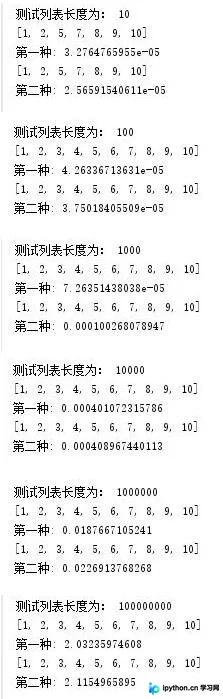
本文对比了Python中两种常见的列表去重方式:set()与{}.fromkeys().keys()。测试表明,在列表长度较短(小于1000)时,fromkeys方法速度更快;而当列表长度超过1000时,set()方法优势显著。文章提供了具体的测试代码与结果分析,并针对大规模数据处理给出了工具选择建议。
本文深入解析Python3中zip()函数的核心机制,重点说明其作为迭代器仅能访问一次的内存优化特性,对比Python2的差异。详细演示单参数、多参数及矩阵场景下的用法,包括列表推导式实现矩阵加减点乘,以及利用*zip进行数据解包还原的方法,帮助开发者避免常见错误并高效处理多维数据。
本文介绍利用Python去除文件中重复行的方法。通过定义空列表存储已出现行,遍历文件时判断是否重复,若重复则记录行号及内容至新文件,否则加入列表。该方案可有效识别并导出重复数据,适用于文本清洗场景。
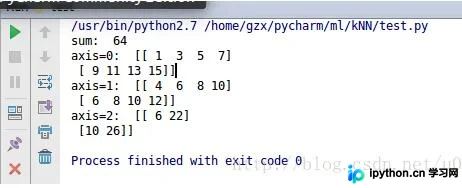
本文详细解析Python中numpy库array.sum()函数axis参数的作用机制。通过具体三维数组示例,分别演示axis=0、axis=1和axis=2时的元素相加逻辑与结果差异,帮助开发者理解不同维度下的聚合计算方式。
本文介绍如何利用Python内置的set函数对字符串和列表进行去重操作。由于set具有无序和唯一值的特性,该方法简洁高效。文章包含具体代码示例,展示字符串和列表去重的实现过程及输出结果,供开发者参考。
本文详细介绍Python中ConfigParser模块(Python 3.x中为configparser)的使用方法。内容涵盖配置文件的格式规范、创建配置文件、读取节点信息、判断节点存在性以及遍历节点数据等核心操作,帮助开发者高效管理Python项目的配置参数。
本文详细介绍Python内置模块filecmp的使用方法,涵盖cmp函数进行单文件内容比对、cmpfiles函数批量比较指定文件以及dircmp类递归分析目录结构差异。通过具体代码示例,解析匹配、不匹配及错误文件的判定逻辑,帮助开发者高效实现文件同步与差异检测功能。
本文介绍如何使用Python统计输入字符串中各类字符的数量。通过遍历字符串并利用ord()函数获取ASCII码值,分别判断英文字母、数字、空格及其他字符。代码包含完整的统计逻辑与输出示例,适用于基础字符串处理学习。
本文介绍在Python中统计列表不同元素数量的简便方法。核心思路是利用set集合不允许重复元素的特性,将列表转换为集合后获取其长度,即可得到去重后的元素个数。该方法代码简洁且执行效率高,适合快速处理数据去重统计需求。
本文介绍在Python中统计列表元素出现次数的实现方式。通过集合去重后遍历,利用字典的update方法结合列表的count方法,构建包含元素及其频次的字典。该方法直观展示了Python基础数据结构的操作技巧,适合初学者参考学习。
本文介绍Python中交换两个元素的不同实现方式。针对原生list,使用元组解包即可;针对NumPy矩阵ndarray,需区分行与列的交换。文章对比了两种写法,指出直接交换矩阵列时原生写法无效,必须采用切片赋值或索引重排,并提醒不同矩阵与同一矩阵操作的差异。