

Python Pandas Series重置索引至0的方法
本文介绍如何使用Pandas库中的reset_index方法将Series对象的索引重置为从0开始的连续整数。通过设置drop=True参数,可以删除原有的索引列,从而简化数据结构,便于后续的数据处理与分析操作。
2026-10-13
18

本文介绍如何使用Pandas库中的reset_index方法将Series对象的索引重置为从0开始的连续整数。通过设置drop=True参数,可以删除原有的索引列,从而简化数据结构,便于后续的数据处理与分析操作。
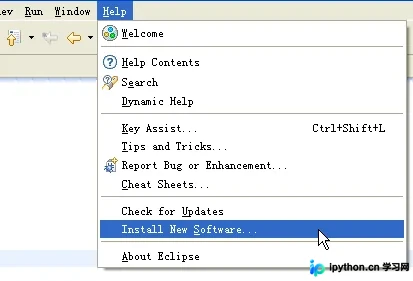
本文详细介绍在Eclipse中安装和配置PyDev插件的完整流程。重点解析PyDev与Eclipse及Java版本的对应关系,解决安装后Preferences中无PyDev选项的问题。提供新旧版插件的更新源地址及具体操作步骤,帮助用户正确配置Python解释器路径,确保开发环境顺利运行。
本文介绍在Python中使用Pandas库处理DataFrame时,如何高效重置或修改列名。通过两个实例演示了使用rename方法结合inplace参数,以及直接对columns属性进行赋值这两种常用操作,帮助开发者快速掌握数据预处理中的关键技巧。
本文介绍在pandas中进行数据映射时如何正确识别NaN值。通过自定义函数结合pd.isnull()判断空值,实现等频或等距切分。示例展示了age_map函数的逻辑及map函数的应用,确保分类准确处理缺失数据。
本文详细解析pandas中loc与iloc在数据选取上的核心差异,loc基于标签索引支持按条件筛选,而iloc基于位置索引。通过具体代码示例展示如何选取指定行列及多条件组合取值,帮助开发者高效处理DataFrame数据。
本文详解如何在 Pandas DataFrame 中检测列是否存在空值,并通过 isnull() 与 any() 组合返回 Series 结果。介绍将检测结果转化为 DataFrame 以筛选非空列的方法,以及针对特定列如 nkill 提取含空值记录的技巧。最后演示使用 fillna() 进行原地填充,支持指定数值或统计量(如中位数),并强调 inplace=True 参数对原数据直接修改的作用。
本文详细解析Python中flatten()函数的用法。该函数主要用于numpy数组和矩阵对象,可将多维数据展开为一维数组。文章对比了array与mat对象在调用flatten后的返回类型差异,并指出普通list不支持此方法,提供了使用列表推导式和递归lambda表达式处理列表展开的替代方案,帮助开发者正确进行数据降维操作。
本文介绍在macOS系统中查找Python包存放路径site-packages的快捷方法。通过避免手动遍历包含大量软链接的安装目录,利用Python内置的sys模块直接打印sys.path列表,可快速定位到包含site-packages的路径,提高开发效率。
本文通过实际测试对比了Python2与Python3中__bool__方法的实现差异。在Win10 Bash(Python 2.7.6)与CMD(Python 3.6.0)环境下,相同代码对自定义类实例的布尔判断结果不同。文章展示了具体代码、输出日志及版本信息,解释了这一接口行为变化对程序员的影响,并指出Python3在此处更具人性化。
本文详解Python中bool函数的取值逻辑。数字0转为False,非零为True;空字符串或None为False,非空字符串为True;空列表、字典及元组为False,反之则为True。通过实际案例展示如何利用bool判断值是否已设置,帮助开发者准确掌握类型转换规则。
本文介绍Python字典的基本操作与常用函数。涵盖字典的定义方式,以及clear、copy、get、items、keys、values、pop、update等核心方法的使用说明。通过具体代码示例展示如何获取、修改、删除字典元素,并对比get与直接索引访问的区别,帮助初学者快速掌握Python字典的基础用法。
本文详细介绍在 Python 中导入 CSV 文件的三种常用方法。首先通过标准库 csv 结合 NumPy 数组处理基础数据;其次利用 NumPy 的 loadtxt 函数处理无表头且类型统一的数据;最后重点推荐 Pandas 库的 read_csv 函数,因其返回 DataFrame 结构,便于后续数据清洗与机器学习建模,是实际开发中的首选方案。