

Python DataFrame 取差集:删除指定列中匹配列表元素的行
本文介绍如何在 Python 的 DataFrame 中计算差集,即删除指定列中与给定列表元素重复的行。通过 isin 方法生成布尔掩码并取反,实现高效筛选,最后重置索引输出结果。
2026-10-13
17

本文介绍如何在 Python 的 DataFrame 中计算差集,即删除指定列中与给定列表元素重复的行。通过 isin 方法生成布尔掩码并取反,实现高效筛选,最后重置索引输出结果。
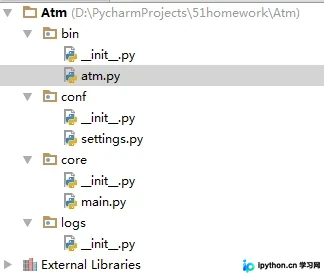
本文详解Python中不同目录间模块调用的实现方法。通过解析__file__、os.path.abspath()及sys.path等关键概念,对比绝对路径与相对路径的区别。重点演示如何获取项目根目录绝对路径并追加至sys.path环境变量,从而解决跨层级模块导入时的路径依赖问题,确保代码在不同执行环境下的可移植性。
本文介绍利用Python的PIL库实现批量生成指定尺寸图片并添加任意文字的功能。脚本支持通过命令行直接指定宽高与内容,或通过CSV文件批量读取配置。核心逻辑包含自动调整字体大小以适应图片区域,并将文字居中绘制。代码提供完整实现及数据文件格式说明,适合需要快速生成测试素材或特定规格图片的开发场景。
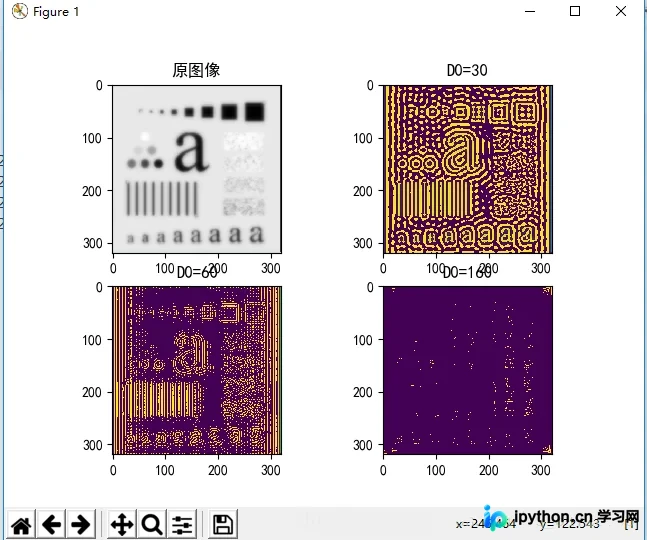
本文介绍如何使用Python和OpenCV实现理想高通滤波。通过读取图像、转换为灰度并执行FFT,构建不同截止频率(D1=30, D2=60, D3=160)的滤波器。代码演示了频域乘法与逆FFT过程,最终对比展示原图与不同阈值下的滤波结果,帮助理解频域高通处理对图像边缘提取的影响。
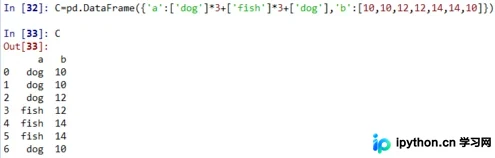
本文介绍如何在Pandas中利用duplicated方法统计并筛选包含重复值的列,通过keep参数控制保留逻辑。同时提供五种NumPy数组去重方案,包括利用unique、bincount及排序比较等技巧,帮助开发者高效处理数据中的重复项。
本文介绍在 pandas 中处理重复数据的方法。通过示例展示如何创建 DataFrame,使用 duplicated() 检测重复项,并利用 drop_duplicates() 移除重复行。重点解析 subset 参数指定特定列,以及 keep 参数('first', 'last', False)控制保留策略,帮助开发者高效清理数据。
本文详解Python通过ctypes调用C语言链接库时,如何处理数组、结构体及指针类型的数据传递。文章通过C语言与Python代码对照,演示了数组实例化、结构体定义及指针引用(byref)的具体用法,帮助开发者规避常见坑点,实现高效跨语言调用。
本文通过具体代码实例,演示如何在Python的Pandas库中筛选DataFrame中某列值为特定内容的行。重点解析利用iloc结合布尔索引提取指定列数据的技巧,并展示从原始数据到筛选结果的完整执行过程,帮助开发者快速掌握数据过滤的核心操作。
本文介绍如何在Pandas中利用字典映射方法,将DataFrame某一列的字符串值高效转换为数字。通过定义映射字典并调用map函数,即可实现类型转换,适用于分类变量编码等场景。
本文系统梳理Numpy中random模块的核心函数,涵盖randn、standard_normal、randint、random_integers、random_sample及choice等常用方法。详细解析各函数的参数含义、取值范围及多维数组处理逻辑,并通过代码示例展示shuffle与permutation在序列重排中的区别,帮助开发者高效掌握Numpy随机数生成技巧。
本文介绍如何在Python Pandas中向DataFrame指定位置添加列。对比直接赋值和concat()只能在末尾添加的局限,重点讲解利用reindex()方法通过columns参数控制列顺序,并使用fill_value指定新列值,实现灵活插入单列或多列。
本文详细介绍Python中Pexpect库的使用方法,重点演示如何通过该库实现SSH远程命令执行及SFTP文件传输的自动化交互。文章涵盖环境配置、代码示例及SFTP操作中关键的期望匹配注意事项,帮助开发者解决远程服务器自动运维与测试中的交互问题。