Python Pandas添加行列数据的方法详解
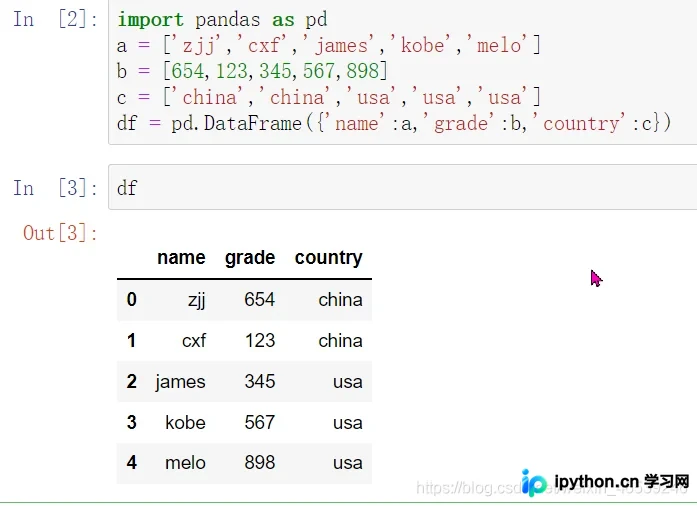
本文详细总结了Python Pandas库中增加行列数据的多种常用方法。内容涵盖使用直接赋值、eval计算、insert函数插入指定列,以及利用loc、iloc、append和concat处理行数据。此外,还介绍了通过apply函数结合自定义逻辑新增衍生列的技巧,适用于数据清洗与特征工程场景。
2026-10-15
8

本文详细总结了Python Pandas库中增加行列数据的多种常用方法。内容涵盖使用直接赋值、eval计算、insert函数插入指定列,以及利用loc、iloc、append和concat处理行数据。此外,还介绍了通过apply函数结合自定义逻辑新增衍生列的技巧,适用于数据清洗与特征工程场景。
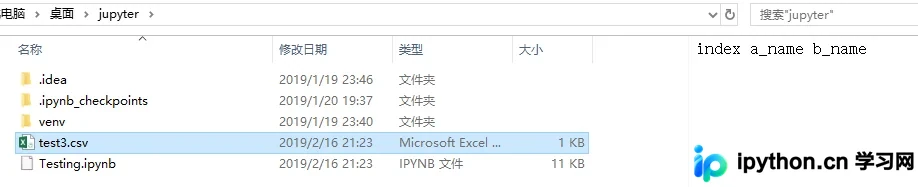
本文介绍如何使用 Python 将新生成的数据实时追加到现有的 CSV 或 TXT 文件中。通过演示 csv 模块的 writerow 和 writerows 方法,以及文件打开模式 'a' 的使用,详细讲解了如何避免数据覆盖、处理换行符及正确关闭文件,确保数据持久保存。
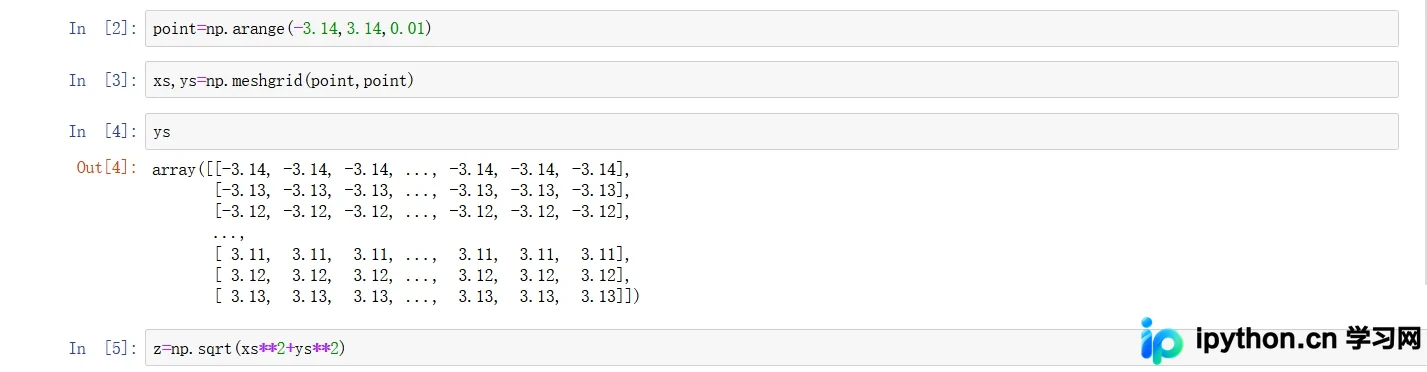
本文详解Python Numpy库中面向数组编程的核心操作。通过向量化计算替代循环,显著提升数据处理效率。深入解析np.where三元表达式、sum/mean等统计聚合函数、布尔数组判定以及unique等集合操作,提供从基础生成到复杂逻辑处理的完整代码示例,助力高效数据分析。
本文介绍如何使用OpenCV内置的ANN_MLP类构建神经网络以识别手写数字。通过Keras加载MNIST数据集,配置反向传播算法与Sigmoid激活函数进行模型训练。实验显示100次迭代后准确率达0.9376,且模型文件仅1MB,远小于SVM和KNN,非常适合客户端部署。

本文介绍如何使用Python的OpenCV库进行基础图像处理。涵盖模块安装、图像读取(cv2.imread)、显示(cv2.imshow)及保存(cv2.imwrite)的具体操作,并详解如何获取图像的像素尺寸、通道数等属性,适用于计算机视觉初学者。
本文详细解析Python中六个高频使用的内置函数:Map用于高效转换可迭代对象,Lambda创建匿名函数简化逻辑,Enumerate辅助索引遍历,Reduce执行累积运算,Filter精准过滤数据,以及Zip合并多个列表。通过具体代码示例展示如何简化编程工作,提升代码运行速度与内存效率,帮助开发者掌握Python数据处理的核心技巧。
本文详细介绍Python第三方库Tenacity的高级重试功能。涵盖无条件重试、设置重试次数与时间限制、基于异常类型或结果的条件重试,以及重试失败后的错误重新抛出和回调函数配置。通过具体代码示例,帮助开发者优雅地处理网络请求超时等不可控因素。
本文详细介绍pytest框架中@pytest.mark.parametrize()装饰器的核心用法。通过单参数多值、多参数组合、字典数据传入等实例,展示如何实现测试用例的参数化,提升测试覆盖率与代码复用性。
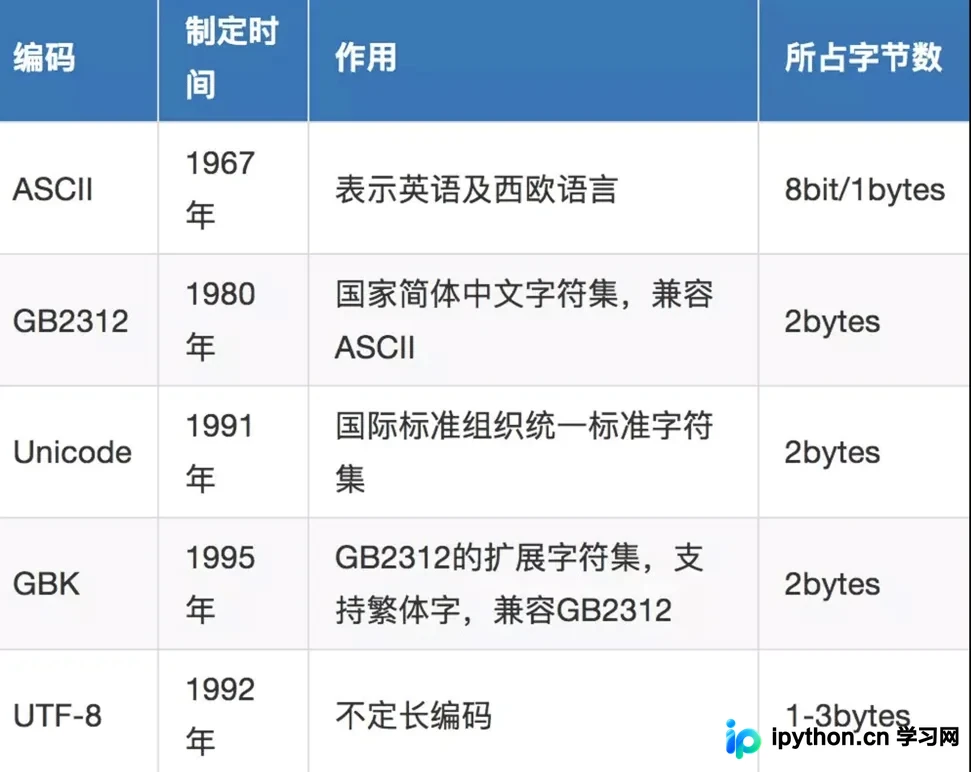
本文详细解析Python中常见的四种编码格式:ASCII、Unicode、UTF-8及GBK。从Python2默认ASCII到Python3默认UTF-8的演变出发,阐述各编码的字节占用、适用范围及存储效率差异,帮助开发者理解字符编码原理并解决乱码问题。
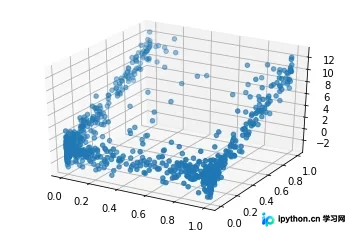
本文介绍如何使用 Python 的 Copula 库生成三维合成数据集并绘制散点图。通过 GaussianMultivariate 模型拟合边缘与联合分布,利用 sample 方法生成新样本,并对比真实与拟合数据的三维散点差异。同时详解模型的 save、load 及参数提取与重建流程,适用于需要高效采样与模型持久化的场景。
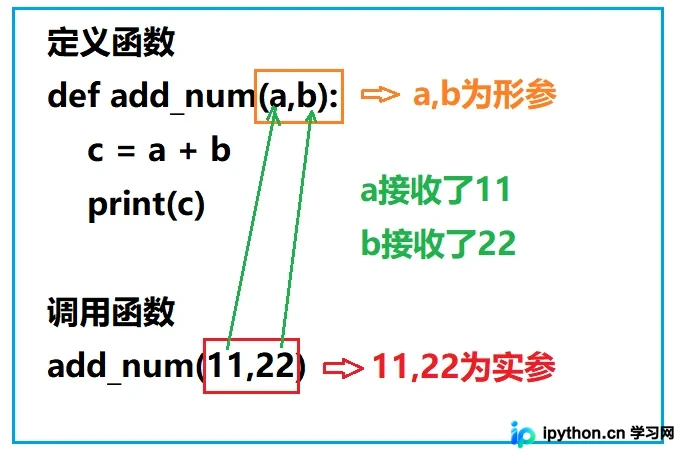
本文详细解析Python中函数的参数定义与调用机制,区分形参与实参概念。重点讲解位置参数、关键字参数的传参顺序,以及必备参数、默认参数的定义规则。深入剖析不定长参数*args与**kwargs的使用场景、拆包技巧及注意事项,帮助开发者掌握Python函数传参的核心规范。
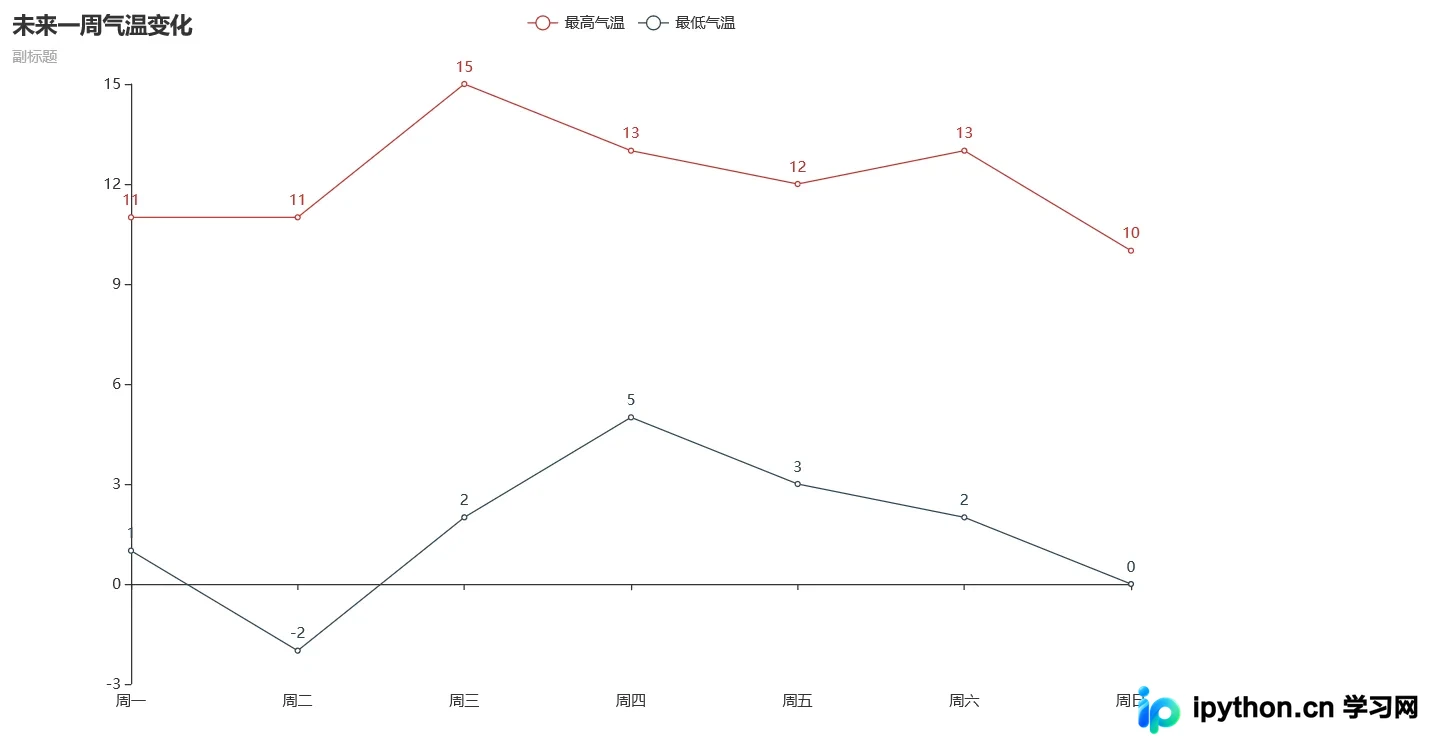
本文详解Python中pyecharts库绘制各类折线图的方法,涵盖双折线、面积图、简单图、缺失数据连接、对数轴及堆叠图等模板。通过具体代码示例,展示如何配置参数以清晰展现数据趋势、速率及峰值特征,适用于不同场景的可视化需求。