Python爬虫UA伪装实战:利用urllib.request突破反爬机制
本文详解Python爬虫中User-Agent(UA)的作用及反爬原理。通过对比默认urlopen与自定义Request对象,演示如何获取浏览器UA并封装进headers字典,成功伪装爬虫身份以绕过网站检测。包含搜狗搜索抓包获取UA及完整代码示例,帮助开发者解决基础反爬问题。
2026-10-13
12

本文详解Python爬虫中User-Agent(UA)的作用及反爬原理。通过对比默认urlopen与自定义Request对象,演示如何获取浏览器UA并封装进headers字典,成功伪装爬虫身份以绕过网站检测。包含搜狗搜索抓包获取UA及完整代码示例,帮助开发者解决基础反爬问题。
本文介绍使用Python zipfile模块批量解压ZIP文件的脚本实现。重点解决中文文件名乱码问题,通过修改源码将cp437编码替换为gbk。提供完整代码示例,包含解压、去重及清理功能,并强调测试备份的重要性。
本文介绍了使用Python实现某论坛自动签到功能的方法。通过模拟用户登录和请求,实现了自动签到功能。文章提供了完整的Python代码示例,并详细解释了代码的实现过程。
本文详解Python中Requests模块发起GET请求的两种常见场景:携带查询参数与自定义请求头。通过搜狗首页及搜索接口的实战代码,演示如何利用params字典传递URL参数,以及通过headers参数设置User-Agent以模拟浏览器访问,帮助开发者掌握基础爬虫请求构造技巧。
本文详解Python爬虫中urllib模块处理URL编码的方法。针对包含非ASCII字符(如中文)的URL,直接请求会引发UnicodeEncodeError。通过urllib.parse.quote函数对特殊字符进行ASCII编码并拼接,可生成有效URL,确保爬虫程序正常发起请求并获取页面数据。
本文详细记录了在Linux CentOS 7环境下,通过安装pyenv和virtualenv实现Python多版本共存及项目环境隔离的完整过程。涵盖从源码下载、国内镜像源配置、依赖安装到虚拟环境创建与切换的实际操作步骤,解决官方源下载缓慢问题,并提供常用命令参考。
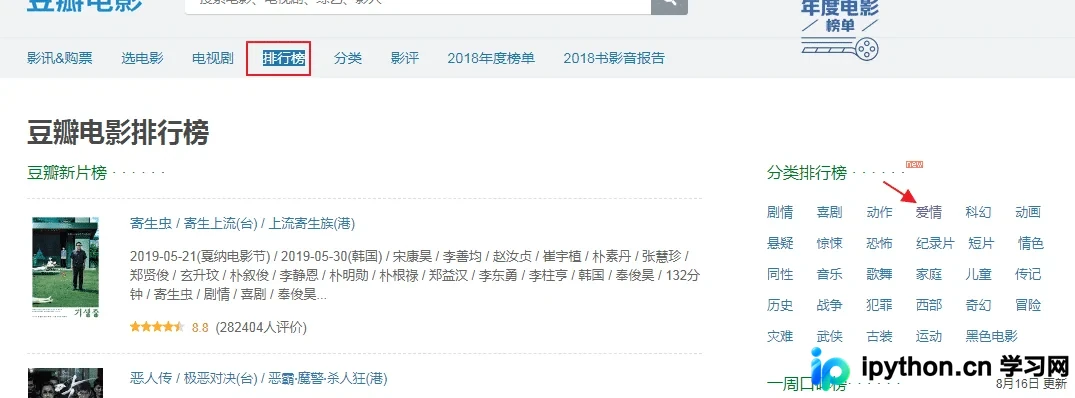
本文详解如何使用Python的Requests模块发起Ajax GET请求以爬取豆瓣电影分类排行榜数据。通过抓包工具定位异步加载的接口,解析返回的JSON字符串,并调整start和limit参数获取不同范围的电影详情,实现高效的数据抓取。
本文介绍Python3中实现对象与JSON字符串相互转换的具体操作。通过导入json模块,利用json.dumps()将字典、列表等Python数据结构序列化为JSON格式,并使用json.loads()将JSON字符串反序列化为Python对象。文中包含代码示例及类型映射规则说明,并附带相关在线工具推荐。
本文详细介绍Python3.6中@property装饰器的核心用法。通过示例演示如何将方法转换为属性调用,利用@property创建getter,结合@score.setter实现setter赋值,以及定义仅含getter的只读属性。内容涵盖Screen类中width、height及resolution属性的完整实现,帮助开发者深入理解面向对象编程中的属性封装技巧。
本文介绍利用Python和OpenCV库实现证件照背景更换的具体方法。核心思路是将图像转换至HSV空间,通过提取背景颜色生成掩模,再结合位运算分离人像与背景,最终合成新背景图像。文中提供了完整的函数代码及测试示例,适用于红、白、蓝等常用证件照背景色的批量处理。
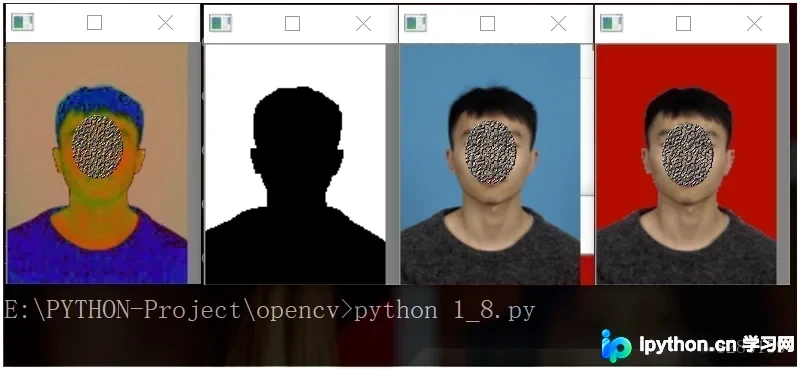
本文提供基于Python和OpenCV库的证件照背景替换完整源码。通过读取前景与背景图像,利用HSV色彩空间进行阈值分割生成掩膜,结合形态学操作优化边缘,最终将前景人物合成至新背景并保存结果。代码包含图像读取、颜色空间转换、抠图逻辑及合成保存等关键步骤,适用于Python初学者参考学习。
本文介绍如何在Django项目中集成Highcharts库,通过前端JS配置与后端Python逻辑配合,统计并展示最近七天的文章点击量及点赞量。内容涵盖插件引入、图表容器定义、JS配置、路由映射及后台数据获取方法,帮助开发者快速实现数据可视化功能。