

Pandas分组聚合实战:深入解析transform与apply自定义函数用法
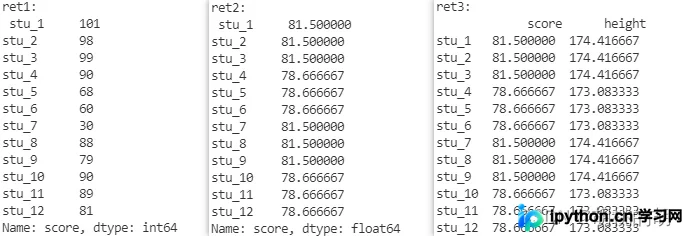
本文详细解析Pandas中transform与apply方法在分组聚合中的区别与应用。通过示例展示如何利用自定义函数处理Series和DataFrame,包括数值计算、字符串操作及多列聚合。重点阐述transform保持原索引长度与apply返回聚合结果的特性,帮助开发者根据需求选择合适方法,提升数据处理效率。
2026-10-12
16

本文详细解析Pandas中transform与apply方法在分组聚合中的区别与应用。通过示例展示如何利用自定义函数处理Series和DataFrame,包括数值计算、字符串操作及多列聚合。重点阐述transform保持原索引长度与apply返回聚合结果的特性,帮助开发者根据需求选择合适方法,提升数据处理效率。
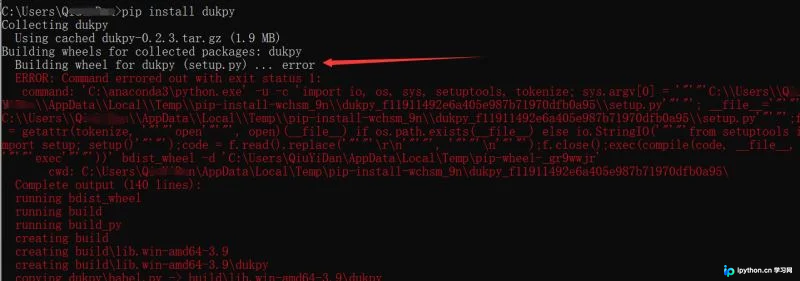
本文详细解析在使用pip安装Python库时遇到的“Failed building wheel for xxx”错误原因及解决方案。该错误通常因缺少预编译的.whl文件导致。通过访问第三方资源网站下载对应Python版本和系统的.whl文件,并手动执行安装命令,可有效绕过编译问题,确保依赖库正常部署。
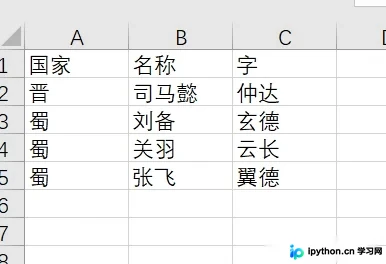
本文详解如何利用Python的Pandas库在Excel和CSV文件中实现类似VLOOKUP的数据关联功能。内容涵盖删除指定行、获取最大行数、上下拼接表格以及使用merge函数进行左连接合并。通过具体代码示例,展示如何高效处理三国人物数据,解决大数据量下的性能问题,并提供从数据清洗到最终合并的完整操作流程。
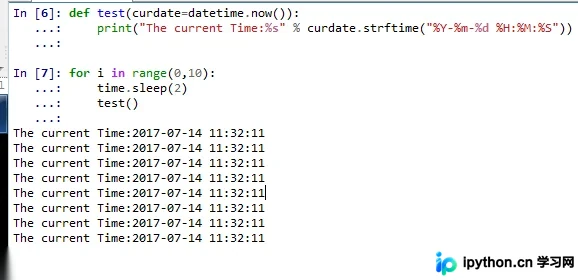
本文深入解析Python函数默认参数仅计算一次的底层机制。通过实际测试代码验证动态默认值导致的重复输出现象,阐明函数定义时的绑定规则。提供使用None占位符的标准修复方案,并梳理常规默认参数与不定长参数(*args)的正确写法,协助开发者快速定位并规避此类隐蔽的语法陷阱。
本文深入解析Python中if __name__ == '__main__'的作用机制。通过单文件与多文件示例,阐明直接运行与模块导入时__name__值的差异,展示如何利用该结构隔离测试代码与业务逻辑,避免导入时的意外执行,提升代码复用性与工程规范性。
Python 使用 pip 安装包最为便捷,但在离线部署或自定义分发场景下,开发者需借助 setuptools 构建 setup.py 进行工程打包。本文详细拆解 setup.py 的核心参数配置、依赖管理规范、非代码资源导入方法及命令行工具声明逻辑,并附带现代环境下的标准构建与安装操作流程。
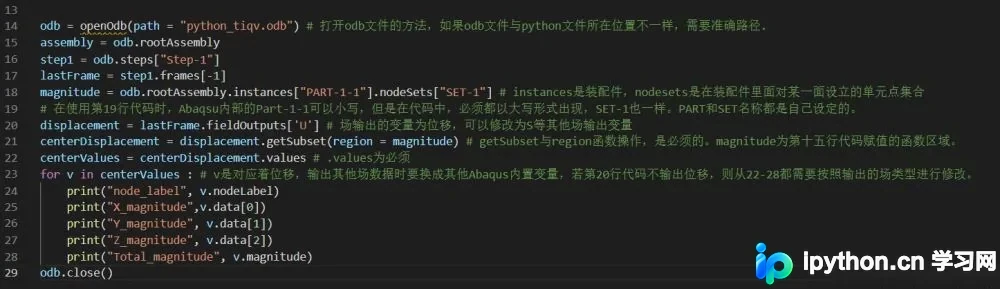
直接通过Python脚本读取Abaqus后处理文件(ODB)中的场输出数据时,需调用abaqus内置脚本接口定位分析步、节点集与场变量。本文提供标准化的代码实现流程,覆盖从环境配置、ODB解析、字段映射到CSV导出的完整操作,附带实际算例运行反馈与常见路径报错排查指南。
针对IDE内置帮助文档查阅繁琐且缺乏搜索功能的问题,本文提供一款基于Tkinter开发的Python本地函数查询小工具。该工具支持直接调用help接口检索模块说明,可将结果导出为.ini配置文件,并支持右键重命名与管理。附带完整源码、依赖安装步骤及运行注意事项,适合离线快速查阅API的学习者参考使用。
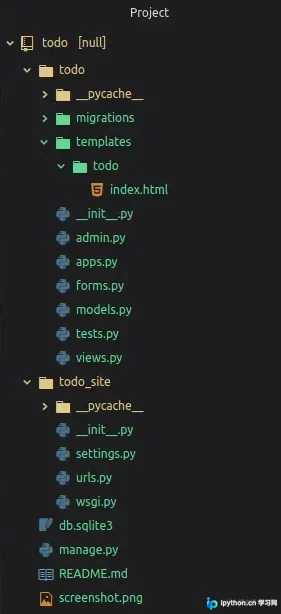
本教程详细介绍如何使用Python Django框架快速构建一个待办事项Web应用。内容涵盖Django环境配置、项目与应用的创建、数据库模型定义、视图逻辑处理、表单生成及管理员后台注册。通过具体代码示例,指导开发者完成从项目初始化到功能实现的完整流程,适合希望掌握Django基础开发的初学者参考。
本文系统梳理 Python 中列表的核心操作方法。从引用传递机制与遍历技巧入手,详细演示 append、extend、insert 添加元素,以及 del、pop、remove 删除元素的差异。深入解析分片赋值的覆盖与插入用法,并对比 reverse、sort 与 sorted 的排序逻辑。提供可直接运行的代码示例,帮助开发者快速掌握数据结构实操。
fileinput 模块专为迭代处理一个或多个文本文件设计,采用逐行生成的惰性读取方式,在批量处理大文件时可显著降低内存占用。相比传统的 open() 结合循环,它原生支持原地修改、自动备份、跨文件序号追踪及自定义读取钩子。通过合理配置参数与方法,可快速实现日志清洗、代码批量检索与格式标准化等任务。
在运行Python脚本时,经常需要通过命令行动态传入变量。本文详细介绍三种常用传参方式:基础列表解析(sys.argv)、带短长选项解析(getopt模块)以及通过外部配置文件中转。结合实际仿真计算与浏览器自动化测试场景,给出完整代码示例与参数对比,帮助开发者灵活选择适合项目需求的传参方案。