Python数据挖掘核心技能:从数据处理到模型实战
本文系统梳理Python数据挖掘的核心知识体系,涵盖Pandas分组与索引操作、Numpy数组计算与广播机制、Matplotlib与Seaborn可视化技巧,以及最小二乘、梯度下降、决策树等常用算法原理。通过scikit-learn库进行模型实战,帮助初学者掌握从数据预处理到机器学习建模的完整流程。
2026-10-13
14

本文系统梳理Python数据挖掘的核心知识体系,涵盖Pandas分组与索引操作、Numpy数组计算与广播机制、Matplotlib与Seaborn可视化技巧,以及最小二乘、梯度下降、决策树等常用算法原理。通过scikit-learn库进行模型实战,帮助初学者掌握从数据预处理到机器学习建模的完整流程。
本文系统梳理Python中常见的类数组数据结构,包括可变列表list、不可变元组tuple、定长数组array.array以及字符串序列str、bytes和bytearray。详细对比它们在内存占用、可变性及元素类型限制上的差异,并提供各类型间相互转换的代码示例,帮助开发者根据性能与功能需求选择合适的数据结构。
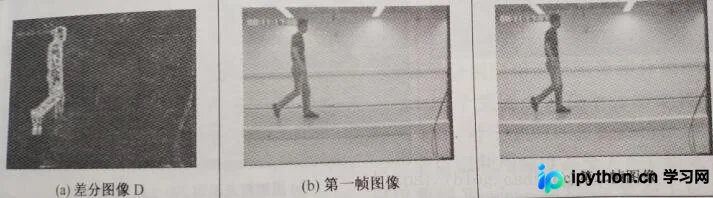
本文介绍使用Python和OpenCV库,通过帧差法实现基于摄像头的人员活动检测。详细解析了从视频流获取、灰度转换、高斯滤波到轮廓提取的完整流程,并提供了可直接运行的源代码及参数调节建议,适用于机器人开发或本地监控场景。
本文详细介绍Python中pandas库创建DataFrame的多种方法,包括从字典和列表构建数据框、指定列名与顺序、修改列名以及生成随机整数数据。同时演示如何使用时间序列作为索引,并简要提及类SQL操作功能,帮助开发者快速掌握DataFrame的基础构建技巧。
本文详细介绍pandas中Series数据结构的创建方式,包括通过列表、字典及指定索引生成Series。重点解析元素访问、布尔过滤、标量运算及数学函数应用,并深入讲解Series基于索引的自动对齐机制。同时涵盖Series与索引的命名属性设置,帮助开发者掌握基础数据处理技能。
本文针对在Jupyter Notebook中使用pyecharts时遇到的版本兼容问题,详细解析了从V0.5.x迁移至V1.x后常见的导入错误及初始化报错。通过对比新旧版本的API差异,提供了具体的代码修正方案,并给出了在macOS环境下安装旧版本依赖时解决xcode-select报错的完整步骤,帮助用户快速恢复图表渲染功能。
本文介绍如何在PyQt5应用中嵌入Matplotlib图表,核心在于使用FigureCanvasQTAgg类。通过示例代码展示如何创建窗口、绑定按钮点击事件,并利用cla()清空画布和draw()重绘实现动态数据更新,为开发者提供基础框架参考。
本文深入解析Django框架中XSS跨站脚本攻击的成因及防御策略。重点剖析{{comment|safe}}过滤器在富文本场景下的潜在风险,并详细介绍如何利用django.utils.html模块中的escape、strip_tags及remove_tags函数,对用户输入进行服务端转义处理,从而有效阻断脚本注入,保障Web应用安全。
本文详解Python中利用win32gui获取窗口句柄、标题、位置及执行点击置顶等操作的方法,并深入讲解Selenium中处理新窗口句柄切换的技巧。此外,还介绍了通过JavaScript移除链接target属性以控制当前页打开的实用技巧,适用于桌面自动化与Web自动化场景。
本文详解Django中如何控制Model创建的数据库索引顺序,特别是涉及ForeignKey时的处理技巧。同时介绍联合约束unique_together与联合索引index_together的配置方法,通过具体案例说明联合索引在大数据量查询中的性能优势及SQL执行逻辑。
本文详细介绍Python语言的发展背景及核心特性。Python由Guido van Rossum在20世纪80年代末设计,融合了多种语言优点,具备解释性、交互式及面向对象等特征。文章列举了其易学、易读、可移植、可扩展及丰富的标准库等优势,适合初学者及专业开发者了解Python的基础架构与应用场景。
本文详细介绍如何使用Python的QQBot库搭建QQ聊天机器人。内容涵盖库的安装、主动发消息、基于事件的自动回复机制,以及如何结合图灵机器人API实现智能对话。通过具体代码示例和配置步骤,指导开发者在Windows环境下完成机器人的部署与测试。