Python列表推导式进阶实战:从基础语法到复杂嵌套应用
本文深入解析Python列表推导式的语法规范与执行效率,通过涵盖数字筛选、水仙花数、矩阵转置、勾股数生成及随机密码等20余个实战案例,展示一维至多层嵌套推导式的灵活应用。内容涵盖基础语法、内置函数优化及复杂逻辑处理,旨在帮助开发者掌握简洁高效的Python编程技巧。
2026-10-16
63

本文深入解析Python列表推导式的语法规范与执行效率,通过涵盖数字筛选、水仙花数、矩阵转置、勾股数生成及随机密码等20余个实战案例,展示一维至多层嵌套推导式的灵活应用。内容涵盖基础语法、内置函数优化及复杂逻辑处理,旨在帮助开发者掌握简洁高效的Python编程技巧。
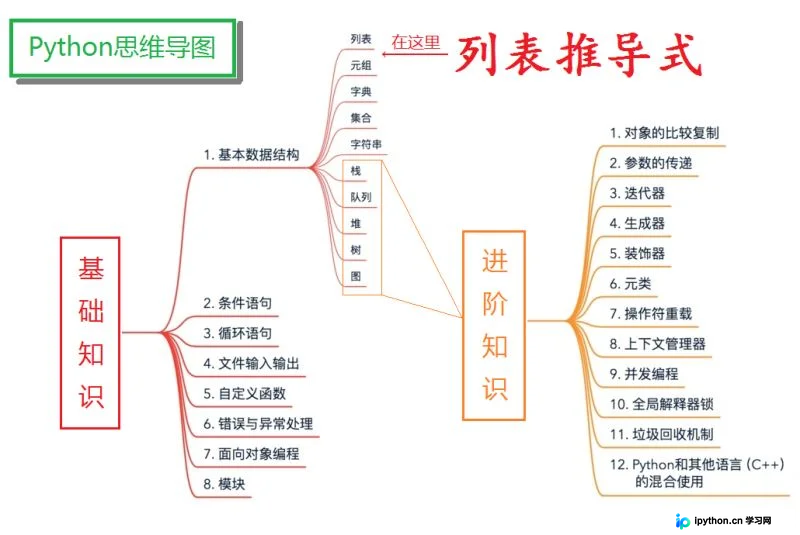
这篇文章把 Debian 上搭建 Python 爬虫的基础流程拆成可直接照做的几个环节:检查 Python、补齐 pip、创建虚拟环境、安装常用库、编写并运行示例程序,同时补上爬取礼仪和数据存储建议,适合刚开始在 Linux 环境里动手的人。
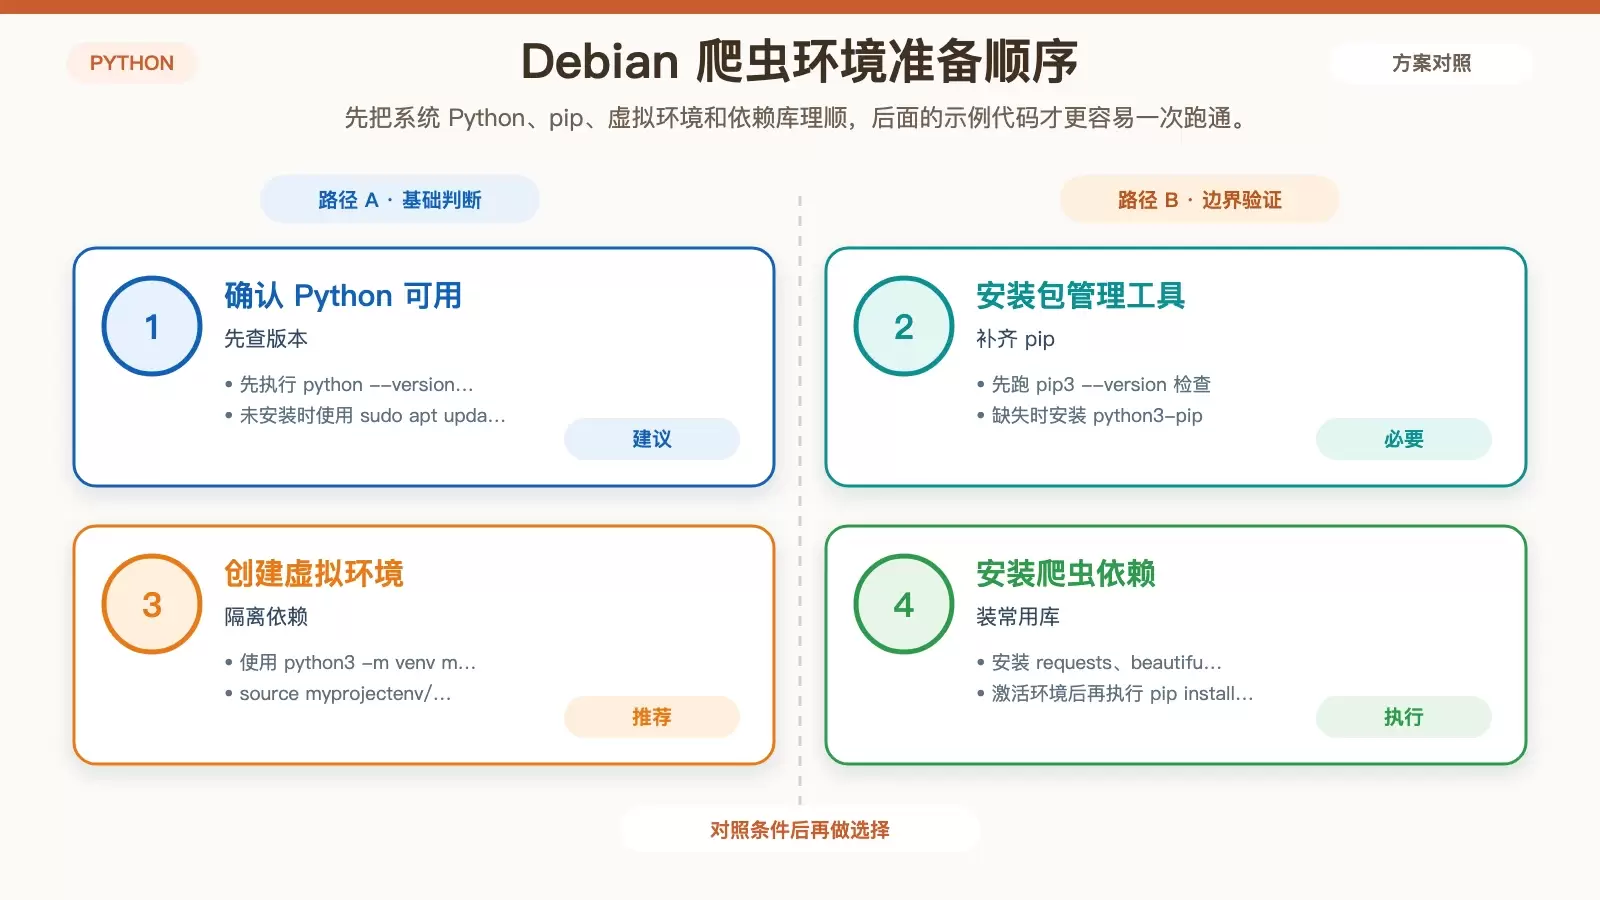
Go 在分布式系统里的优势,不只是“更快”这么简单。它真正拉开差距的地方在于并发模型、资源占用、启动速度以及云原生部署体验。和 Java、Python 对比后,可以更清楚判断:什么时候该优先选 Go,什么时候仍该保留其他语言。
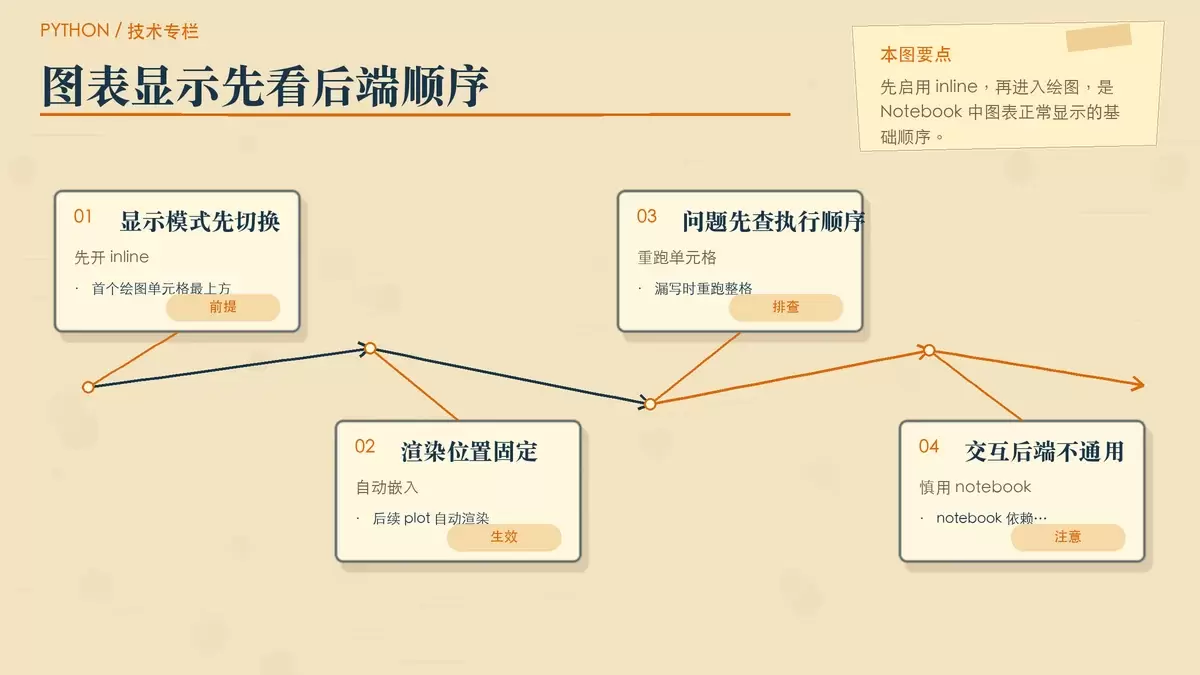
在 Jupyter Notebook 里用 Matplotlib 画图,常见问题往往不在语法,而在显示后端、中文字体和子图对象的配置顺序。本文按实际排错路径梳理 `%matplotlib inline`、`plt.rcParams`、`plt.subplots()` 的使用边界,帮助你判断图表为什么不显示、中文为什么乱码,以及多子图该用哪套写法。
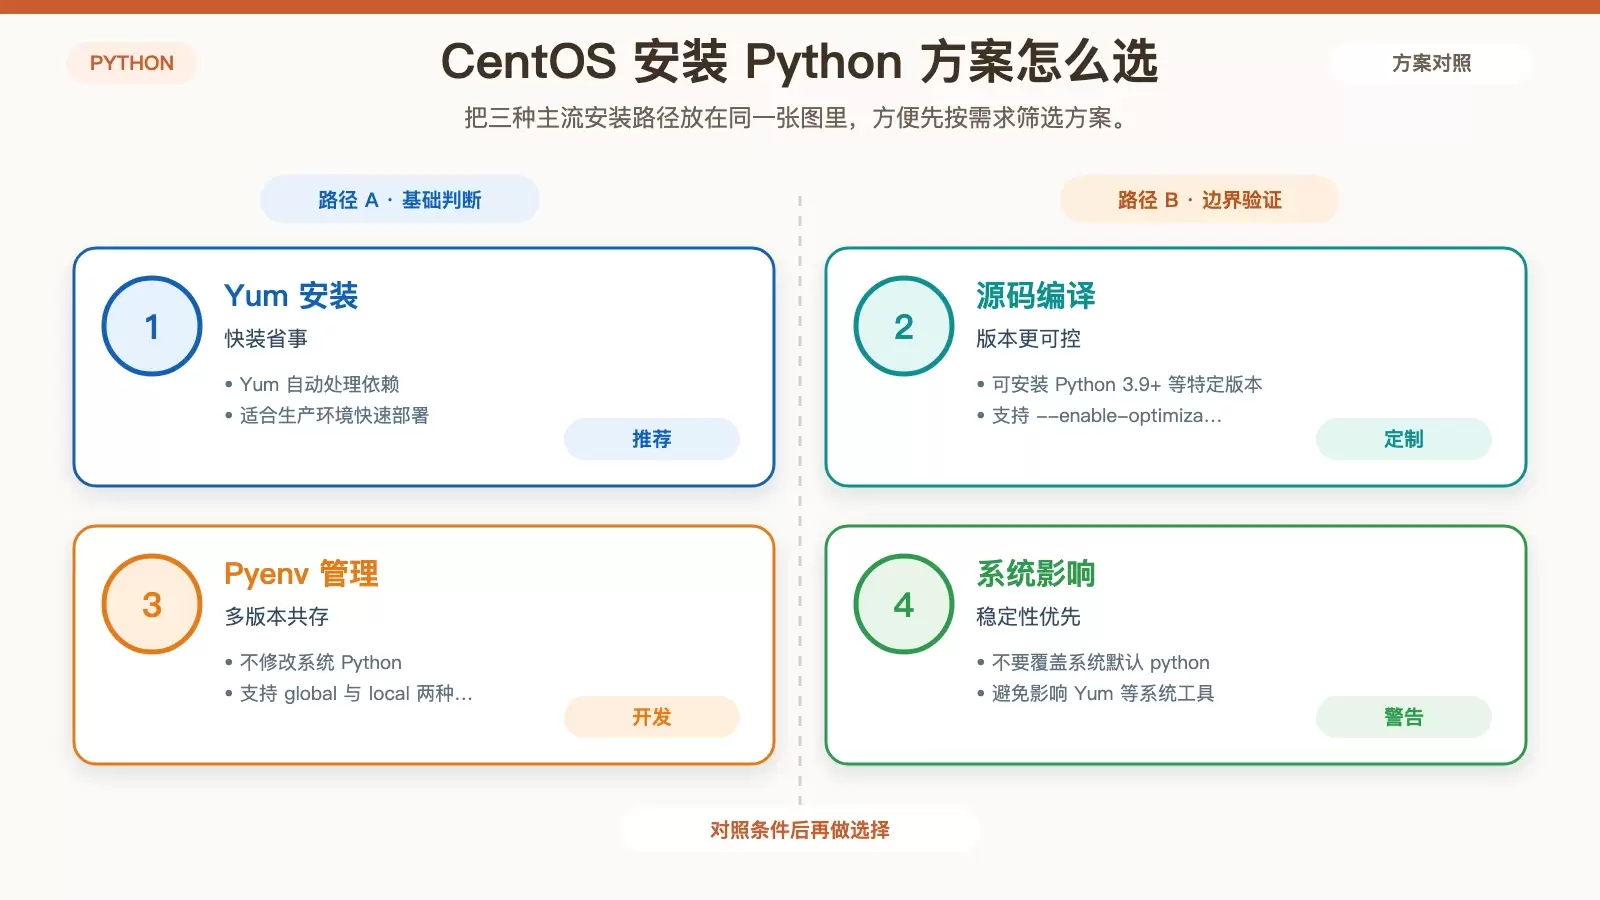
CentOS 安装 Python 没有单一标准答案,关键在于部署目标、版本要求和对系统稳定性的容忍度。本文按 Yum、源码编译、Pyenv 和虚拟环境四条路径拆解适用场景、操作步骤与常见故障,帮助你在不破坏系统 Python 的前提下选出合适方案。
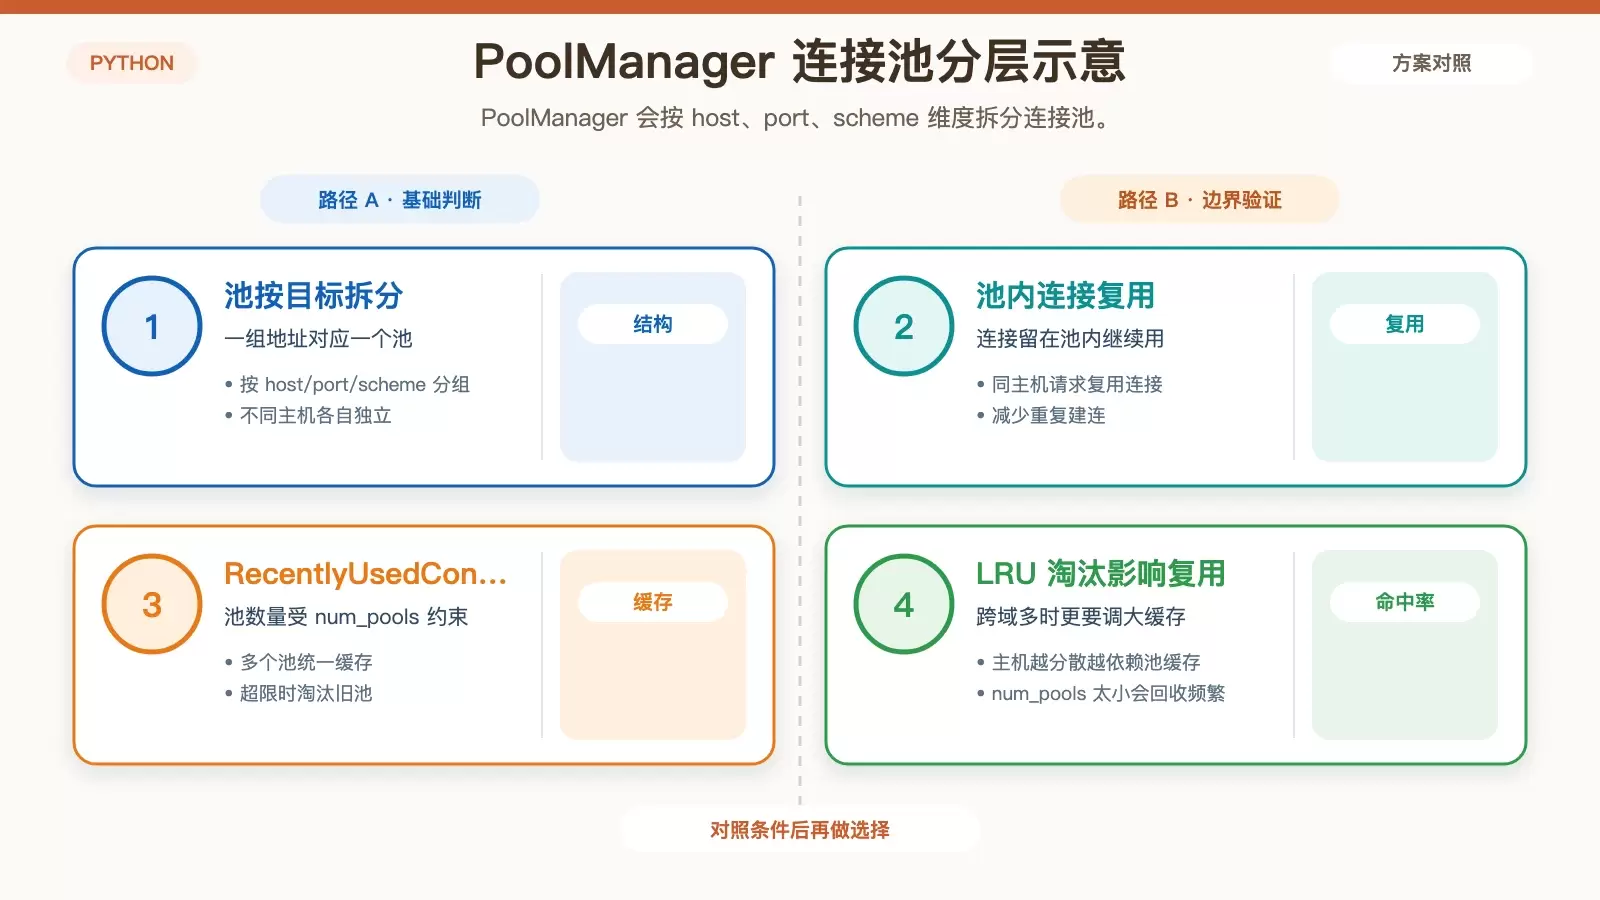
urllib3 的 `PoolManager` 看起来只是一个高层入口,实际负责按主机维护连接池、复用连接并管理淘汰策略。本文把它的工作方式、关键参数、常见报错和生产环境中的 SSL/TLS 配置拆开说明,帮助你判断什么时候直接用默认配置,什么时候必须显式调参。
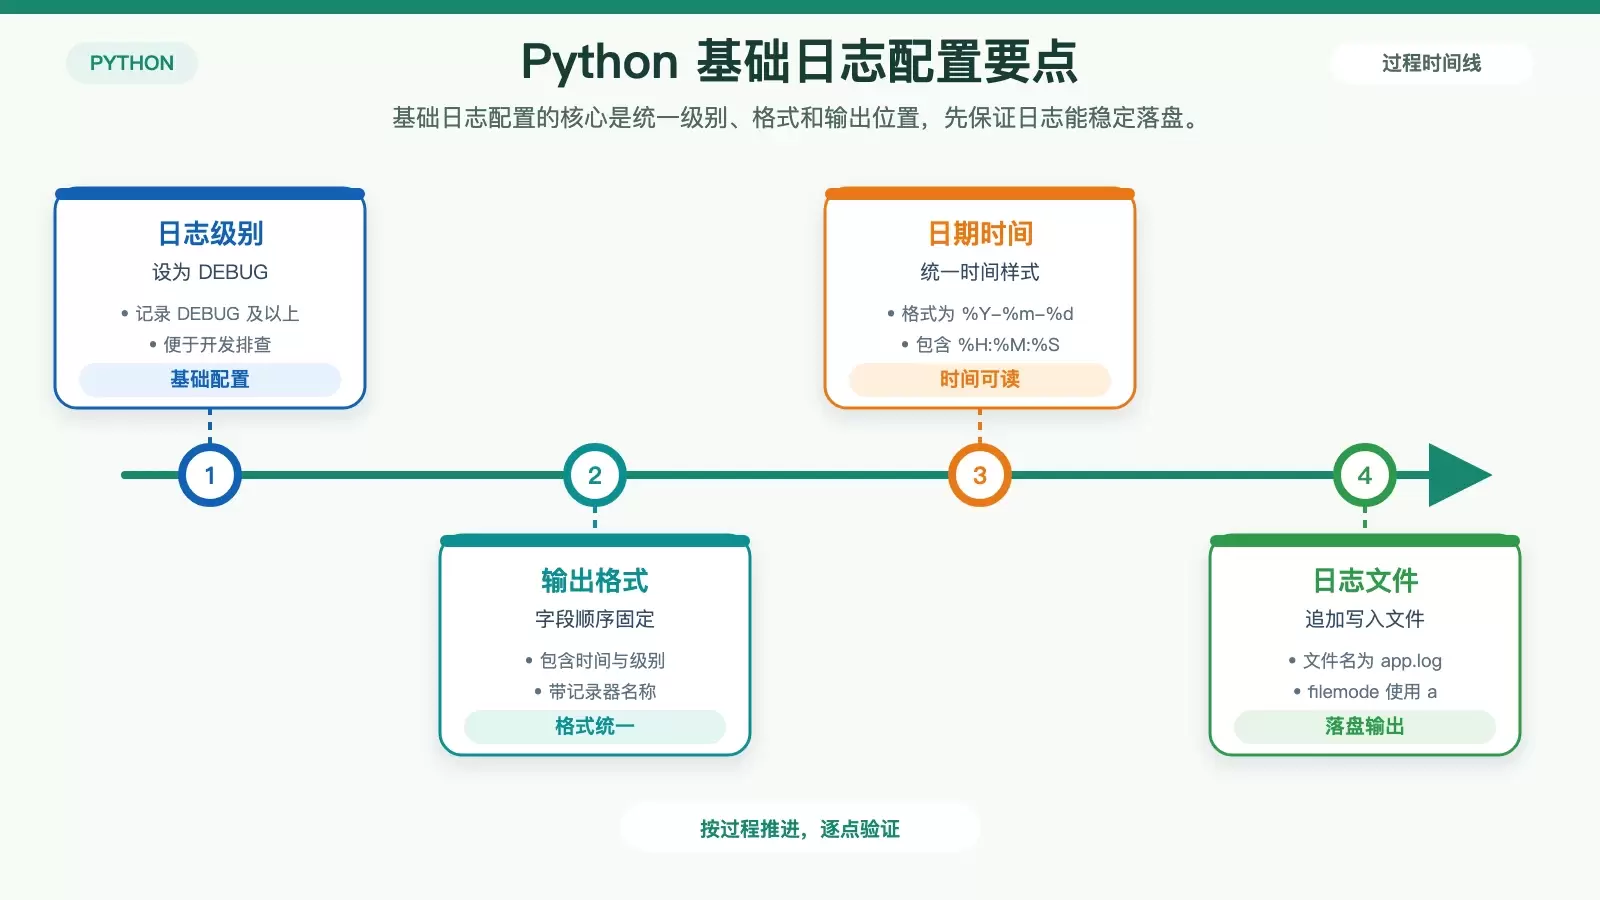
这篇文章以 Debian 环境为例,梳理 Python 日志配置的常用做法:先完成运行环境准备,再用 `logging` 建立基础日志格式,随后根据磁盘占用和运维方式选择文件轮转或接入 `syslog`。文中保留关键命令、参数和示例代码,便于直接落地。
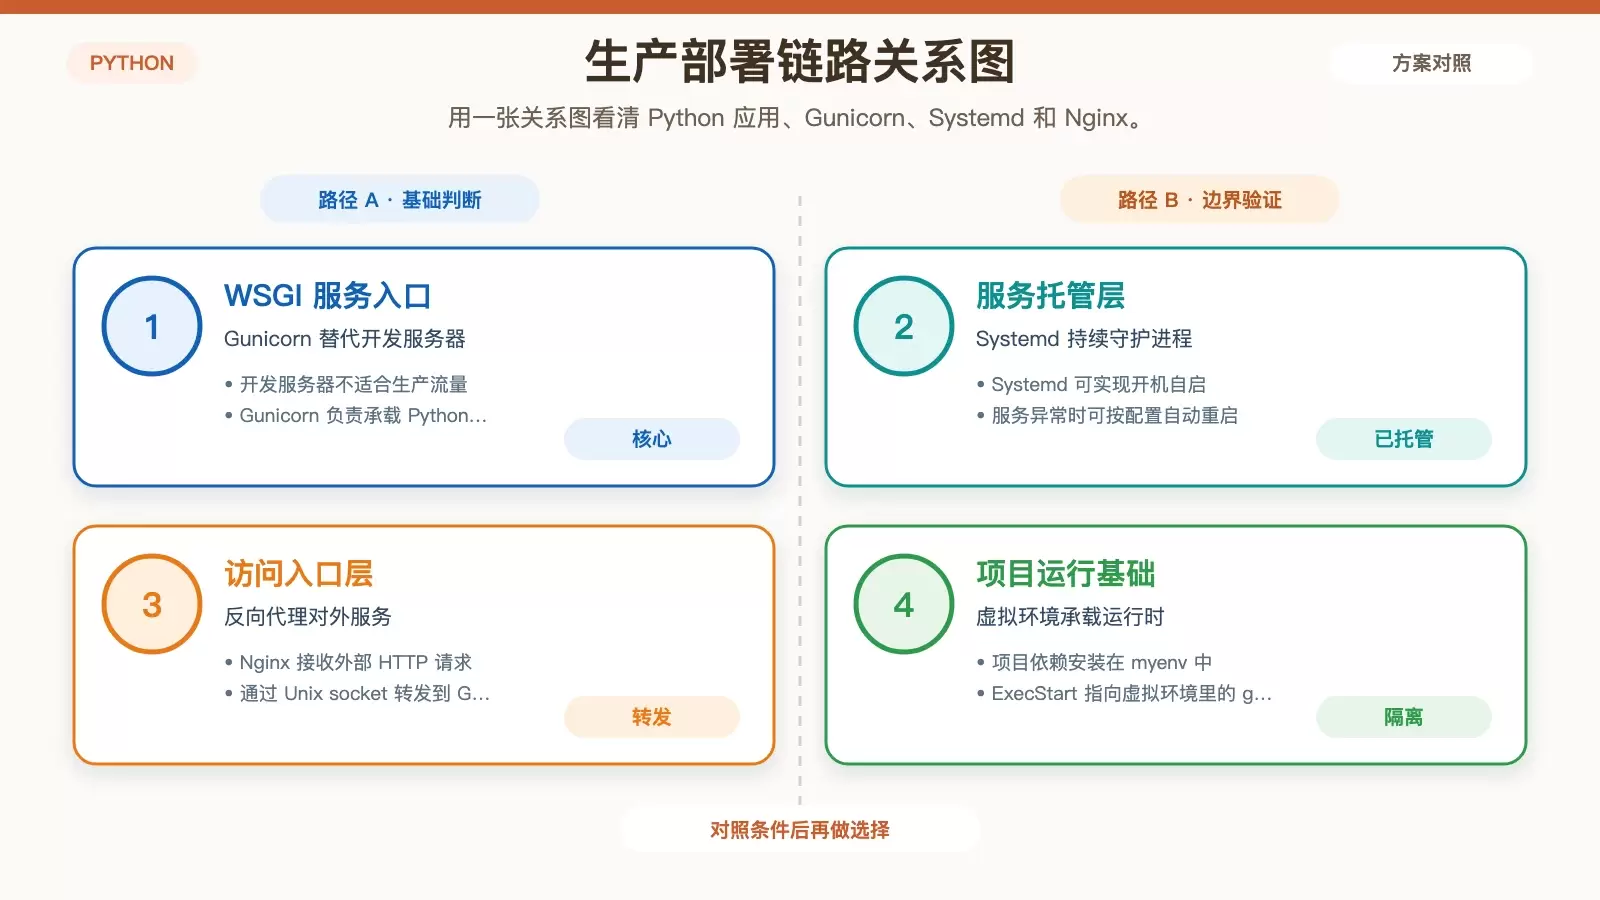
把 Python 项目部署到 Ubuntu,核心就是把开发环境、依赖安装、应用启动、Gunicorn、Systemd 和 Nginx 串成一条可复用的上线链路。本文按实际操作顺序整理命令与配置,并补上验证、排错和可选优化,适合首次上服务器时照着执行。
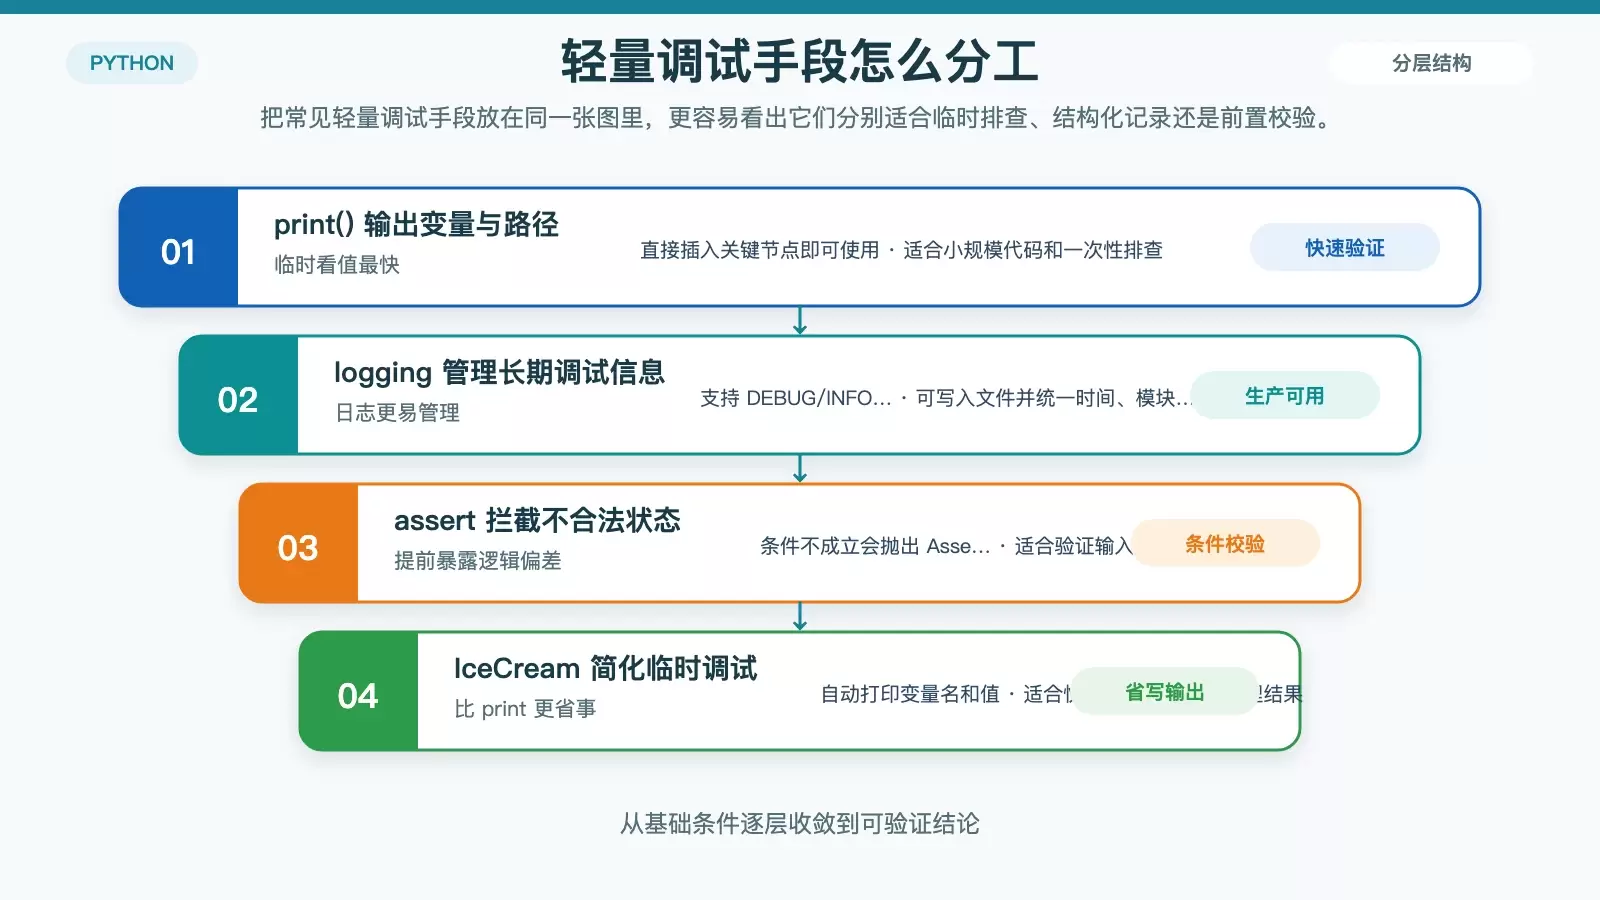
在 CentOS 上调试 Python 并不缺工具,真正难的是按场景选对方法。本文从 `print()`、`logging`、`pdb`/`ipdb`、VS Code、PyCharm 到 `assert`、IceCream、GDB 逐项梳理,帮助你判断什么场合该用快速排查,什么场合该上交互式或底层调试。 在 CentOS 上排查 Python 问题时,很多人一开始就陷入工具选择焦虑:是继续加 `print()`,还是直接进 `pdb`、切到 VS Code,甚至上 GDB。其实不同工具解决的是不同层级的问题。
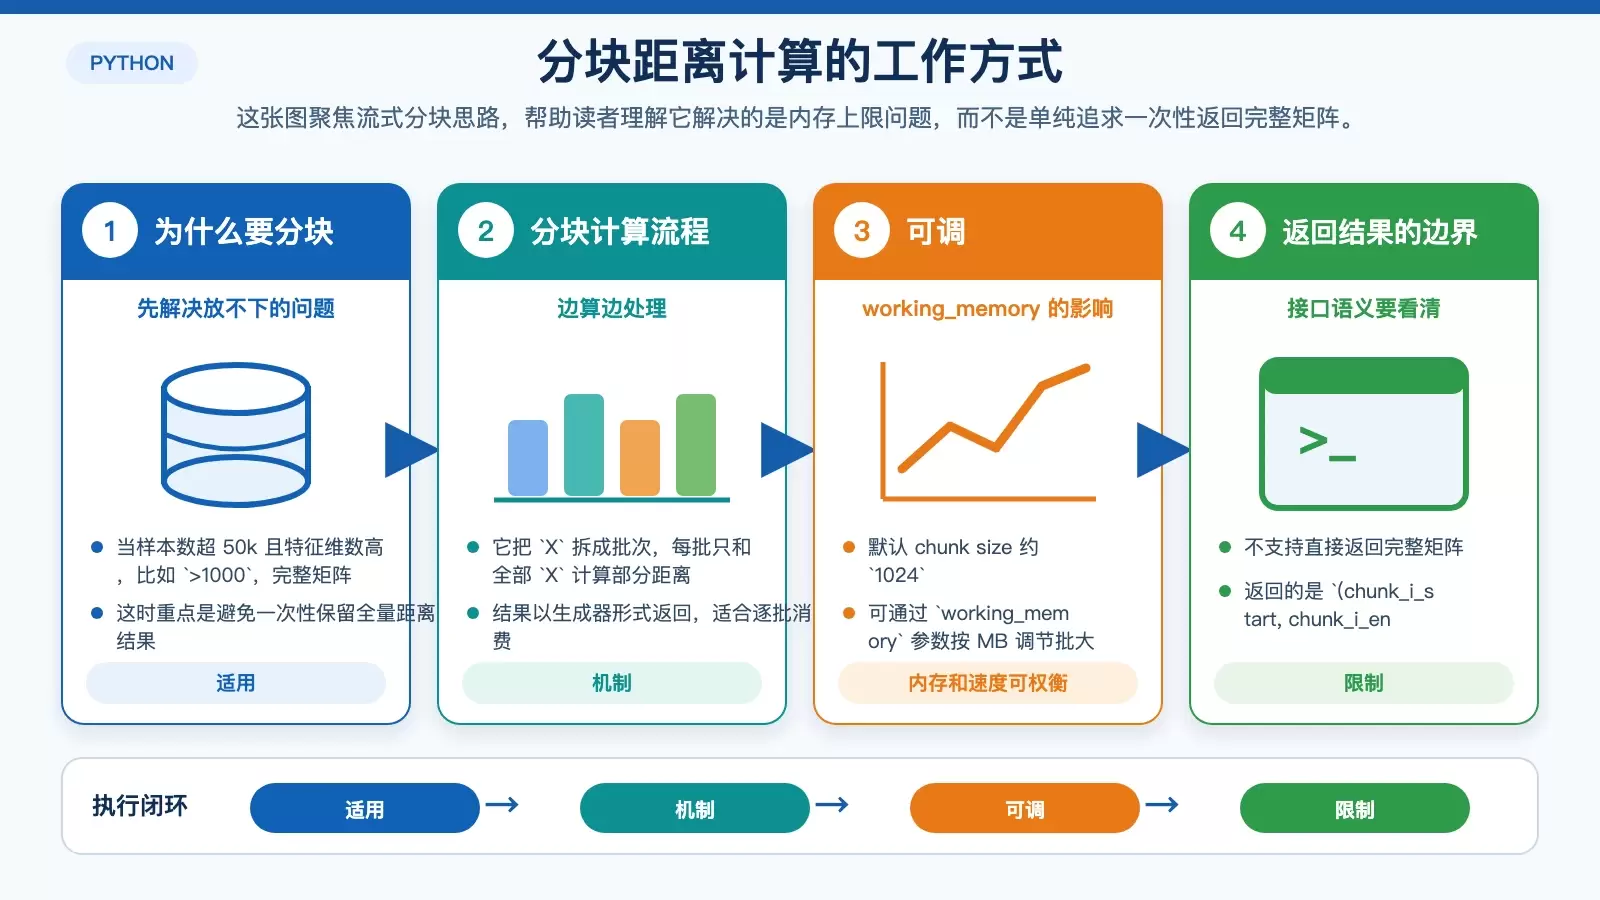
计算大规模欧氏距离矩阵时,性能问题往往不在公式本身,而在中间数组和内存占用。本文按数据规模拆解 `cdist`、`pdist`、`pairwise_distances_chunked` 与 `einsum` 的适用边界,帮助你判断什么时候该直接算、什么时候该分块、什么时候别急着上 GPU。
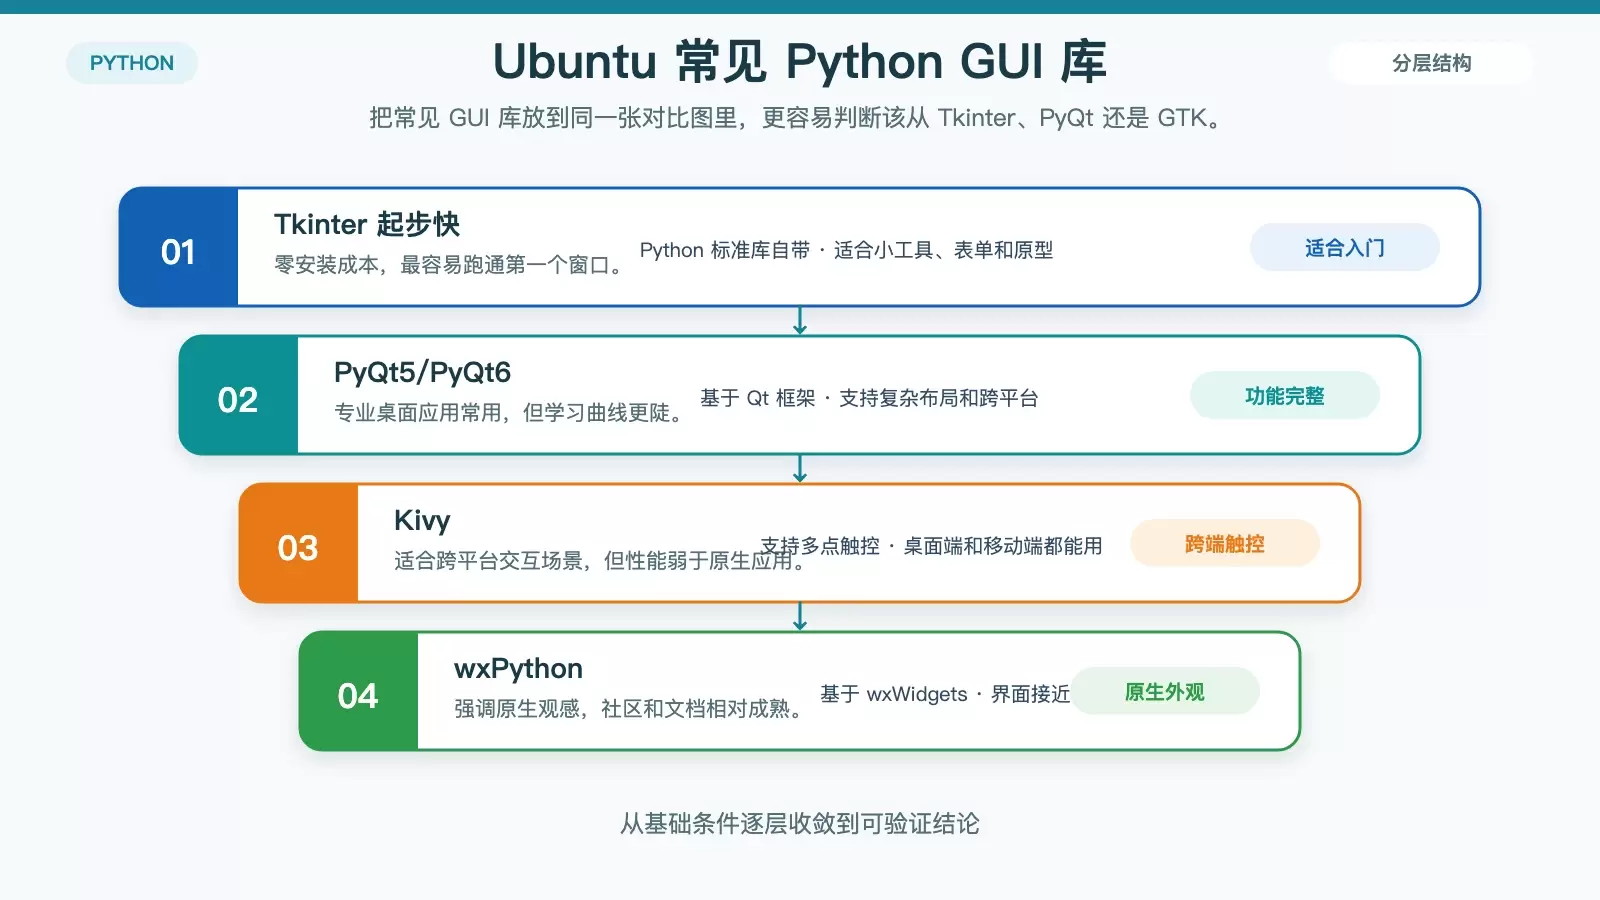
这篇文章把 Ubuntu 下的 Python 图形界面开发流程拆成三步:先配好 Python 与虚拟环境,再按项目类型选择 Tkinter、PyQt6、GTK 等库,最后用示例和实操细节把窗口、事件、资源和打包串起来。适合刚开始做桌面工具或准备从脚本转向 GUI 的开发者快速上手。
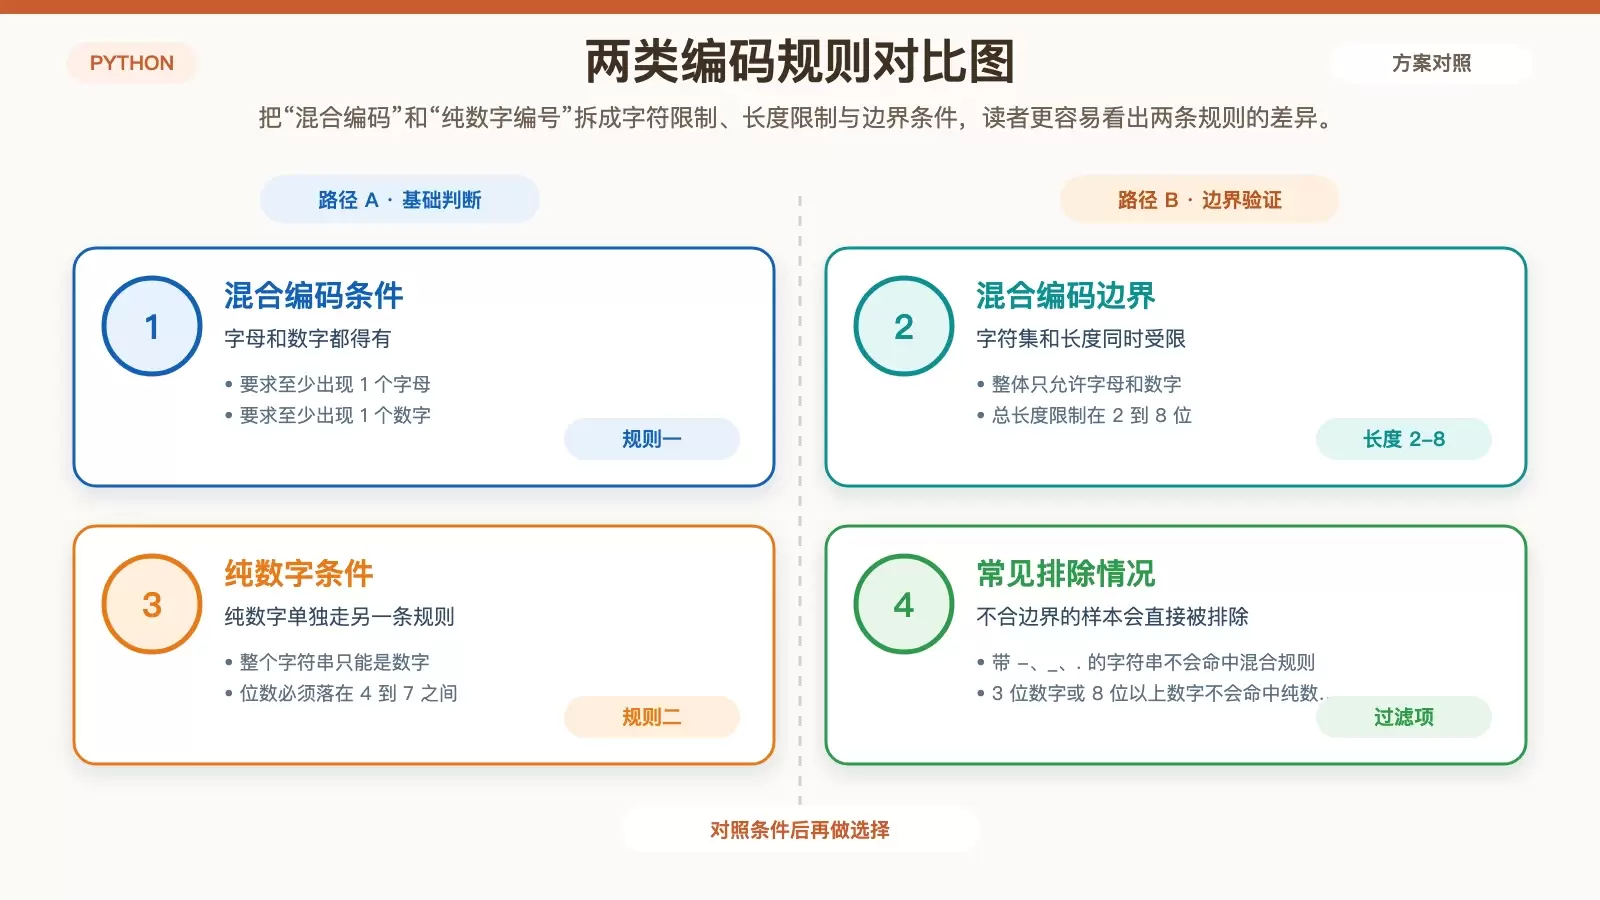
这篇文章用一个可直接运行的 Python 示例,讲清楚如何从文本里提取两类编号:2 到 8 位的字母数字混合串,以及 4 到 7 位的纯数字串。文中保留完整代码、逐段拆解正则规则,并结合测试样本说明为什么能匹配、为什么会被过滤。