


做欧氏距离矩阵时,很多人第一反应是“先向量化再说”,结果代码在小数据上跑得很顺,一上万行样本就直接 OOM。问题通常不在 NumPy 会不会算,而在你是不是无意间构造了一个巨大的中间差值张量。
这篇文章按常见场景把几种主流写法拆开讲:什么时候优先用 scipy.spatial.distance.cdist,什么时候该换成流式分块的 pairwise_distances_chunked,什么时候可以用 numpy.einsum 手动展开,以及 GPU 加速为什么经常没有预期中那么快。看完后,你可以先按内存和输出目标选工具,再决定是否值得继续优化。
为什么广播写法在大数据上容易失控
不少教程会直接写成:
np.linalg.norm(X[:, None] - X[None, :], axis=2)这种写法直观,逻辑也没错,但它的问题是会显式构造 X[:, None] - X[None, :] 这个中间数组。样本数一大,内存会立刻失控。
比如当 X 有 10k 行时,这个差值数组可能占用约 800GB 内存,按文中的估算方式是 float64 × 10⁸ × 10⁸ × 8 字节,实际运行里通常还没等算完就已经 OOM。
所以,大规模数据下的第一原则不是“先向量化”,而是先判断是否会生成 n × n × d 级别的中间结果。只要会,就要立刻换方案。
优先方案:用 scipy.spatial.distance.cdist 计算成对距离
如果你的目标就是计算两组样本之间的欧氏距离,scipy.spatial.distance.cdist 通常是首选。和纯 Python 双重循环、或者反复调用 numpy.linalg.norm 相比,它底层是 C 实现,速度更稳定,内存控制也更可靠。
from scipy.spatial.distance import cdist

D = cdist(X, X, metric='euclidean')
cdist(X, X, metric='euclidean') 的关键优势在于:它不会显式构造完整的差值张量,而是采用分块计算和缓冲复用的方式完成距离计算。这也是它比手写广播更适合大样本数据的核心原因。
什么情况下直接用 cdist
如果你的数据规模还在单机内存可承受范围内,而且你确实需要完整的两两距离矩阵,直接上 cdist 往往就是最省事的解法。
- 对上万样本做两两欧氏距离计算时,它通常比手写双重循环快得多
- 相比显式广播,内存风险更低
- 接口直接,适合生成完整矩阵后继续做聚类、分析或可视化
只算自身距离时,别混淆 cdist 和 pdist
如果你是在同一个数据集内部做两两距离,除了 cdist(X, X),还可以考虑 scipy.spatial.distance.pdist。
当你只需要下三角结果,例如去重、层次聚类这类任务,没必要总是保留完整对称矩阵。此时可以:
- 对完整矩阵再取
np.tril - 或者直接使用
scipy.spatial.distance.pdist配合squareform
这类区别看起来只是接口问题,实际会直接影响时间和内存开销。很多性能问题,根源不是算法太慢,而是把“需要完整矩阵”和“只需要唯一配对”这两件事混在了一起。
输入形状的常见报错
cdist 的输入必须是二维数组。如果你手上是一维向量,需要先 reshape 成 (n, 1),否则会报错:
ValueError: Input must be 2-dimensional例如:
X = X.reshape(-1, 1)数据再大一层:用 pairwise_distances_chunked 流式分块
即便换成 cdist,也不代表可以无限放大数据规模。样本数如果超过 50k,且特征维度很高,比如 >1000,完整距离矩阵本身就可能放不下内存。
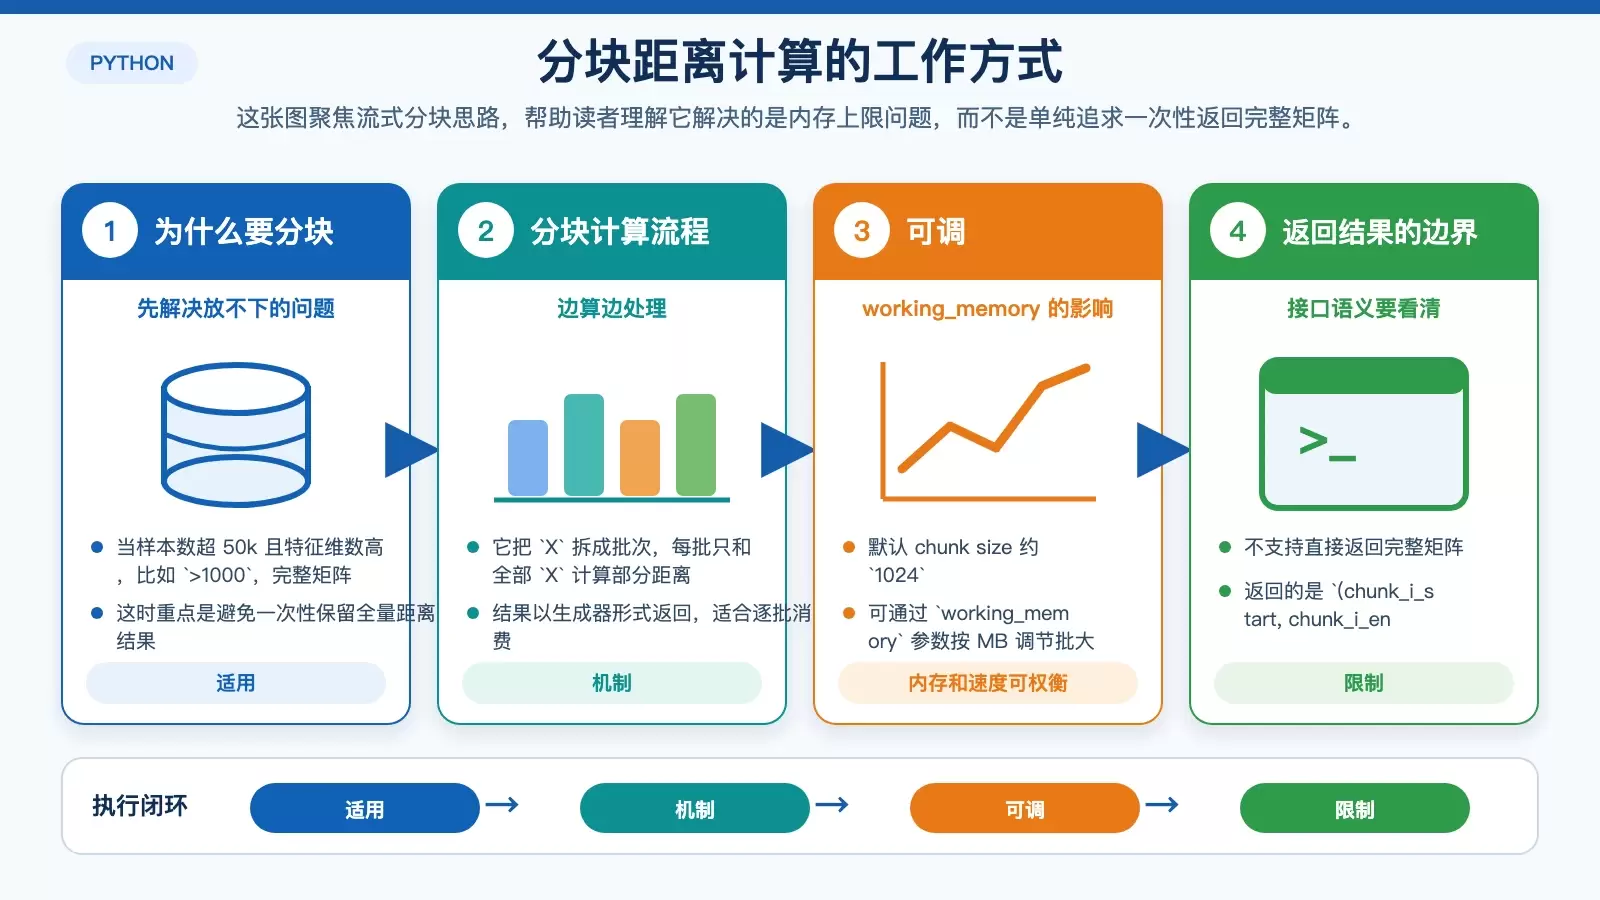
这时候问题已经不是“哪种写法更快”,而是“你根本不该一次性把全矩阵算出来”。更稳妥的做法是改用 sklearn.metrics.pairwise_distances_chunked,按块计算、按块消费结果。
from sklearn.metrics import pairwise_distances_chunked

chunks = pairwise_distances_chunked(X, working_memory=1024)
for chunk in chunks:
    # 逐批处理距离结果
    pass
它解决的不是速度,而是内存上限
pairwise_distances_chunked 会把 X 拆成批次,每一批只与全部 X 计算部分距离,然后以生成器形式返回结果。这样你可以边算边用,而不是先把完整矩阵全部落到内存里。
这类方式特别适合:
- 找最近邻
- 筛出阈值内的样本配对
- 逐块统计、逐块聚合的分析任务
使用时要注意的几个点
- 默认 chunk size 约 1024,可通过
working_memory参数调整,单位是 MB working_memory越大,批次数越少、速度通常越快,但单批内存占用也更高- 它不适合“必须直接返回完整矩阵”的场景
如果你最终就是要一个完整距离矩阵,那分块只能缓解计算过程的压力,不能改变结果本身的体积。这种情况下更现实的办法是先做降维,例如 PCA,或者先采样再计算。
别误解它的返回结果
文中提到,返回的是 (chunk_i_start, chunk_i_end, distances_array) 元组,而不是扁平结果。实际使用时,要按块位置去理解结果属于哪一段样本,而不是把它当成一次性算完的数组。
numpy.einsum 可作为中等规模的折中方案
如果你不打算引入 SciPy 或 Scikit-learn,或者需要完全控制计算逻辑,比如加自定义权重,那么可以用手动展开平方距离的方式,避开显式广播。
dist_sq = np.einsum('ij,ij->i', X, X)[:, None] +
np.einsum('ij,ij->i', X, X)[None, :] -
2 * X @ X.T
dist = np.sqrt(np.maximum(dist_sq, 0))
这里利用的是:
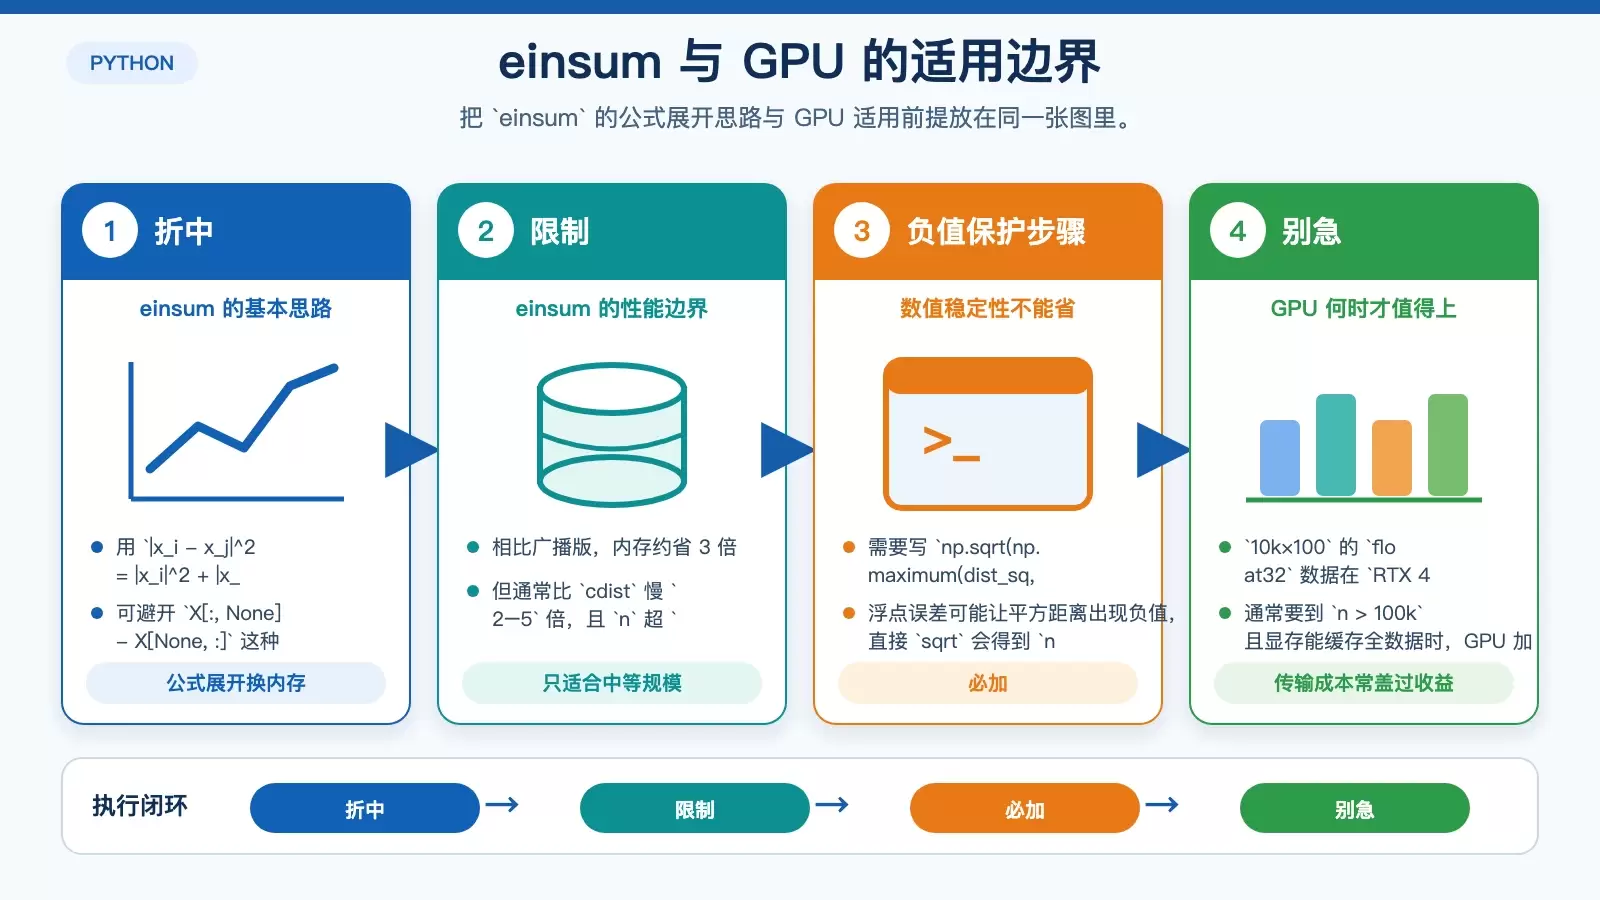
|x_i - x_j|^2 = |x_i|^2 + |x_j|^2 - 2x_i^top x_j这样就能绕开 X[:, None] - X[None, :] 那个危险的三维中间数组。
它省内存,但不是万能替代品
- 相比广播版,内存大约可省 3 倍
- 但相比
cdist,通常会慢 2–5 倍,原因是 NumPy 解释器开销更高 - 当特征维度较高时,
X @ X.T仍然会带来O(n^2d)级别压力,n超过 20k 仍会吃紧
别漏掉数值稳定性处理
这一写法里,下面这行不能省:
np.maximum(dist_sq, 0)原因是浮点误差可能让理论上应为 0 的位置变成很小的负数,直接 sqrt 就会产生 nan。这个保护步骤看起来不起眼,但在实际批量计算里非常关键。
GPU 不一定更快,先定位真正瓶颈
遇到距离计算变慢,很多人会直接想到 cupy、numba 或 GPU 加速。但欧氏距离这类任务,瓶颈经常不在算力,而在数据搬运和内存带宽。
文中的测试结论很直接:对 10k×100 的 float32 数据,在 RTX 4090 上使用 cupy 版 cdist,反而比 CPU 慢 1.2 倍,因为 PCIe 传输耗时超过了计算节省的时间。
只有当 n > 100k,并且 GPU 显存足够缓存全量数据时,加速效果才会更明显。
上 GPU 前先检查这三件事
- 用
time.perf_counter()分段测加载、计算、保存耗时,先确认瓶颈在哪 cupy要求数组已经在 GPU 上,从 NumPy 拷贝过去本身就有延迟- 如果目标是近似最近邻,
faiss这类 CPU/GPU 通用库通常比“硬算精确全距矩阵”更合适
实战里怎么选工具更稳妥
把这几种方案放在一起看,选择逻辑其实很明确:
- 需要完整距离矩阵,且内存还能承受:优先
scipy.spatial.distance.cdist - 只需要数据集内部唯一配对或下三角结果:考虑
pdist+squareform - 数据规模太大,无法一次性保留完整矩阵:用
pairwise_distances_chunked边算边处理 - 需要自定义逻辑,且数据规模处于中等范围:可考虑
numpy.einsum展开公式 - 想上 GPU:先确认瓶颈是否真的在计算,而不是在传输或内存
真正决定成败的,往往不是你会不会写“向量化”,而是有没有先估算内存、分清 cdist 和 pdist 的语义,以及是否真的需要完整矩阵。小数据时怎么写都能跑,大规模场景下,先选对工具链,再谈优化才有意义。









