Python正则表达式实战:从HTTP日志中精准提取关键字段
本文详解如何利用Python的re模块处理海量日志文件。通过具体代码示例,演示如何精准提取HTTP请求方法、URL、时间戳及状态码,并介绍使用列表推导式过滤特定关键词日志。此外,文章还涵盖了复杂日志的多字段解析、异常信息提取以及结合requests与定时任务实现日志处理自动化的完整流程。
2026-10-10
10

本文详解如何利用Python的re模块处理海量日志文件。通过具体代码示例,演示如何精准提取HTTP请求方法、URL、时间戳及状态码,并介绍使用列表推导式过滤特定关键词日志。此外,文章还涵盖了复杂日志的多字段解析、异常信息提取以及结合requests与定时任务实现日志处理自动化的完整流程。
本文详细解析了Python中实现单例模式的四种常见方式:类装饰器、__new__方法、工厂函数以及functools.lru_cache。通过代码示例对比了各方案的优缺点,并探讨了在工程实践中如何平衡透明性、可控性与可测试性,最终给出避免过度设计的建议。
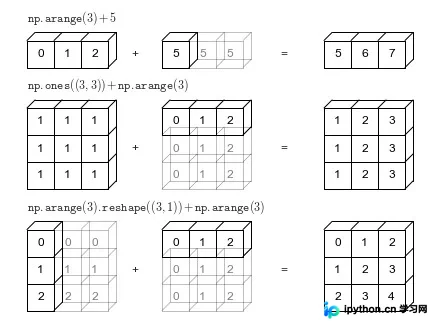
本文深入解析NumPy中的广播(Broadcasting)机制,阐述其如何通过形状匹配规则实现不同维度数组的高效逐元素运算。文章详细解读了广播的三条核心规则,并通过多维数组相加、数据中心化及二维函数绘图等实例,展示广播在避免显式循环、提升计算性能方面的关键作用。
本文深入解析如何利用NumPy从零构建轻量级图片旋转检测算法。通过灰度化、去噪增强、行/列方差统计分析及坐标变换,无需OpenCV或深度学习模型即可判断图像倾斜角度。文章提供完整代码实现与优化技巧,适用于文档校正与自动化办公场景。
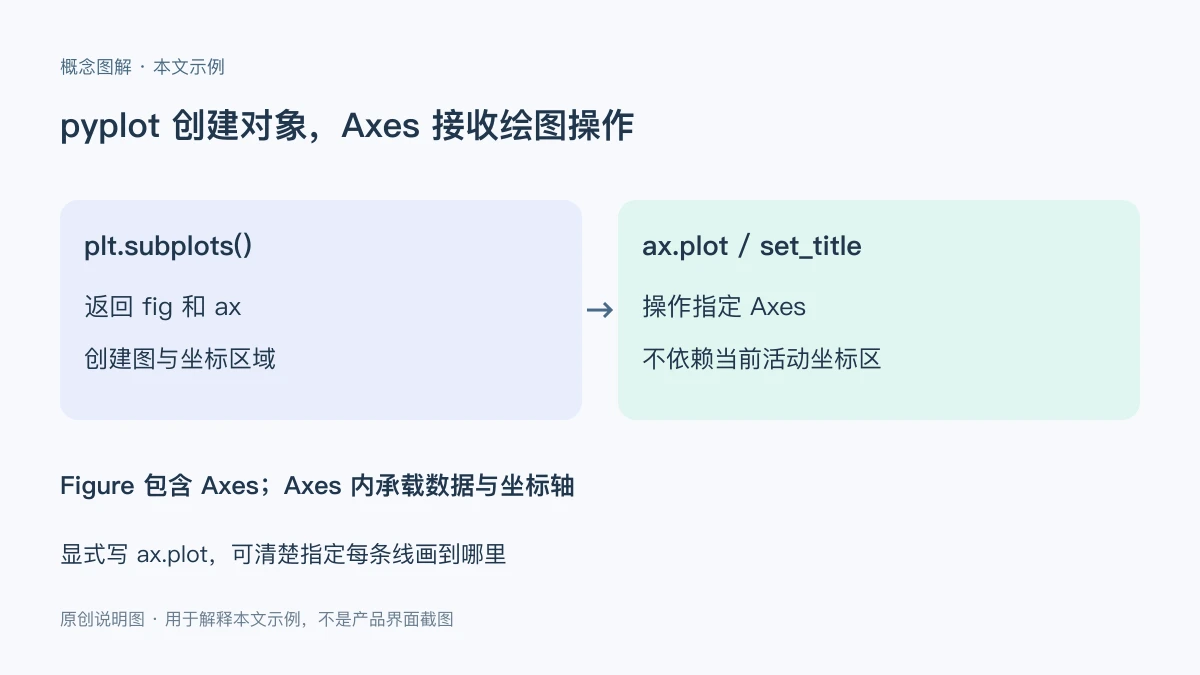
Matplotlib 是绘图库,pyplot 是其中的一套接口,二者不是互相替代的两个库。快速画一张图可以使用 pyplot;需要多子图或可复用函数时,显式持有 Figure 和 Axes 往往更清楚。常见写法是用 pyplot 创建图,再用 Axes 方法设置内容。
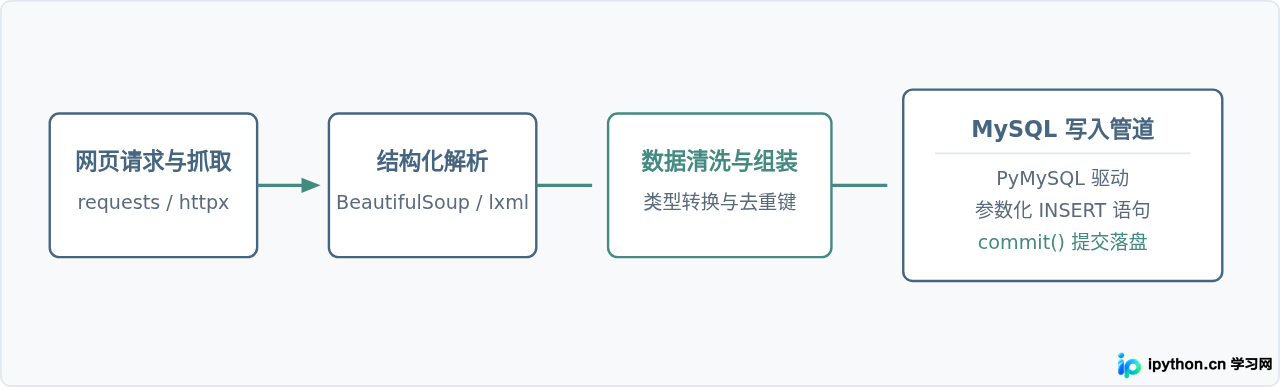
详细讲解Python网络爬虫如何将抓取并清洗后的结构化数据规范写入MySQL数据库,涵盖表结构设计、PyMySQL连接、参数化SQL、批量插入优化及异常重试机制。
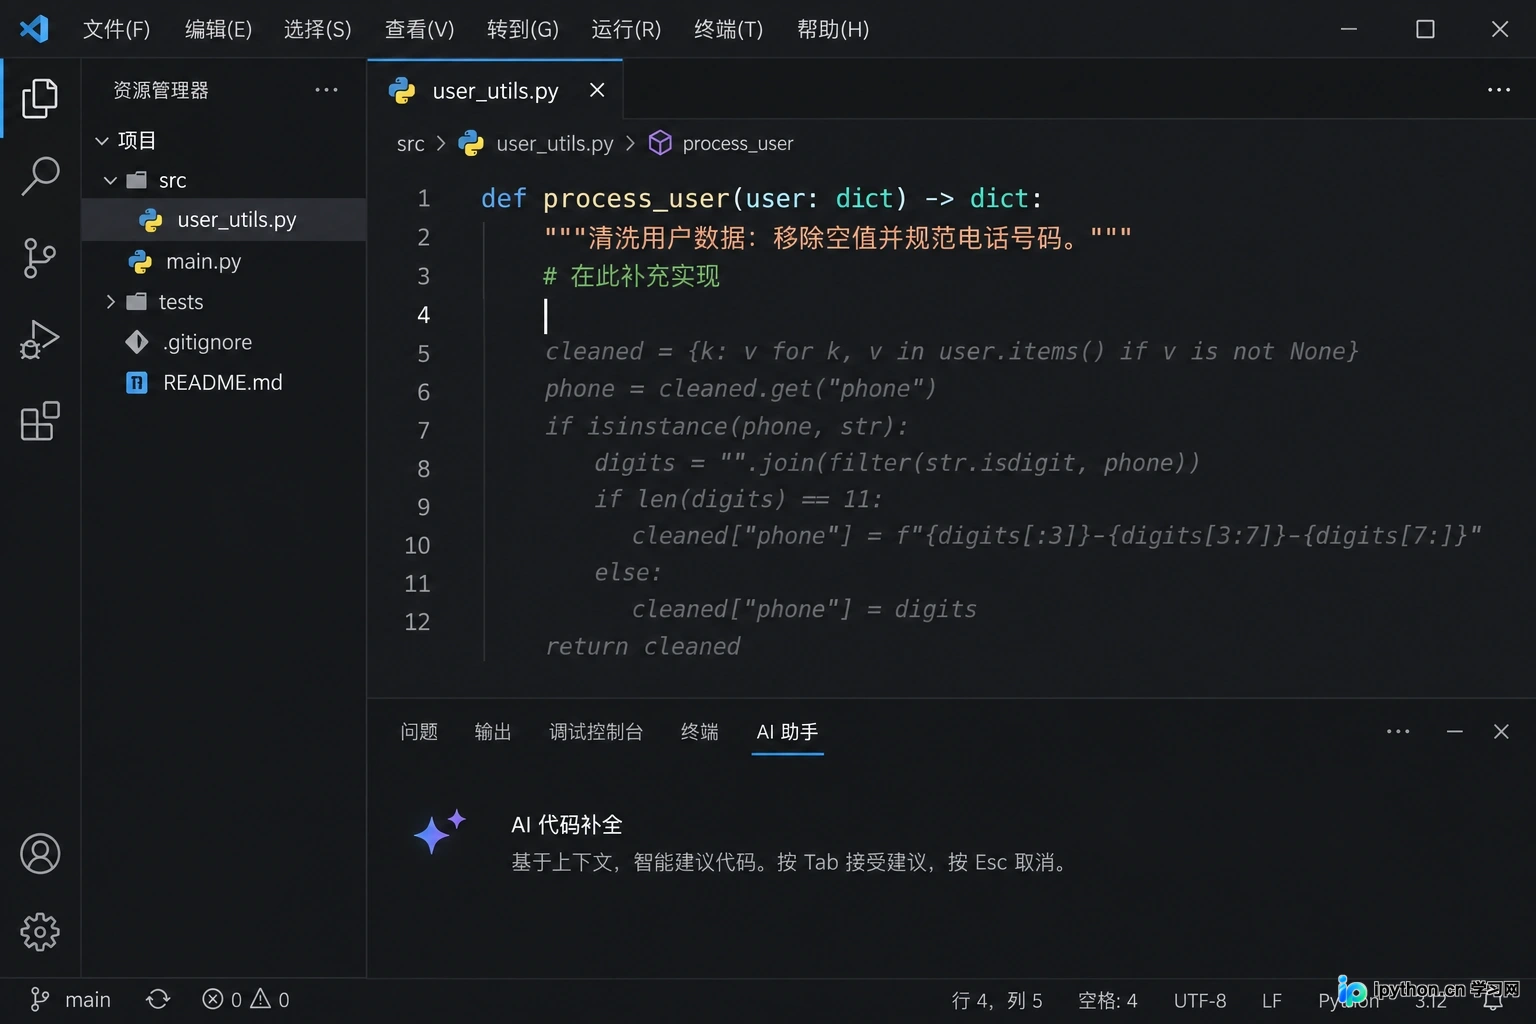
本文通过代码补全、错误诊断和单元测试生成三个实战场景,展示如何利用DeepSeek-Coder提升编程效率。文章以轻松实用的风格,指导开发者如何精准提问、解读模型反馈并快速落地修复方案,避免常见的使用误区。
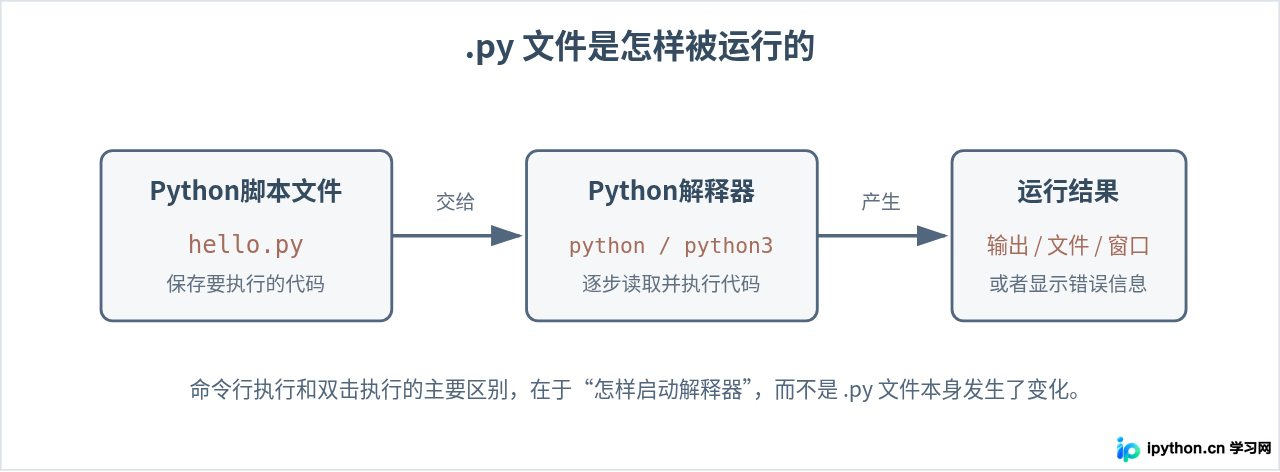
介绍Python怎么运行.py脚本文件,分别讲解Windows、macOS和Linux下通过命令行执行Python脚本的方法,并说明命令行运行与双击运行的区别、路径问题、参数传递和窗口闪退等常见问题。
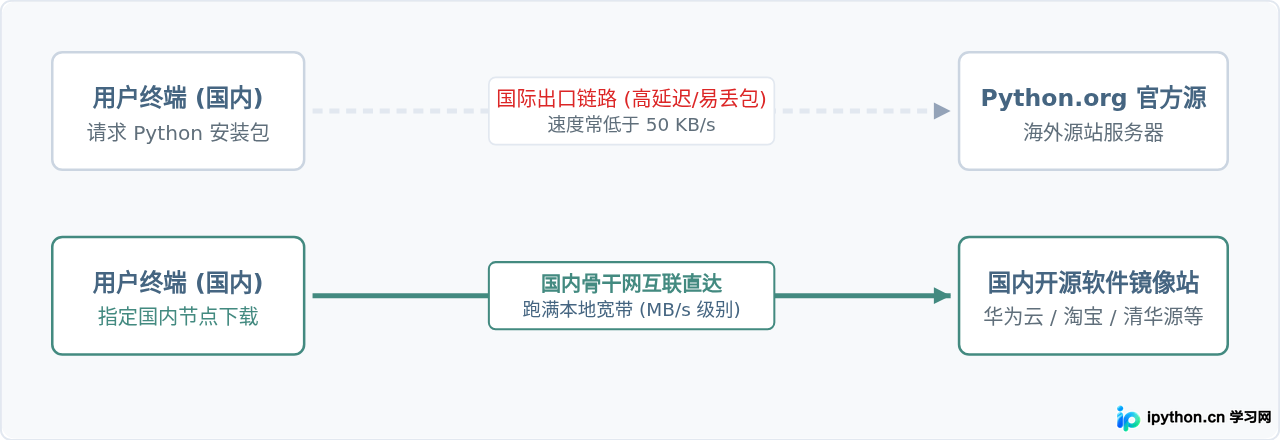
针对国内访问Python官方网站下载安装包速度极慢、连接超时等问题,本文详解慢速根源,提供国内高校与主流云厂商镜像站直接下载安装包的完整步骤,以及配套的pip国内源加速配置方案。
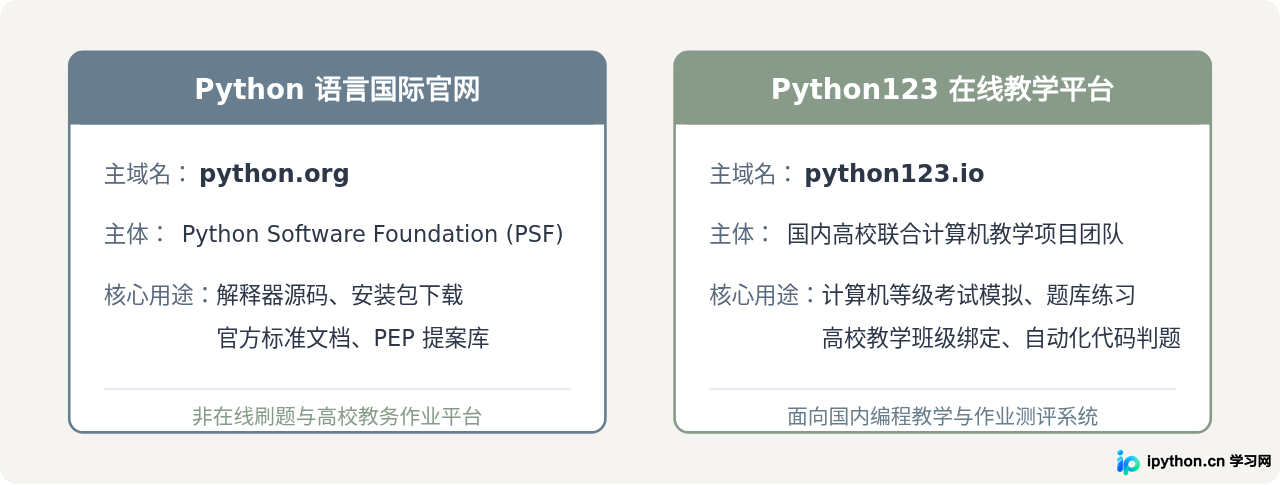
针对高校学生与Python学习者,提供一套系统、实用的Python123官方网站辨别方法,涵盖顶级域名验证、备案资质核对、平台功能特征及高频混淆场景防范。
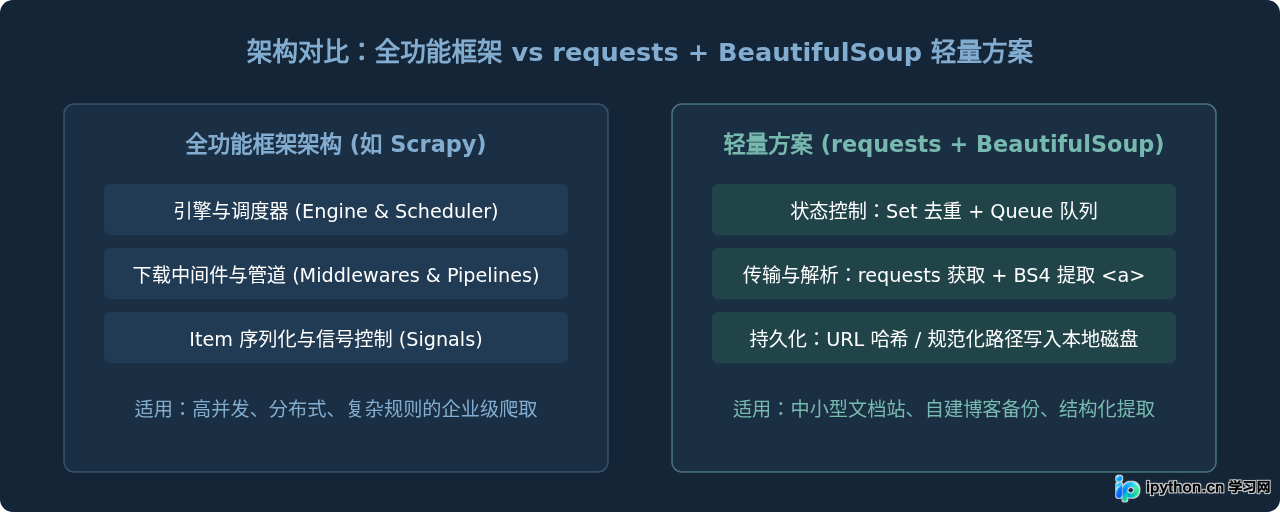
本文讲解如何仅使用 Python 标准库配合 requests 与 BeautifulSoup 两个轻量模块,实现从单个入口页出发、递归抓取全站链接并批量将 HTML 页面持久化到本地磁盘的完整方案。