

Python爬虫抓取煎蛋网图片并保存本地实战
本文介绍使用Python编写爬虫程序,自动抓取煎蛋网(jandan.net)上的图片并保存至本地文件夹。通过解析网页HTML获取图片链接,利用urllib库发起请求并下载图片文件,支持指定页数批量处理。代码包含页面解析、图片地址提取及文件保存逻辑,适合Python初学者学习网络爬虫基础操作。
2026-10-13
9

本文介绍使用Python编写爬虫程序,自动抓取煎蛋网(jandan.net)上的图片并保存至本地文件夹。通过解析网页HTML获取图片链接,利用urllib库发起请求并下载图片文件,支持指定页数批量处理。代码包含页面解析、图片地址提取及文件保存逻辑,适合Python初学者学习网络爬虫基础操作。
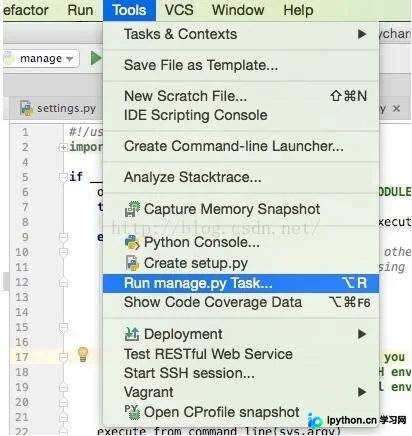
本文详细讲解在PyCharm环境下新建Django项目后,如何创建Admin后台登录所需的超级用户。通过manage.py执行makemigrations和migrate初始化数据库,随后运行createsuperuser命令设置用户名与密码,即可正常访问127.0.0.1:8000/admin页面。
本文介绍如何在Python中将日期时间对象转换为特定格式的字符串。通过datetime.datetime.now()获取当前时间,并利用strftime方法分别演示了输出包含年月日时分秒、仅年月日小时分钟以及纯数字年月日的三种常见格式,代码示例清晰展示了具体用法。
本文介绍基于Python构建分布式测试框架的方案,利用主控机调度与执行机RPC调用实现扩展性。通过SimpleXMLRPCServer部署服务,结合多进程(fork)与多线程技术,在多个节点上并行执行测试任务,有效弥补Python执行效率的不足,实现高并发压力测试。
本文介绍如何在Django项目中利用JavaScript实现页面的局部刷新。通过为表格设置特定ID,结合jQuery的$.post方法向后端发送IP参数,并在回调函数中动态替换指定DOM元素的HTML内容,从而在不重载整个页面的情况下更新进程信息表格,提升用户体验。
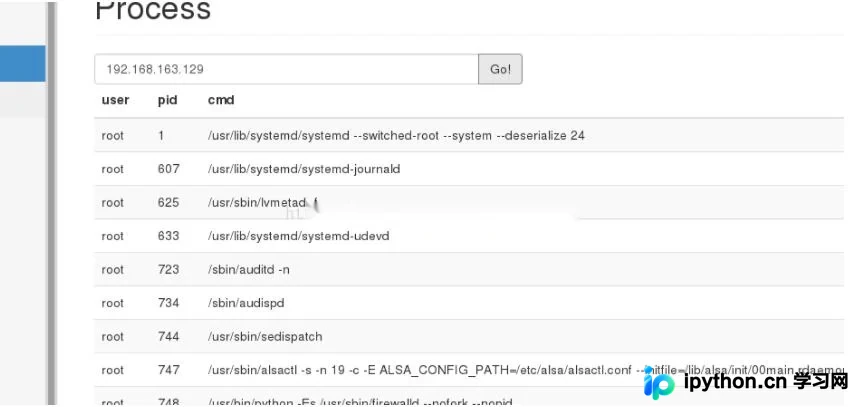
本文介绍在Django项目中如何利用JavaScript动态加载子页面并传递参数。核心思路是通过JS函数调用jQuery的load方法,指定目标URL片段及DOM选择器,实现局部刷新与数据交互。文中详细解析了父页面与子页面URL的拼接规则,以及通过ID选择器传递额外参数的具体实现方式,为前端交互提供简洁高效的解决方案。
本文深入解析Python中的面向对象核心概念,重点对比继承与组合两种代码复用方式。详细阐述Python3中所有类默认继承object的新式类特性,并通过Teacher与Student类的具体代码示例,展示如何利用继承减少重复代码。同时介绍组合在对象属性管理中的应用,以及使用abc模块定义抽象基类以强制子类实现特定接口的规范做法。
本文深入解析Django中文件上传的处理机制,涵盖HttpRequest.FILES的读取、UploadedFile类的属性与方法,以及通过Form和Model两种方式存储文件的完整流程。内容包含手动处理、Form表单验证及ModelField自动保存的代码示例,帮助开发者实现灵活且安全的文件上传功能。
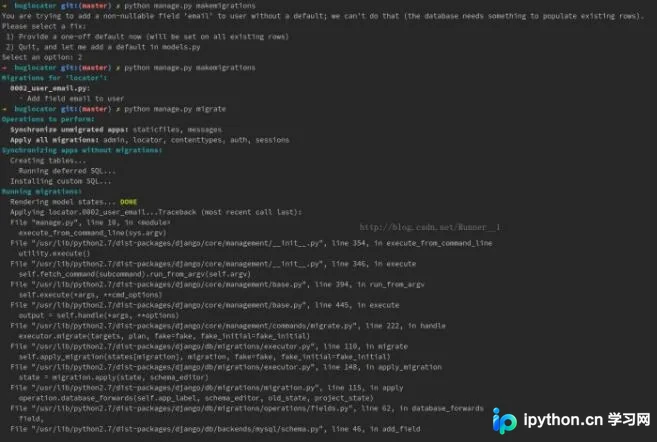
本文介绍在 Django 开发中删除数据库表后重新同步时遇到的常见错误。当 makemigrations 和 migrate 命令因字段默认值或迁移文件异常而失败时,可通过 python manage.py sqlmigrate 命令生成 SQL 语句,并在数据库中手动执行以创建新表,从而绕过框架同步问题并正常启动应用。
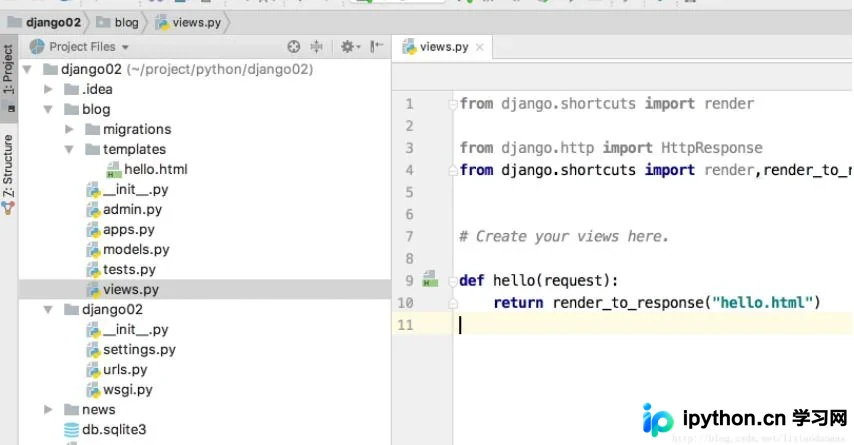
本文介绍在Django框架中如何加载本地HTML文件,并通过视图函数向模板传递数据。通过定义Python对象和字典,利用render_to_response将标题、用户信息及列表内容传递给HTML模板,实现动态数据展示。
本文介绍了如何在 Python 中使用 matplotlib 库绘制柱状图,并通过设置 y 轴刻度来直接显示具体的数据值。通过导入 matplotlib 和 numpy,创建图形对象及子图,利用 bar 函数生成柱状图,最后调用 yaxis.set_ticks 方法将纵坐标刻度设定为数据数组,实现数值可视化展示。
本文介绍了在 matplotlib 中使用 subplots 时如何设置总图标题。通过 fig.suptitle 方法,可以指定标题文本、字号及坐标位置,例如设置字体大小为 16,并调整 x 和 y 轴偏移量以实现最佳视觉效果。