详解Python如何利用Shelve进行数据存储
介绍Python标准库shelve模块的存储原理、核心用法及注意事项。通过字典式API演示数据的创建、读写、更新与删除操作,并附带命令行待办事项应用示例。适合小型配置管理、本地缓存及轻量级数据库场景,同时说明其并发限制与内存占用问题,帮助开发者快速搭建文件级数据持久化方案。
2026-10-11
10

介绍Python标准库shelve模块的存储原理、核心用法及注意事项。通过字典式API演示数据的创建、读写、更新与删除操作,并附带命令行待办事项应用示例。适合小型配置管理、本地缓存及轻量级数据库场景,同时说明其并发限制与内存占用问题,帮助开发者快速搭建文件级数据持久化方案。
本文详解如何通过pgAdmin配置PostgreSQL服务器与数据库,并结合ConfigParser创建配置文件。随后演示使用psycopg2库在Python中解析配置、建立数据库连接、执行版本查询及安全释放资源的标准流程,助力开发者快速完成环境搭建与数据交互开发。
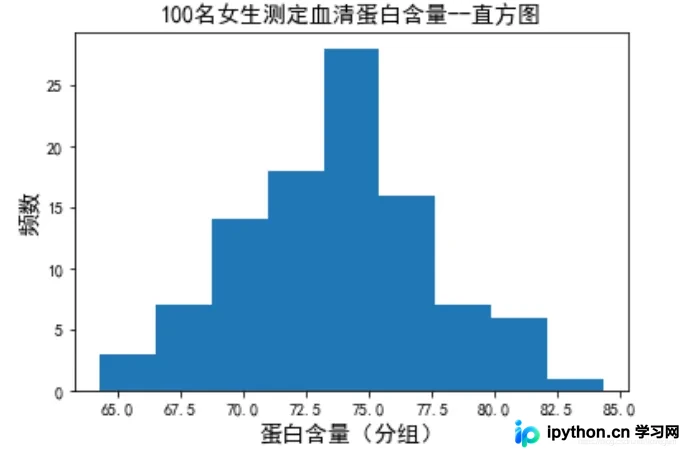
本文详细解析Python中matplotlib.pyplot.hist函数用于绘制直方图的输入参数、返回值含义及调用方法。通过一维数组处理、分组柱数设置、颜色透明度配置等核心参数说明,结合读取CSV数据、扁平化转换与图表美化的完整代码示例,帮助读者快速掌握频数统计绘图流程及对象属性提取技巧。
本文介绍如何使用Python与Pillow库实现单张及批量图片裁剪。涵盖环境准备、坐标定义规范、单图裁剪逻辑及带文件夹遍历的批量处理方案。通过自动计算边界并统一输出格式,快速完成图像预处理任务,显著降低人工操作成本。
本文详解 Python 标准库 Tkinter 的核心用法,涵盖主窗口初始化、常用控件添加、鼠标键盘事件绑定以及 pack/grid/place 三种布局管理器的实际应用。通过完整可运行的代码示例,帮助开发者快速搭建轻量级桌面图形界面程序。
本文详细讲解如何使用Python中的psycopg2库安全连接PostgreSQL数据库,并通过参数化查询完成建表、数据插入、记录更新、表数据清理与删除以及结果集读取等核心操作。内容包含完整的代码片段、关键参数说明与常见陷阱规避指南,助您快速搭建Python与PostgreSQL的数据交互流程。
讲解如何借助Python的theffuzz库解决名称拼写不一、格式混乱带来的字符串匹配难题。涵盖环境配置、fuzz模块四种核心相似度算法的适用场景,以及process模块在列表批量提取与自定义打分器中的应用,附完整可运行代码与性能优化建议。
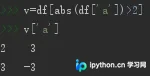
本文详细讲解在 Pandas DataFrame 列中按条件筛选和查找数据的方法。通过 .where() 方法与布尔索引实现跨列条件判断、绝对值过滤及数值比对,附完整代码示例与输出结果说明,帮助开发者快速处理特征数据。
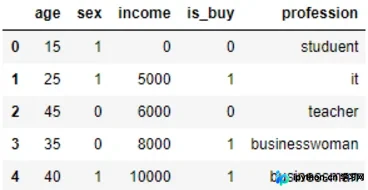
在模型训练前,通常需要将数据集划分为训练集和测试集。本文详解了如何使用 Pandas 精准提取自变量 X 和因变量 y,并结合 scikit-learn 的 train_test_split 函数,通过调整 test_size 与 random_state 参数,高效实现按比例的数据拆分。
本文详解如何利用 Python 的 python-can 读取汽车电子常用的 BLF 二进制日志,配合 cantools 加载 DBC 协议文件将原始十六进制报文自动解码为可读信号值。内容涵盖依赖安装、报文遍历、信号聚合及按需导出为 MF4 或 CSV 格式的完整流程,并提供常见报错排查方案。
本文系统讲解 Python 字符串的定义与多引号声明方式,剖析零索引、不可变性及 ASCII 映射原理。逐步演示 split、strip、find、maketrans 等核心方法的参数配置与返回结果,结合切片遍历、关系比对与 f-string 格式化提供完整实操示例,并针对类型转换异常与子串查找失败给出排查方案。
NumPy 提供了 savetxt 和 loadtxt 两个基础函数,专门用于内存数值数组与磁盘文本文件的快速转换。通过合理配置分隔符、编码格式及列索引,可高效实现 CSV 或空格制表文件的读写,避免手动拼接字符串带来的格式错误。