Python序列化详解:JSON与Pickle的使用对比
本文介绍Python中的序列化概念,重点对比JSON与Pickle两种常用序列化方式。JSON适用于跨语言数据交换,轻量且通用;Pickle专用于Python对象持久化,支持所有Python数据类型。文章提供具体代码示例,展示dumps/dump与loads/load方法的使用,帮助开发者理解不同场景下的最佳实践。
2026-10-13
9

本文介绍Python中的序列化概念,重点对比JSON与Pickle两种常用序列化方式。JSON适用于跨语言数据交换,轻量且通用;Pickle专用于Python对象持久化,支持所有Python数据类型。文章提供具体代码示例,展示dumps/dump与loads/load方法的使用,帮助开发者理解不同场景下的最佳实践。
本文详细介绍如何使用 pyenv 在 Linux 环境下管理多个 Python 版本。通过安装 pyenv 插件、配置环境变量,实现不同 Python 版本的自由切换。同时结合 virtualenv 功能,演示如何创建、激活和删除特定版本的虚拟环境,解决多项目依赖冲突问题。
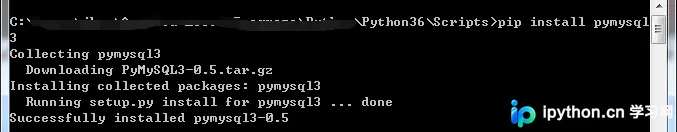
本文介绍Python3环境下连接MySQL数据库的方法。由于原生模块限制,推荐使用PyMySQL库。文章详细讲解了通过pip安装PyMySQL的步骤,并提供了完整的Python连接数据库、执行SQL语句、处理数据及异常回滚的代码示例,帮助开发者快速实现数据库交互。
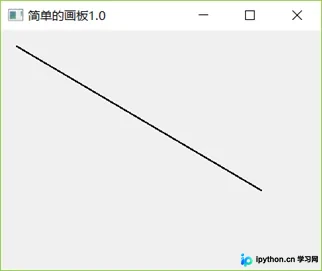
本文介绍基于Python3和PyQt5开发简易画板的完整过程。通过四个迭代版本,逐步实现定点连线、轨迹保留、连续笔画处理及断点隔离功能。重点解析paintEvent与鼠标事件机制,提供解决数字书写粘连问题的断点算法,适合PyQt初学者参考。
本文详细讲解如何利用Python的requests和BeautifulSoup库,系统性地爬取安居客郑州地区的二手房源数据。内容涵盖列表页HTML结构分析、房源链接提取、分页逻辑处理(递归调用与下一页判断)以及详情页数据抓取。通过具体代码示例,展示如何构建完整的爬虫流程,包括请求头设置、DOM节点定位及数据清洗,为地理信息分析提供数据支持。
本文详细介绍Python标准库logging的使用。涵盖将日志打印至屏幕、通过basicConfig配置文件名与格式、同时输出至屏幕和文件,以及使用配置文件管理多Logger的方法。解析DEBUG至CRITICAL各级别含义及格式字符串参数,帮助开发者实现优雅高效的日志记录。
本文深入解析Python中id()函数的核心作用,指出其返回对象在内存中的唯一地址。通过对比is与==运算符,阐明is用于比较内存地址(对象身份),而==用于比较值相等性。结合CPython实现细节,说明复合类型与基础类型在id变化上的差异,帮助开发者准确理解对象引用机制。
本文深入解析Python中值类型与引用类型的本质区别。值类型(如字符串、元组)不可变,修改变量仅改变指向;引用类型(如列表、字典)可变,修改内容不影响原对象地址。通过代码示例展示内存ID变化,并介绍使用分片操作进行浅拷贝的技巧,帮助开发者避免常见的引用陷阱。
本文详解Python中import、reload和__import__三个模块导入机制的区别。import用于常规导入,不重复加载;reload用于强制重新加载已导入模块,常用于模块文件修改后或sys模块编码处理等特殊场景;__import__是底层导入函数,接收字符串参数,支持动态模块加载。通过实例对比,帮助开发者理解不同场景下的最佳实践。
本文介绍如何使用Python的openpyxl库进行Excel文件操作。内容涵盖工作簿的创建、加载与保存,工作表的获取、创建及重命名,以及单元格的读取、写入和多行数据处理。通过具体代码示例,展示如何利用openpyxl高效完成Excel文件的自动化处理任务。
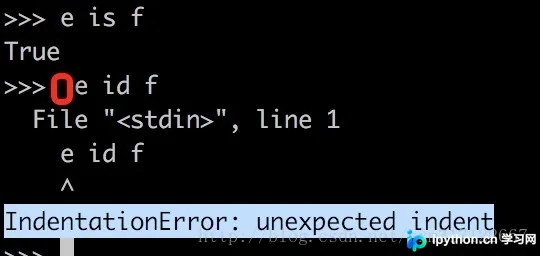
本文解析Python中常见的“IndentationError: unexpected indent”错误。该错误通常由Tab与空格混用或多余缩进引起,例如在变量名前误加空格。通过删除多余空格即可修复,确保代码缩进规范是避免此类问题的关键。
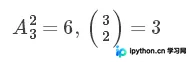
本文介绍Python中实现排列组合计算的两种常用方法。通过scipy库的perm和comb函数可直接获取排列组合的具体数值;利用itertools模块的permutations和combinations函数则可生成所有可能的排列或组合情况。文中附带代码示例及在线计算工具推荐,供开发者参考。