Python回溯算法实现全排列:深拷贝与浅拷贝陷阱解析
本文通过Python回溯算法实现全排列的实例,深入剖析了列表引用传递导致的常见错误。重点对比了使用path.pop()直接修改原列表与使用path[:-1]生成新对象的区别,解释了为何直接追加path会导致结果异常,并揭示了递归过程中变量作用域与对象引用的关键机制,帮助开发者避免此类逻辑陷阱。
2026-10-15
8

本文通过Python回溯算法实现全排列的实例,深入剖析了列表引用传递导致的常见错误。重点对比了使用path.pop()直接修改原列表与使用path[:-1]生成新对象的区别,解释了为何直接追加path会导致结果异常,并揭示了递归过程中变量作用域与对象引用的关键机制,帮助开发者避免此类逻辑陷阱。
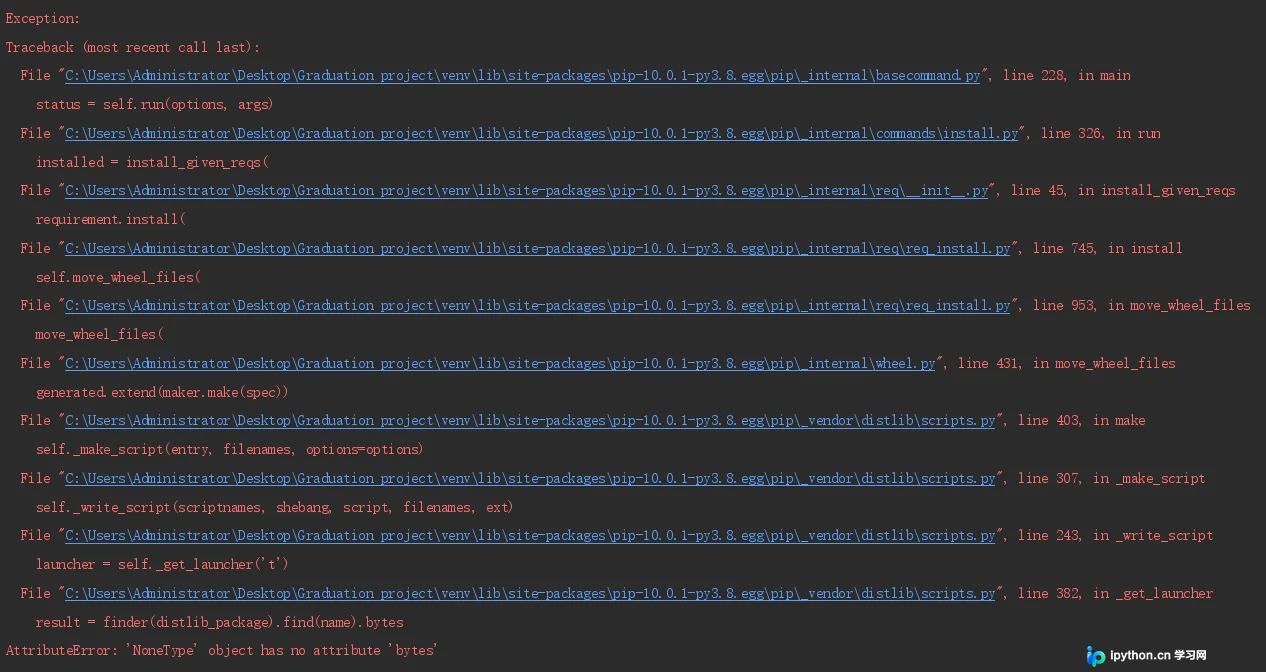
本文解决PyCharm中执行pip升级命令时出现的AttributeError: 'NoneType' object has no attribute 'bytes'错误。通过提供easy_install -U pip命令及降级pip至9.0.3的备选方案,帮助用户快速恢复Python包管理功能。
本文详解Python中文件读写的核心技巧。涵盖open函数的'r'、'w'、'x'、'a'等打开模式,对比read、readline与readlines的读取差异,以及write与writelines的写入区别。重点介绍使用finally和with语句管理文件句柄的最佳实践,避免资源泄露,提升代码简洁性与安全性。
本文深入解析Python标准库os模块在文件与路径管理中的核心应用。涵盖os.path模块对路径的拆分(split、basename等)与拼接(join、abspath等)操作,介绍如何获取文件属性(大小、时间戳),并演示使用chmod和access进行文件权限修改与判断。通过具体代码示例,帮助开发者编写跨平台、健壮的文件处理程序。
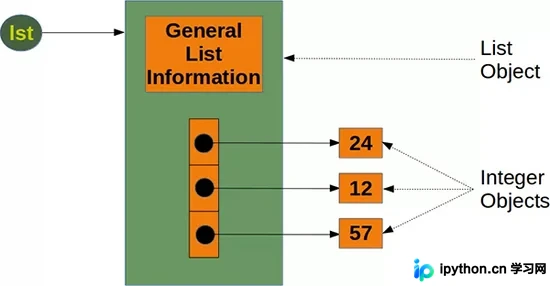
本文深入解析Python大数据处理中Numpy Array的核心优势。通过对比原生List,详细阐述Numpy在内存占用(降低20倍)和运算速度(提升近2倍)方面的显著性能,并结合C语言底层实现与内置代数运算优势,说明其在金融等大数据场景下的必要性。
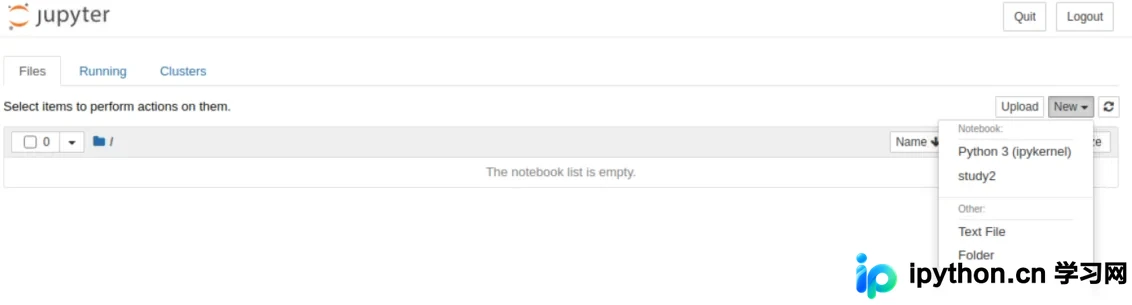
本文详细介绍在Ubuntu及Windows环境下,利用Anaconda和ipykernel为Jupyter Notebook添加、重命名及删除内核的具体操作步骤。涵盖从创建虚拟环境、激活环境到执行内核注册命令的全过程,并解释根目录与base环境的注意事项,帮助开发者高效管理多项目开发环境。
本文介绍如何使用 Python 的 ttkbootstrap 库快速构建美观的用户注册界面。通过安装最新版的 ttkbootstrap,结合 tkinter 组件,实现用户名、密码输入,性别单选,兴趣爱好多选及日期选择功能,并演示如何收集数据并保存至本地文件。
本文详细介绍Python中如何使用configparser模块进行ini配置文件的读写操作。涵盖导入模块、创建与写入配置、读取现有文件、修改及保存配置等核心步骤,并附带ini文件格式说明及模块帮助信息,帮助开发者快速掌握配置文件的处理方法。
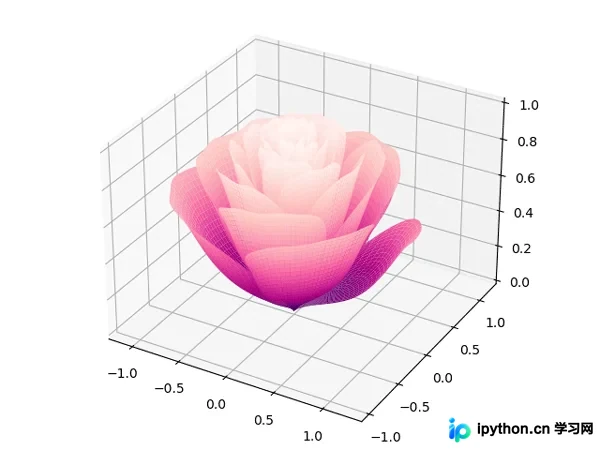
本文介绍如何利用Python的matplotlib库绘制3D小红花模型。通过调整参数控制花瓣形态,分别展示含苞待放与盛开两种状态。文章提供完整代码及配色方案参考,帮助开发者掌握3D网格绘制技巧。
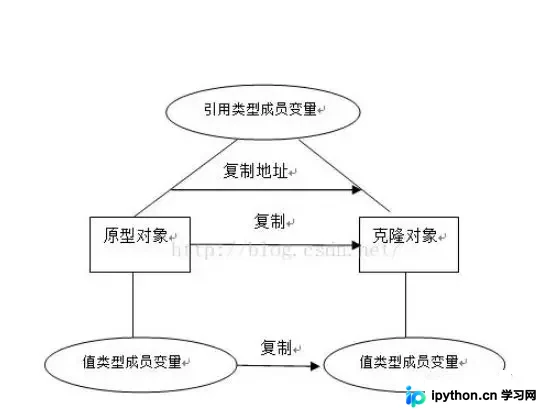
本文深入解析Python中的原型模式,阐述其通过深拷贝和属性更新实现对象克隆的核心思路。通过具体代码示例,展示如何利用原型模式减少实例化开销并实现个性化对象创建,适用于需要动态生成相似但略有差异对象的场景。
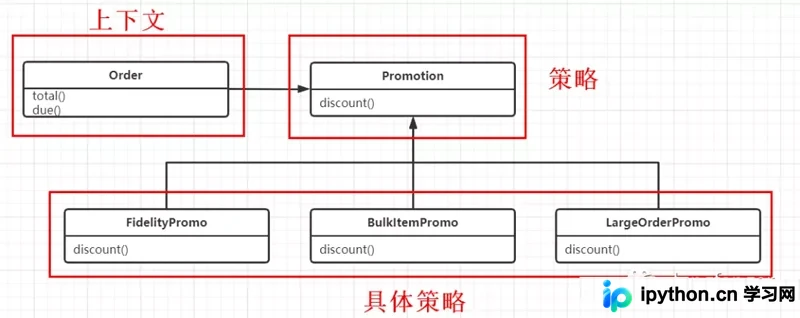
本文深入解析Python中的行为型设计模式——策略模式。通过定义一系列可互换的算法并封装在策略类中,实现运行时动态切换行为。文章详细阐述了该模式在消除复杂条件语句、提高代码复用性方面的优势,以及客户端需了解具体策略的局限性,并结合折扣计算场景与Python代码示例,展示Context、Strategy及Concrete Strategy的角色协作。
本文深入解析Python中struct模块的核心用法,涵盖format格式字符串的构建规则、字节序(大端/小端)控制、内存对齐与填充机制,以及pack、unpack等关键方法的实际代码示例,帮助开发者高效处理二进制数据交互。