

Python大数据处理为何首选Numpy Array:内存与性能深度解析

本文深入解析Python大数据处理中Numpy Array的核心优势。通过对比原生List,详细阐述Numpy在内存占用(降低20倍)和运算速度(提升近2倍)方面的显著性能,并结合C语言底层实现与内置代数运算优势,说明其在金融等大数据场景下的必要性。
Numpy作为Python科学计算领域的核心模块,提供了高效且强大的数组对象及其配套处理工具。Numpy数组由大量同类型数值构成,这种统一的数据结构是其高性能的基础。
Python内置的核心库提供了List列表类型,这是Python中最常用的数据类型之一。List具有动态调整大小的能力,且支持存储不同类型的元素,使用场景非常灵活便捷。
List与Numpy Array存在本质区别,在大数据处理场景中,选择Numpy Array的主要驱动力是性能优化。
Numpy数据结构在内存效率、执行速度以及内置运算方法三个关键维度上,均展现出优于List的特性。
首先,Numpy数据结构在内存占用方面具有显著优势,其占用的内存空间远小于同等数据量的List。
其次,在性能方面,Numpy底层基于C语言实现,规避了Python解释器的部分开销,因此执行速度比原生List更快。
此外,Numpy内置了经过深度优化的代数运算等方法,使得数学计算更加直观且高效。
下文将具体展开分析,在大数据处理场景下,Numpy数组相较于List所具备的具体优势。
1. 内存占用更小
合理地将Numpy数组替代List,可使内存占用降低约20倍。
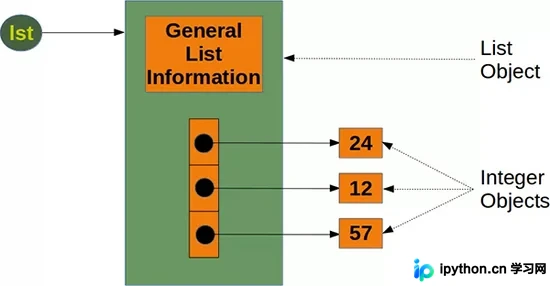
对于Python原生List,每新增一个对象需额外占用8字节用于引用该对象,而对象本身(以整数为例)占用28字节。因此,List的大小可通过以下公式估算:
64 + 8 * len(lst) + len(lst) * 28 字节
相比之下,使用Numpy能大幅减少空间开销。例如,长度为n的Numpy整型Array,其内存需求为:
96 + len(a) * 8 字节
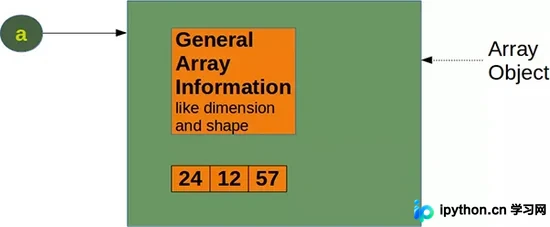
由此可见,数组规模越大,节省的内存空间越可观。若数组包含10亿个元素,两者之间的内存差距将达到GB级别。
2. 速度更快、内置计算方法
运行以下脚本,对比生成相同维度两个数组并执行相加操作的过程,即可直观看到原生List与Numpy Array之间的性能差异。
import time
import numpy as np
size_of_vec = 1000
def pure_python_version():
    t1 = time.time()
    X = range(size_of_vec)
    Y = range(size_of_vec)
    Z = [X[i] + Y[i] for i in range(len(X)) ]
    return time.time() - t1
def numpy_version():
    t1 = time.time()
    X = np.arange(size_of_vec)
    Y = np.arange(size_of_vec)
    Z = X + Y
    return time.time() - t1
t1 = pure_python_version()
t2 = numpy_version()
print(t1, t2)
print("Numpy is in this example " + str(t1/t2) + " faster!")
测试结果如下:
0.00048732757568359375 0.0002491474151611328 Numpy is in this example 1.955980861244019 faster!
数据显示,Numpy在此示例中比原生List快约1.95倍。
值得注意的是,Numpy Array支持直接执行加法操作,而原生List无法直接实现此类运算,这体现了Numpy在运算方法上的独特优势。
为进一步验证该性能优势的稳定性,我们进行了多次重复试验。
import numpy as np
from timeit import Timer
size_of_vec = 1000
X_list = range(size_of_vec)
Y_list = range(size_of_vec)
X = np.arange(size_of_vec)
Y = np.arange(size_of_vec)
def pure_python_version():
    Z = [X_list[i] + Y_list[i] for i in range(len(X_list)) ]
def numpy_version():
    Z = X + Y
timer_obj1 = Timer("pure_python_version()",
                   "from __main__ import pure_python_version")
timer_obj2 = Timer("numpy_version()",
                   "from __main__ import numpy_version")
print(timer_obj1.timeit(10))
print(timer_obj2.timeit(10)) # Runs Faster!
print(timer_obj1.repeat(repeat=3, number=10))
print(timer_obj2.repeat(repeat=3, number=10)) # repeat to prove it!
实验结果如下:
0.0029753120616078377 0.00014940369874238968 [0.002683573868125677, 0.002754641231149435, 0.002803879790008068] [6.536301225423813e-05, 2.9387418180704117e-05, 2.9171351343393326e-05]
从输出结果可见,Numpy的执行时间始终显著低于List,证实了该性能优势具有持久性和可靠性。
因此,在进行金融数据、股票数据等大数据研究时,使用Numpy不仅能大幅节省内存空间,还能提供更强大的计算性能。
至此,关于Python大数据处理为何必须使用Numpy Array的解析已结束。如需了解更多Python大数据与Numpy Array相关内容,欢迎查阅本站过往文章或继续浏览后续教程,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









