Python并发编程中线程锁的使用与可重入锁详解
本文深入解析Python并发场景下的线程锁机制。通过电商库存扣减实例,阐述加锁防止数据竞争的必要性。详细对比threading.Lock的两种实现方式:手动acquire/release与with语句,并指出忘记释放锁的风险。进一步介绍可重入锁RLock解决递归死锁的方案,帮助开发者避免常见并发陷阱。
2026-10-15
8

本文深入解析Python并发场景下的线程锁机制。通过电商库存扣减实例,阐述加锁防止数据竞争的必要性。详细对比threading.Lock的两种实现方式:手动acquire/release与with语句,并指出忘记释放锁的风险。进一步介绍可重入锁RLock解决递归死锁的方案,帮助开发者避免常见并发陷阱。
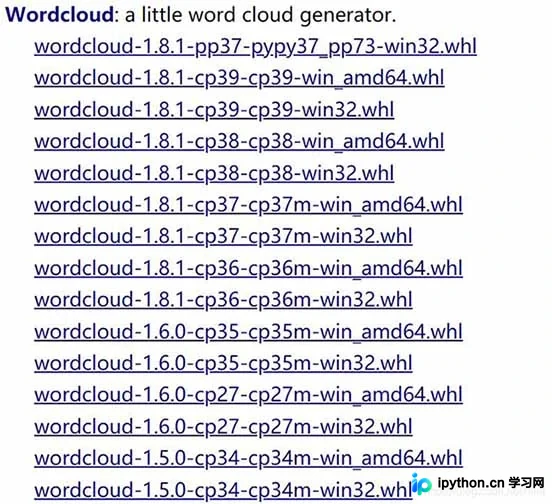
本文记录了在 Python 3.9 环境下使用 pip 安装 wordcloud 库时遇到的报错及解决过程。主要问题源于手动下载 whl 文件后,因文件路径配置错误导致安装失败。通过定位正确的 .whl 文件路径并执行 pip install 命令,成功解决了安装问题。
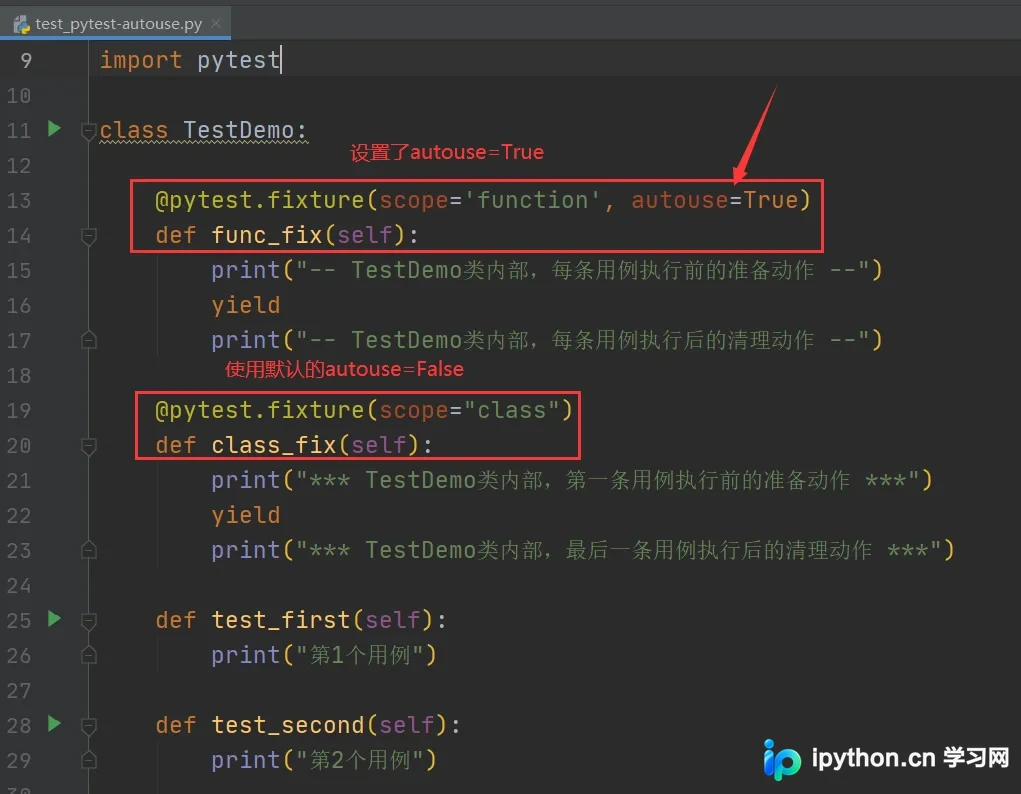
本文深入解析Pytest中fixture的autouse参数及session和module级别的作用域机制。详细讲解如何通过设置autouse=True实现自动化执行,并对比function/class级别的差异。同时阐述session和module级别fixture的定义、执行时机及适用场景,结合conftest.py配置示例,帮助开发者优化测试前置与清理逻辑。
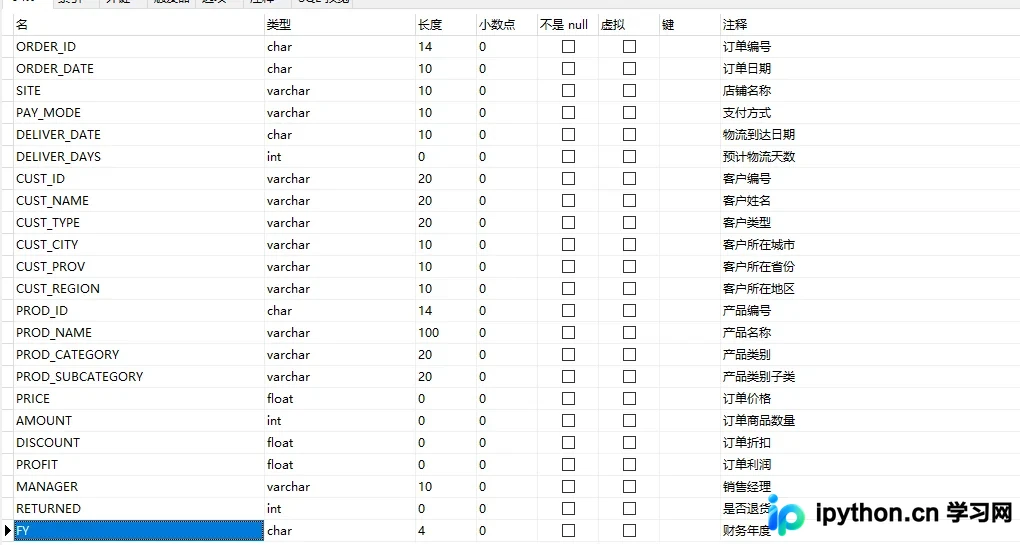
本文详细介绍如何使用Python的pymysql库连接数据库,提取订单数据,并利用matplotlib库绘制柱状图。内容涵盖从环境配置、SQL查询、全局参数设置到最终图表生成的完整代码示例,帮助开发者快速实现数据可视化。
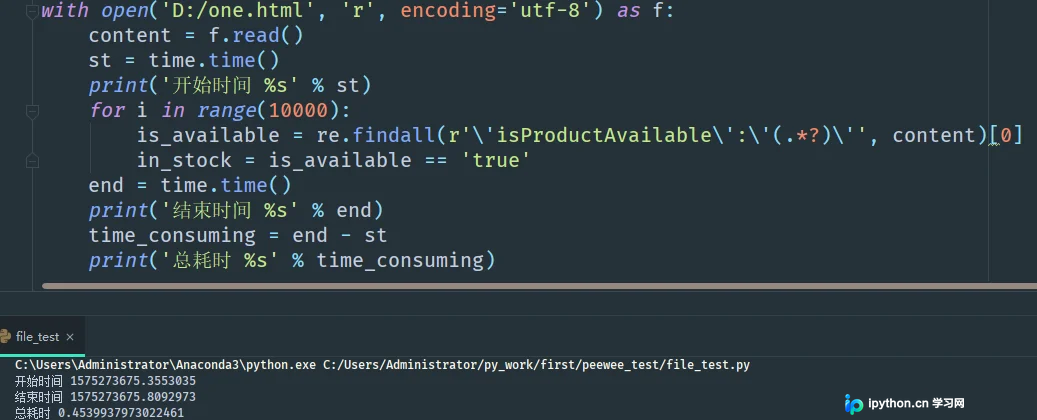
本文探讨 Python 中 re.compile 的必要性。作者通过实际案例指出,在数据量较小(如上万条)的场景下,直接使用 re.findall 或 re.search 的性能损耗可忽略不计,过度优化反而增加代码复杂度。只有面对百万级以上数据时,预编译正则对象才具有显著性能优势。文章强调应根据业务量级合理选择策略,而非盲目追求代码规范。
本文介绍如何利用Caffe Python接口自动生成deploy.prototxt文件,并基于训练好的caffemodel对新图片进行分类预测。重点解析deploy文件与test文件的结构差异,通过mnist示例展示从生成配置文件到执行分类预测的完整流程,包括图片预处理、网络加载及结果输出。
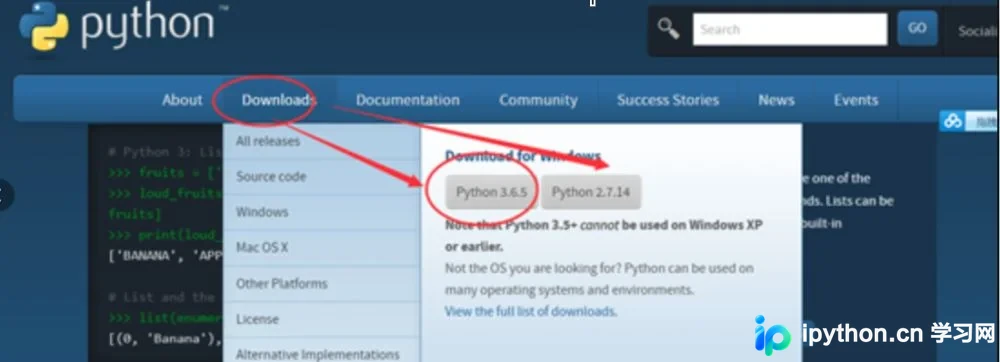
本文详细讲解如何从零搭建Python与Selenium的自动化测试环境。涵盖Python解释器安装、PyCharm配置、Selenium库及浏览器驱动下载与路径设置,并通过首个Demo代码验证环境可用性,确保浏览器能自动启动并执行操作。
本文详解Caffe中图片均值计算的两种格式:二进制proto与Python numpy。通过compute_image_mean工具生成二进制均值,并借助Python脚本将其转换为.npy格式,便于模型训练与特征可视化,提升训练速度与精度。
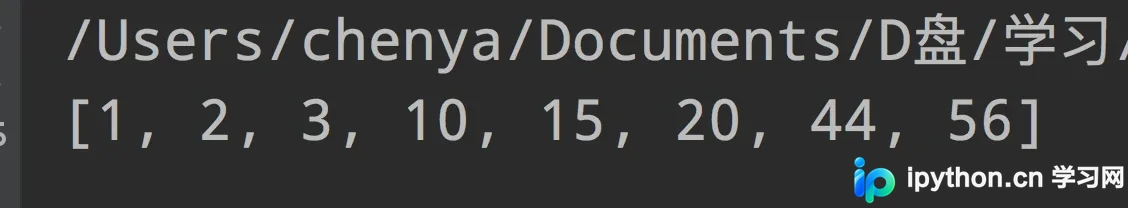
本文整理了Python中去除列表重复元素的五种常用方法,包括利用集合、for循环、排序函数、字典特性以及迭代器groupby。每种方法均提供完整代码示例与运行结果分析,帮助开发者根据性能需求选择最优方案。
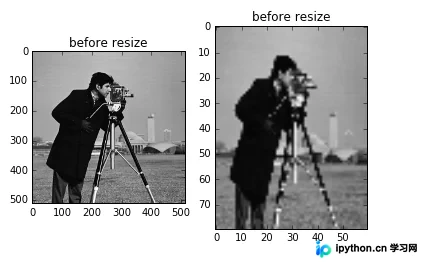
本文详细介绍Python中skimage库的transform模块,涵盖图像尺寸调整、按比例缩放、旋转及图像金字塔构建。通过resize、rescale、rotate和pyramid_gaussian等核心函数,结合具体代码示例,演示如何处理图像形变与缩放操作,适用于计算机视觉基础应用。
本文详细介绍Simhash算法在大规模文本去重中的应用。通过解析TF-IDF特征提取、局部敏感哈希原理及64位二进制生成步骤,结合Python代码示例,展示如何计算文档相似度与海明距离,帮助开发者高效处理海量数据去重任务。
本文详解Python skimage库中图像的数据类型(如uint8、float)及其相互转换方法,重点讲解RGB、灰度、HSV等常见颜色空间的转换函数与用法,包含代码示例及注意事项。