

Python实现Simhash算法详解:原理、步骤与代码示例

本文详细介绍Simhash算法在大规模文本去重中的应用。通过解析TF-IDF特征提取、局部敏感哈希原理及64位二进制生成步骤,结合Python代码示例,展示如何计算文档相似度与海明距离,帮助开发者高效处理海量数据去重任务。
1. 为什么需要Simhash?
传统文本相似度计算通常基于向量空间模型(VSM)。该方法先对文本进行分词并提取特征,构建文本向量,随后将相似度计算转化为特征向量间的距离计算,例如使用欧式距离或余弦夹角。
然而,在大数据场景下,这种方法的计算复杂度极高,难以满足高效处理需求。
Simhash主要应用于大规模文本相似度的计算,旨在实现海量文本信息的高效去重。
Simhash的核心原理是通过比较字符串计算出的hash值来判断相似度。具体做法是对两个字符串的hash值进行异或操作,统计结果中1的个数(即差异位数)。差异个数越大,表示两个字符串的差异越大。
2. 文章关键词特征提取算法TD-IDF
词频(TF)定义为:一个词语在整篇文章中出现的次数与该文章词语总个数之比。
逆向词频(IDF)用于衡量词语的代表性。若一个词语在所有文章中出现的频率非常高,则其代表性较低,应赋予较小的权值以降低其影响。
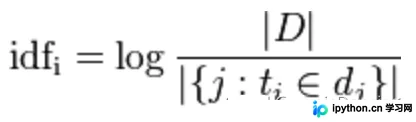
IDF的计算公式中,分子代表文章总数,分母表示该词语出现的文章篇数。为防止分母为0,通常采用分母加一的方法,随后对该比值取对数,即为IDF值。
最终,通过计算tf与idf的乘积得到词语的权重,进而确定文章的关键词。基于每篇文章的关键词对比,可实现文章去重。Simhash算法在效率与性能之间取得平衡:关键词数量既不能过多(影响对比速度),也不能过少(缺乏代表性)。
3. Simhash原理
Simhash属于局部敏感哈希(Locality Sensitive Hashing, LSH)。其特性是:如果文档A和B具有一定的相似性,经过hash处理后,它们的hash值仍能保持这种相似性。
具体实现时,首先得到文章的关键词集合,通过哈希方法将关键词集合转换为一串二进制数。直接对比这些二进制数,其相似性即代表文档的相似性。在评估相似性时采用海明距离,即对比二进制数时统计不同的位数,该位数即为海明距离。
通常将文章Simhash生成一串64位的二进制数。根据经验,一般设定海明距离阈值为3,即在64位二进制中,若有三位以内的差异,即可认为两个文档相似。该阈值也可根据具体需求调整。这种将文档hash为一串二进制数的算法,即称为Simhash。
Simhash的具体实现步骤如下:
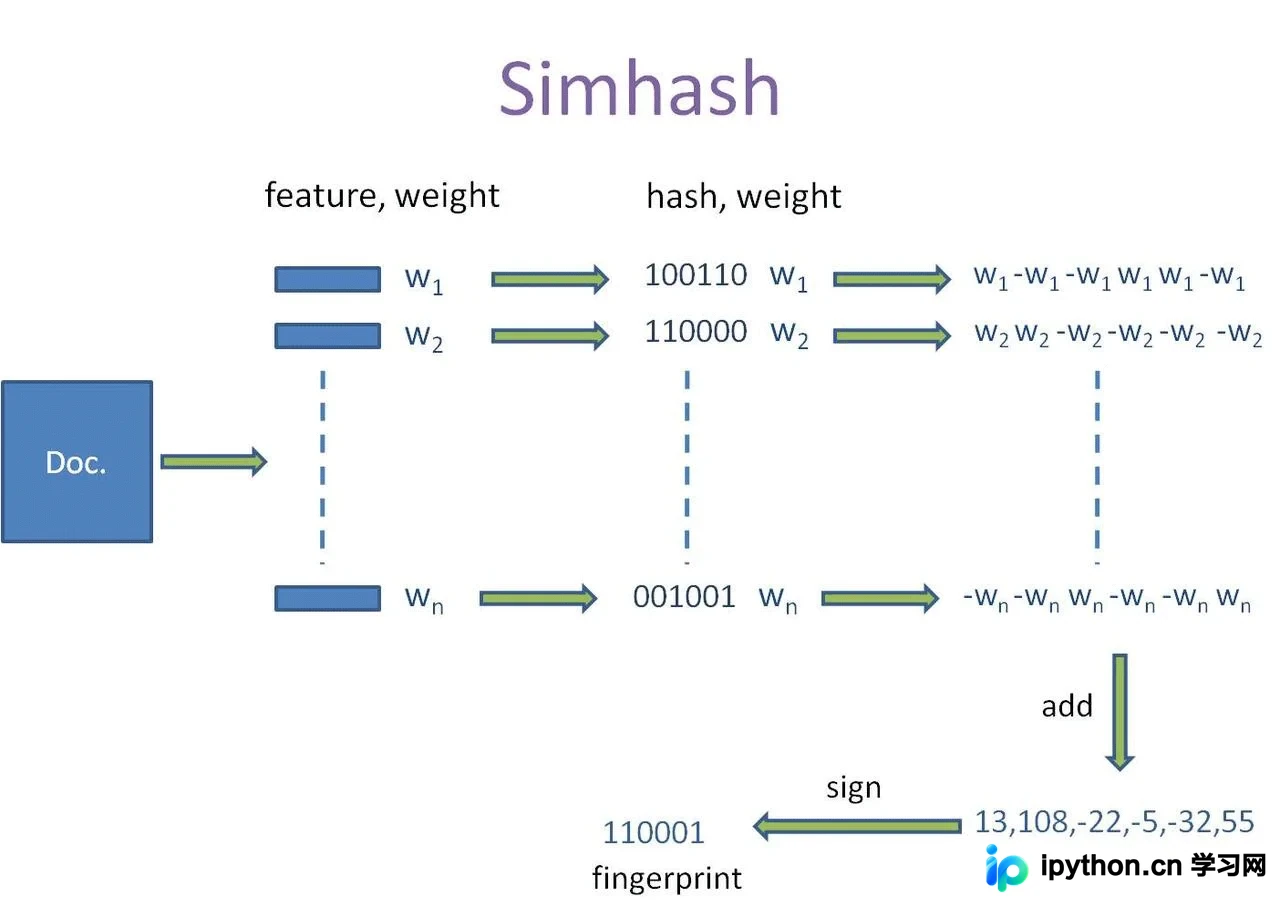
- 1. 对文档进行分词,选取TF-IDF权重最高的前20个词(feature)及其对应的权重(weight)。即一篇文档生成一个包含20个(feature:weight)元组的集合。
- 2. 对上述每个词(feature)进行普通哈希,生成一个64位的二进制数,从而得到一个包含20个(hash : weight)元组的集合。
- 3. 根据步骤2中得到的二进制数(hash)在相应位置是0还是1,对相应位置取正值weight或负值weight。例如,一个词经过步骤2得到(010111:5),经过步骤3后可得到列表[-5, 5, -5, 5, 5, 5]。由此可生成20个长度为64的列表,代表一个文档。
- 4. 对步骤3中得到的20个列表进行列向累加,得到一个长度为64的列表。例如,将[-5, 5, -5, 5, 5, 5]、[-3, -3, -3, 3, -3, 3]、[1, -1, -1, 1, 1, 1]进行列向累加,得到[-7, 1, -9, 9, 3, 9]。这样,我们就得到了一个长度为64的列表。
- 5. 对步骤4中得到的列表每个值进行判断:若为负值,取0;若为正值,取1。例如,将[-7, 1, -9, 9, 3, 9]转换为010111,从而得到该文档的Simhash值。
- 6. 计算相似性。对两个Simhash值进行异或操作,统计结果中1的个数是否超过3。若超过3,则判定为不相似;若小于等于3,则判定为相似。
Simhash整体流程图如下:
4. Simhash的不足
完全无关的文本可能恰好对应相同的Simhash值,因此精确度并非极高。此外,Simhash更适用于较长文本。但在大规模语料进行去重时,Simhash的计算速度优势依然显著。
5. Simhash算法实现
# !/usr/bin/python
# coding=utf-8
class Simhash:
    def __init__(self, tokens='', hashbits=128):
        self.hashbits = hashbits
        self.hash = self.simhash(tokens)
    def __str__(self):
        return str(self.hash)
    # 生成simhash值
    def simhash(self, tokens):
        v = [0] * self.hashbits
        for t in [self._string_hash(x) for x in tokens]:  # t为token的普通hash值
            for i in range(self.hashbits):
                bitmask = 1 << i
                if t & bitmask:
                    v[i] += 1  # 查看当前bit位是否为1,是的话将该位+1
                else:
                    v[i] -= 1  # 否则的话,该位-1
        fingerprint = 0
        for i in range(self.hashbits):
            if v[i] >= 0:
                fingerprint += 1 << i
        return fingerprint  # 整个文档的fingerprint为最终各个位>=0的和
    # 求海明距离
    def hamming_distance(self, other):
        x = (self.hash ^ other.hash) & ((1 << self.hashbits) - 1)
        tot = 0
        while x:
            tot += 1
            x &= x - 1
        return tot
    # 求相似度
    def similarity(self, other):
        a = float(self.hash)
        b = float(other.hash)
        if a > b:
            return b / a
        else:
            return a / b
    # 针对source生成hash值
    def _string_hash(self, source):
        if source == "":
            return 0
        else:
            x = ord(source[0]) << 7
            m = 1000003
            mask = 2 ** self.hashbits - 1
            for c in source:
                x = ((x * m) ^ ord(c)) & mask
            x ^= len(source)
            if x == -1:
                x = -2
            return x
测试:
if __name__ == '__main__':
    s = 'This is a test string for testing'
    hash1 = Simhash(s.split())
    s = 'This is a string testing 11'
    hash2 = Simhash(s.split())
    print(hash1.hamming_distance(hash2), "   ", hash1.similarity(hash2))
到此这篇关于如何利用python实现Simhash算法的文章就介绍到这了,更多相关pythonSimhash算法内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









