

Python下载安装与环境配置完整指南及实战示例
面向零基础用户,本文详述Python本地运行环境的完整搭建流程。涵盖官方解释器下载、环境变量PATH配置、终端验证、VS Code编辑器与插件部署、pip包管理器使用及清华镜像加速。附带常见报错排查方法与基于pandas库处理Excel数据的实操示例,帮助读者快速实现办公自动化环境的就绪。
2026-10-10
9

面向零基础用户,本文详述Python本地运行环境的完整搭建流程。涵盖官方解释器下载、环境变量PATH配置、终端验证、VS Code编辑器与插件部署、pip包管理器使用及清华镜像加速。附带常见报错排查方法与基于pandas库处理Excel数据的实操示例,帮助读者快速实现办公自动化环境的就绪。
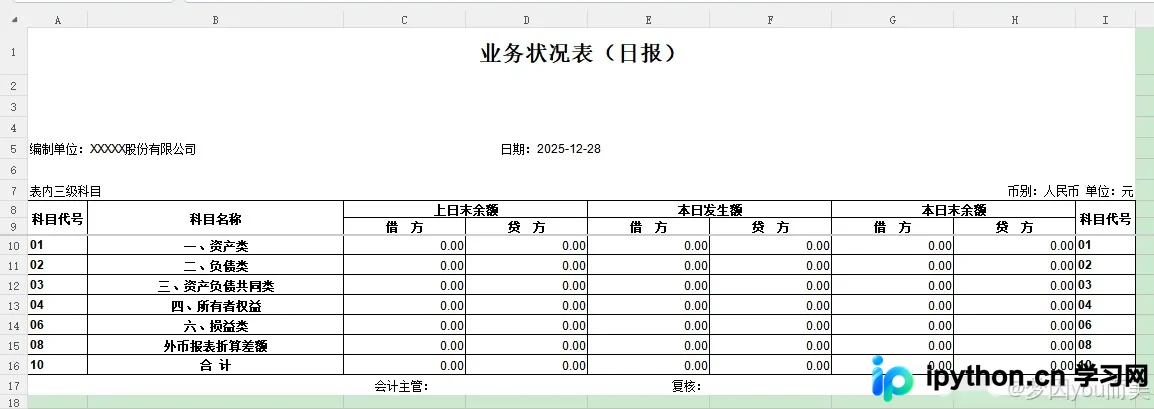
手动复制Excel工作表效率低且易出错。本文提供基于Python的两种自动化方案:利用openpyxl实现轻量级跨平台基础格式复制,以及通过win32com调用本地Excel进程实现全格式完美保留。附带完整代码、参数配置、场景拓展及常见报错排查,帮助职场人快速实现批量处理与定时备份。
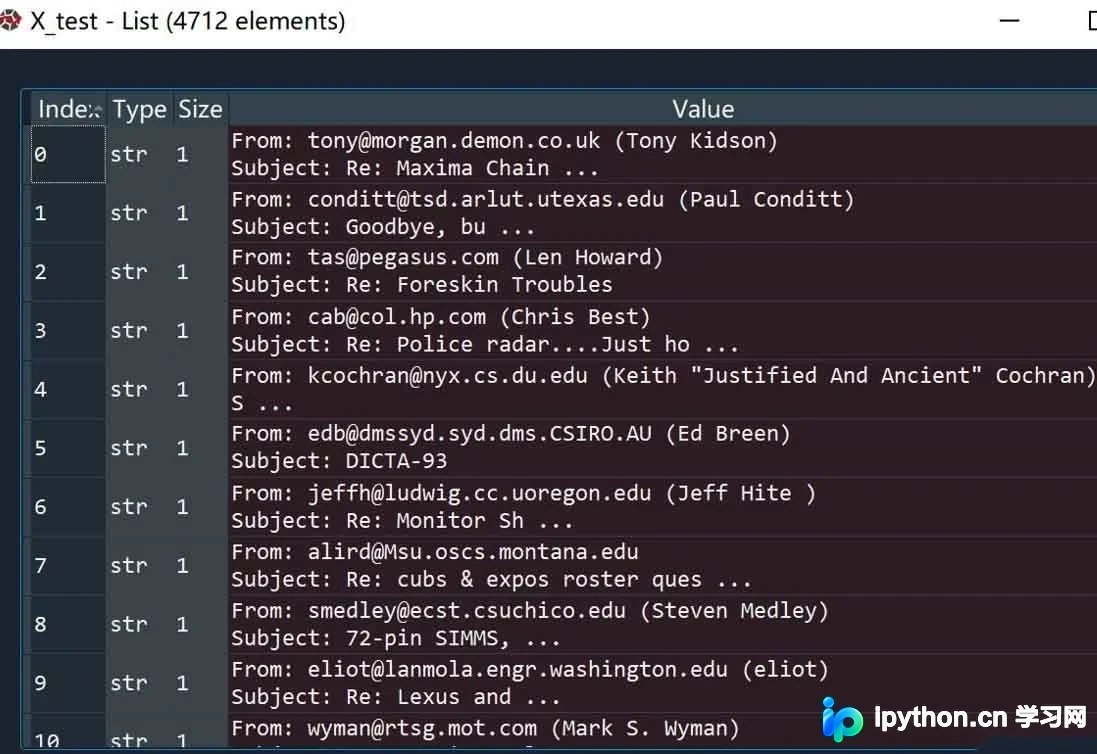
本文介绍如何使用Python循环批量保存和读取文本文件。以新闻文本主题分类数据为例,通过遍历列表将每个子列表保存为独立txt文件,并利用os模块遍历目录循环读取所有文件内容。代码包含保存与读取两个核心部分,适用于需要处理大量文本数据的场景,提供完整可运行的Python实现方案。
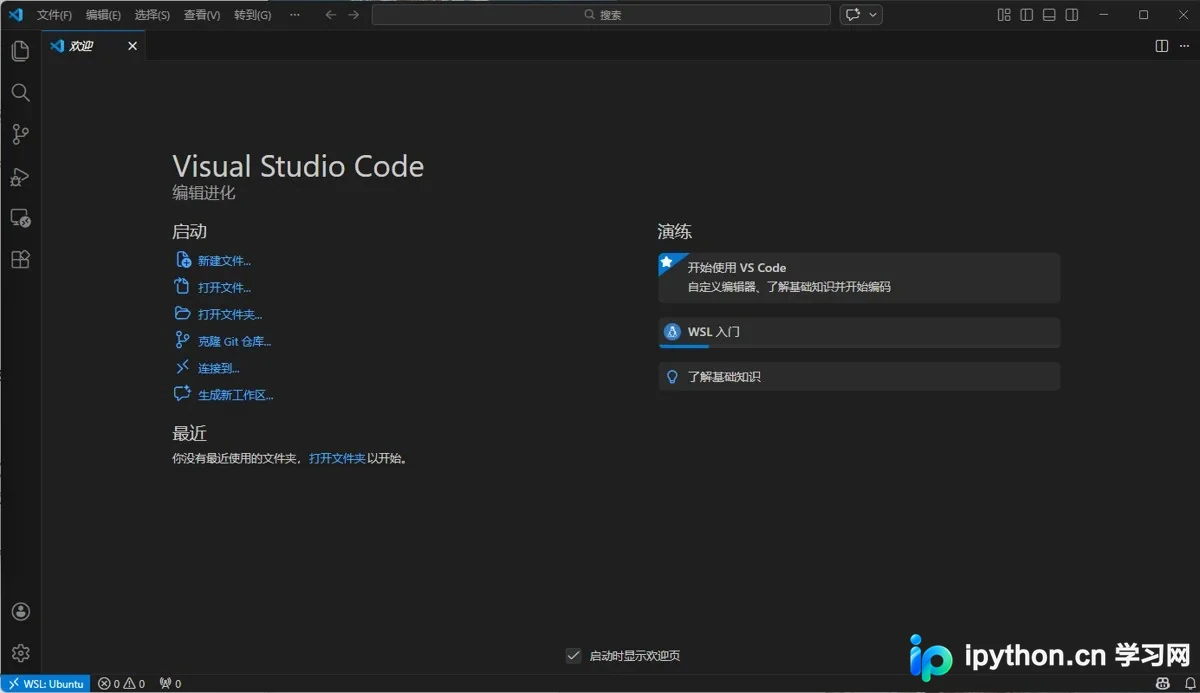
本文详细记录在Windows环境下,通过WSL2 Ubuntu安装PySide6并配合VSCode开发桌面应用的完整流程。涵盖虚拟环境创建、系统GUI依赖配置、Remote插件连接及Python解释器指定等关键步骤,解决PEP 668限制与软件包兼容问题,实现跨平台高效调试。
在Python项目中将Markdown文档转化为网页展示格式,需根据性能、规范兼容性与扩展需求选型。本文对比markdown2、mistune、markdown、markdown-it-py、pypandoc等核心方案的底层特性与API差异,提供从零配置到输出验证的完整代码示例,助力开发者高效搭建自动化排版流水线。
本文详细解析Python变量命名规范,涵盖字母数字下划线组合、大小写敏感及关键字限制。深入讲解int、float、str、bool及None五种核心数据类型,并通过实例演示各类数据间的相互转换规则,包括进制转换、字符串解析及布尔值判定逻辑,帮助开发者掌握Python基础编程要点。
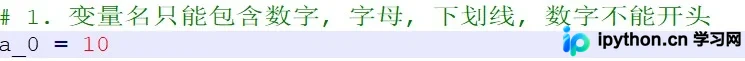
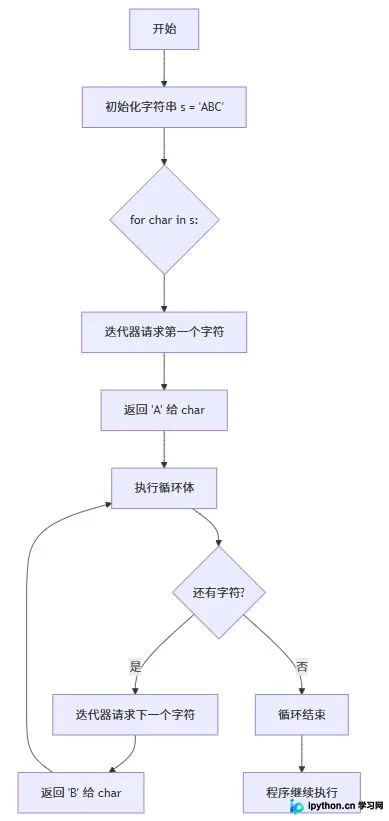
详细讲解在Python中如何利用for循环遍历字符串以逐个获取字符。涵盖基础迭代语法、字符统计与变换的实战示例,以及enumerate索引获取、列表推导式和高效join拼接等进阶技巧。同时提供常见错误排查,帮助开发者写出更高效的字符串处理代码。
本文详细讲解如何利用Python与OpenCV库实现实时文档扫描系统。通过Canny边缘检测提取轮廓,结合多边形逼近筛选四边形区域,利用透视变换算法将倾斜文档矫正为正视扫描件,并提供完整可运行代码及核心参数调优方案。
手动逐篇发布本地Markdown文件效率低下且易出错。本文通过Python自动化脚本解决此问题,核心涵盖三步:使用python-frontmatter精准提取标题与标签等元数据;正则匹配本地相对路径图片并调用API上传替换为网络链接;将文本标签映射为平台ID后提交至博客接口。附带完整代码与防限流、防乱码排错经验,适合希望建立个人知识库自动化工作流的开发者参考。
面对PDF文档中的冗余页、敏感信息或重复排版,手动调整效率低下。本文基于Python生态,对比PyPDF2、Spire.PDF与PyMuPDF三大工具的特性差异,提供单页删除、多页面批量过滤及空白页自动清理的核心代码。结合内存耗时实测数据与加密文档处理技巧,帮助开发者快速定位技术选型并规避索引越界等常见陷阱。
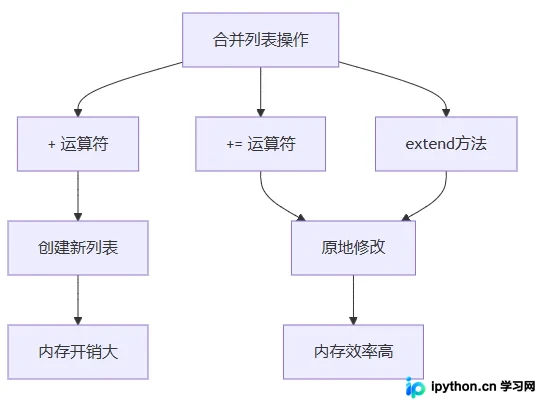
Python合并列表主要依赖`+`运算符、`+=`运算符与`extend()`方法。三者虽结果相似,但在原址修改、内存分配及数据类型兼容性上存在本质差异。本文结合底层执行逻辑与基准测试数据,明确各方法适用边界,提供高效编写列表拼接代码的选型策略。
本文解析多进程同时读写文件时因操作非原子性导致读取残缺数据的竞态条件问题。提供临时文件加原子替换、第三方库filelock实现文件锁以及引入数据库三种解决方案,附带Python完整代码实现与跨平台兼容、缓存落盘等关键避坑细节,帮助开发者按场景选择稳定可靠的文件并发控制策略。