

Python正则表达式爬虫实战:从基础语法到个人博客数据抓取
本文详细解析Python中正则表达式(Regex)在爬虫开发中的应用。通过介绍re模块的核心函数如findall、compile、match及search,结合抓取网页标题、超链接、表格内容及图片URL的具体代码示例,演示如何高效提取HTML数据。最后通过完整实例展示如何爬取个人博客的标题、图片及文章摘要,帮助初学者掌握基础网络数据抓取技巧。
2026-10-13
9

本文详细解析Python中正则表达式(Regex)在爬虫开发中的应用。通过介绍re模块的核心函数如findall、compile、match及search,结合抓取网页标题、超链接、表格内容及图片URL的具体代码示例,演示如何高效提取HTML数据。最后通过完整实例展示如何爬取个人博客的标题、图片及文章摘要,帮助初学者掌握基础网络数据抓取技巧。
本文深入解析Django自定义过滤器的原理与实现。通过MVP架构视角,阐述将基础逻辑从View剥离至templatetags目录的必要性。详细演示如何创建templatetags文件夹、编写过滤器函数、使用register装饰器注册,并在HTML模板中加载应用。通过求列表最大值的实例,展示自定义过滤器的完整开发流程。
本文详细解析Python中二分查找与快速排序的实现逻辑,重点指出代码中存在的逻辑缺陷与潜在Bug。通过具体实例展示排序与查找过程,帮助开发者理解算法细节并避免常见错误,提供完整的代码参考与调试建议。
本文详解Python中Matplotlib库的Pyplot模块,介绍其作为类MATLAB命令型函数的核心用法。通过实例解析plot()函数在单参数与双参数模式下的坐标轴生成逻辑,并深入讲解颜色字符与线型字符串的组合设置方法,帮助开发者快速掌握基础绘图技巧与样式定制。
本文详解Python中urlparse模块的常用方法。介绍urlparse、urlsplit如何解析URL为协议、域名、路径等组件,以及urlunparse和urlunsplit的重组用法。同时说明urljoin处理相对地址的技巧,并展示如何提取hostname、port等附加属性,助力开发者高效处理网络链接。
本文介绍Python中正则表达式连接符(-)的使用,通过[a-z]等示例展示如何简化字符集合定义,避免手动输入大量字符。文章提供代码示例和输出结果,帮助读者掌握正则表达式的基本技巧。
本文详解 Python 内置加密模块 hashlib 与 hmac 的用法。介绍如何利用 hashlib 实现 MD5、SHA1 至 SHA512 等多种哈希算法,涵盖二进制与十六进制密文获取及编码处理。同时解析 hmac 模块通过密钥对消息进行加密签名的具体步骤,提供完整代码示例与注意事项,帮助开发者掌握基础加密技能。
本文介绍利用Python3.4从HTTP代理网站批量抓取代理IP并进行有效性筛选的方法。通过多线程并发测试目标网站连接速度与响应内容,快速剔除无效代理,提取可用IP列表,解决爬虫IP被封问题。
本文详解如何使用Python构建简易HTTP服务器。从客户端与服务端角色、浏览器引擎、Socket通信机制到HTTP协议规范及URL结构进行系统梳理,结合Python代码示例演示如何监听端口、解析请求并返回符合HTTP标准的响应内容,帮助开发者理解Web通信底层原理。
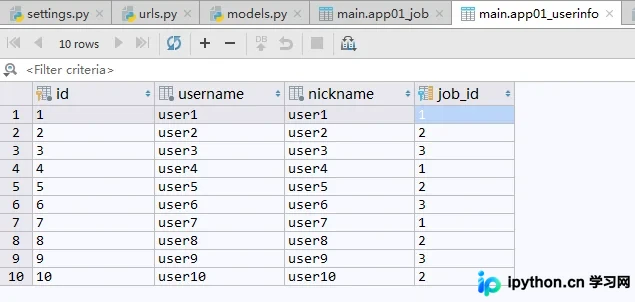
本文深入解析Django ORM中常见的数据库查询性能瓶颈,通过对比原始遍历查询与使用select_related、prefetch_related、only及defer方法后的执行次数,展示如何有效减少数据库交互。重点讲解主动联表与非主动联表的区别及适用场景,帮助开发者在保持代码简洁的同时显著提升应用性能。
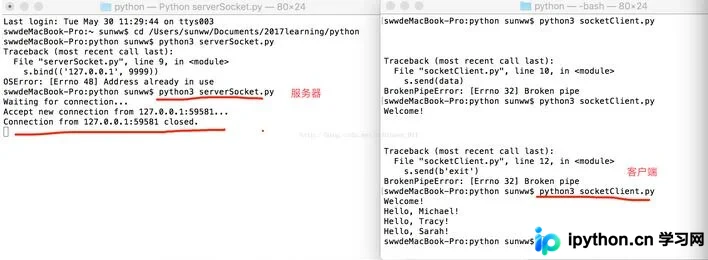
本文详细介绍如何利用Python的socket库建立客户端与服务端之间的TCP连接。通过提供完整的客户端socketClient.py和服务端serverSocket.py代码示例,演示了从绑定端口、监听连接、处理多线程请求到数据发送与接收的全过程。文章还包含了具体的控制台操作步骤及连接截图,帮助读者快速掌握Socket通信的基本原理与实现方法。
本文介绍如何在Python中安装并使用xlrd库读取Excel文件。内容涵盖从环境配置到核心API调用的全过程,包括打开工作簿、获取Sheet列表、提取行列数据及单元格类型判断。此外,还演示了如何解析Excel中的日期格式,帮助开发者快速掌握基础数据提取技巧。