

Python正则表达式re库使用指南:从入门到实战
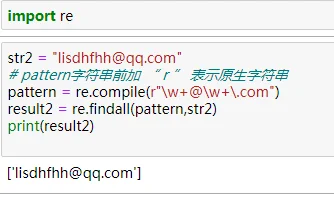
本文详解Python中re库的核心用法,涵盖compile、match、search及findall等关键函数的定义与区别。深入解析正则符号如点号、星号、问号及分组机制,并通过邮箱提取等实例演示group与groups方法的实际应用,帮助开发者掌握文本模式匹配与数据提取技巧。
2026-10-13
20

本文详解Python中re库的核心用法,涵盖compile、match、search及findall等关键函数的定义与区别。深入解析正则符号如点号、星号、问号及分组机制,并通过邮箱提取等实例演示group与groups方法的实际应用,帮助开发者掌握文本模式匹配与数据提取技巧。
本文深入解析Python多线程编程,涵盖threading模块的核心用法。详细介绍三种Thread实例化方式、守护线程的设置与行为,以及通过Lock和with语句实现线程同步。同时剖析GIL对多线程性能的影响,区分I/O密集型与计算密集型应用的适用场景,并提供完整代码示例。
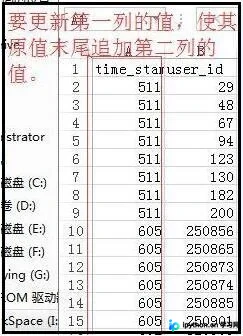
本文介绍在 Pandas 中调整 DataFrame 列顺序的两种常用方法。通过操作列名列表或使用 insert 函数,可以将特定列(如 Mid)移动至第一列。示例展示了从读取 CSV 文件到重新排列列并保存结果的完整流程,适用于数据预处理和特征工程场景。
本文详细介绍Python pandas库中isnull()函数的使用方法。通过创建包含缺失值的DataFrame,演示isnull()如何返回布尔值矩阵以标识缺失位置。进一步结合any()和sum()方法,展示如何快速判断哪些列包含缺失值并统计每列缺失值的数量,帮助开发者高效处理数据清洗工作。
本文深入解析Python中h5py库的应用,对比numpy、scipy及pickle等存储方式。通过具体代码示例展示如何创建、读写HDF5文件,重点介绍dataset与group的使用方法及h5py在速度与压缩效率上的优势,适用于大规模科学数据存储场景。
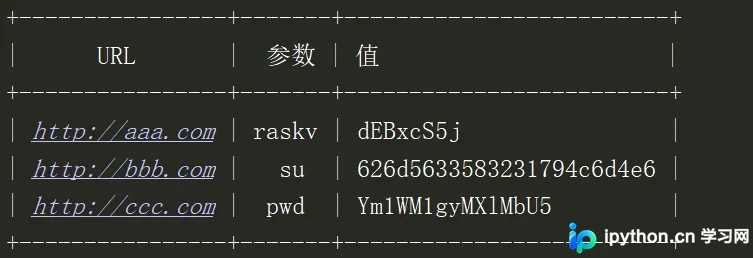
本文介绍如何在Python中使用prettytable库美化表格输出。通过add_row方法按行添加数据,或按add_column方法按列添加数据,并演示如何自定义表头、设置列对齐方式(如左对齐、右对齐),帮助开发者生成清晰易读的终端表格。
本文介绍了在Python中将列表或字符串按指定数量进行分段的两种实现方法。第一种通过while循环手动维护索引,第二种利用列表推导式结合range步长简化代码。两种方法均能处理余数情况,确保最后一段包含剩余元素,适用于数据预处理及批量处理场景。
本文介绍如何使用 Python 脚本解析 sim.log 文件,通过正则表达式定位 BEGINNING SIM PROCEDURE、CP_W 等关键节点的时间戳。程序自动提取各步骤时间并计算阶段耗时,最终输出从 apply 到 commit 及回滚的完整时间线统计,适用于系统更新流程的性能分析与故障排查。
本文详细介绍如何将Python项目编译为SO文件以提升执行效率并保护源码。涵盖环境准备(Cython、gcc等)、基础单文件编译步骤、集成目录编译脚本编写,以及版本兼容、__file__变量限制和权限控制等关键注意事项,帮助开发者安全高效地部署Python应用。
本文介绍了如何使用Python的pykafka库连接Kafka集群。通过提供生产者和消费者的完整代码示例,展示了如何配置主机地址、创建客户端、发送消息以及消费消息。该实例适用于希望快速验证Kafka集群连通性及基础功能的开发者,涵盖了从环境配置到核心API调用的关键步骤。
本文介绍Python中彻底删除文件夹及其子文件的实现方式。通过结合os.walk遍历文件并修改权限,再使用shutil.rmtree清理目录,可有效解决Windows下因只读属性导致的删除失败问题。
本文介绍如何在Python中实现多线程的并发启动与顺序执行。通过利用threading模块的join方法,前一个线程阻塞等待后一个线程启动,从而保证执行顺序。示例代码展示了如何创建10个线程,并验证其按0到9的顺序输出结果及时间戳。