

Python模块机制详解:导入、命名空间与__main__判断
本文系统讲解Python模块的核心概念,涵盖模块作为.py文件的定义、三种导入方式(import、from...import、as重命名)的对比与推荐用法。深入解析模块独立命名空间机制,重点阐述利用__name__变量区分主程序与导入模块的方法,避免测试代码意外执行。同时介绍sys.path搜索路径原理及自定义包的创建规范,帮助开发者规范组织代码结构。
2026-10-15
20

本文系统讲解Python模块的核心概念,涵盖模块作为.py文件的定义、三种导入方式(import、from...import、as重命名)的对比与推荐用法。深入解析模块独立命名空间机制,重点阐述利用__name__变量区分主程序与导入模块的方法,避免测试代码意外执行。同时介绍sys.path搜索路径原理及自定义包的创建规范,帮助开发者规范组织代码结构。
本文详细介绍pandas中DataFrame.shift()函数的使用方法。通过解析periods和axis参数,演示数据在行与列方向的上下左右移动。结合地铁站进出站数据的实际案例,展示如何利用shift计算小时级净流量,并处理由此产生的NaN值,帮助读者掌握时间序列数据处理技巧。
本文介绍在pandas中处理DataFrame时,因数据排序或筛选导致索引顺序混乱的几种重置方法。通过具体示例演示直接赋值、reset_index、reindex及set_index四种方式,帮助开发者高效恢复从0开始的连续整数索引,适用于数据清洗与预处理场景。
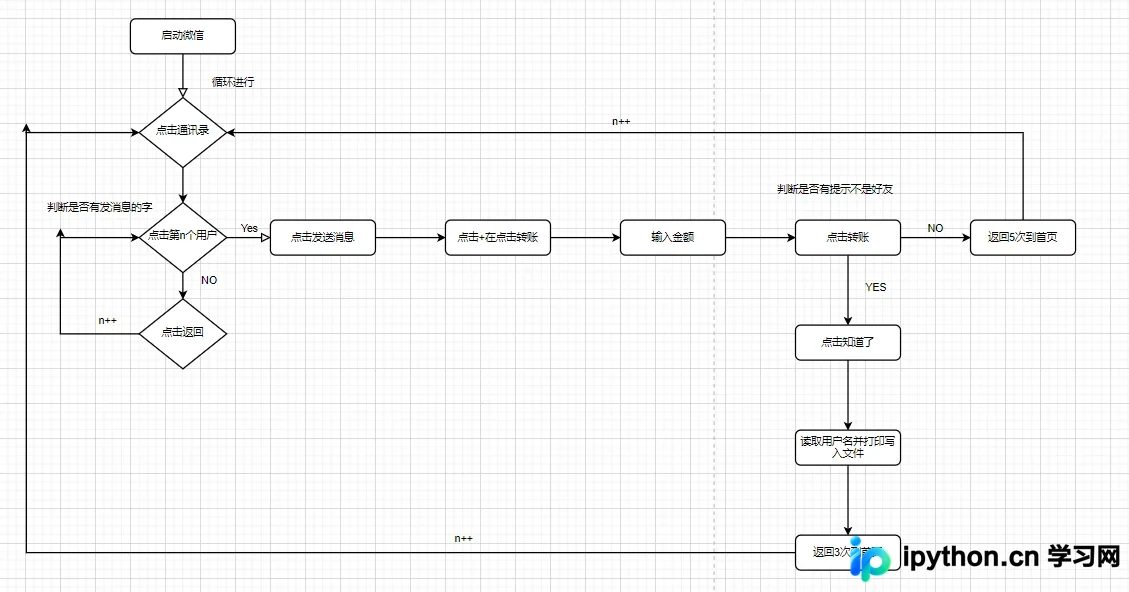
本文介绍如何使用Python结合Appium自动化框架,通过触发微信转账界面来识别被删除的好友。该方法无需实际发送消息或转账,仅通过点击转账按钮观察系统提示即可判断好友关系。文章提供了环境搭建、操作流程及核心代码示例,帮助技术用户批量筛选微信好友状态。
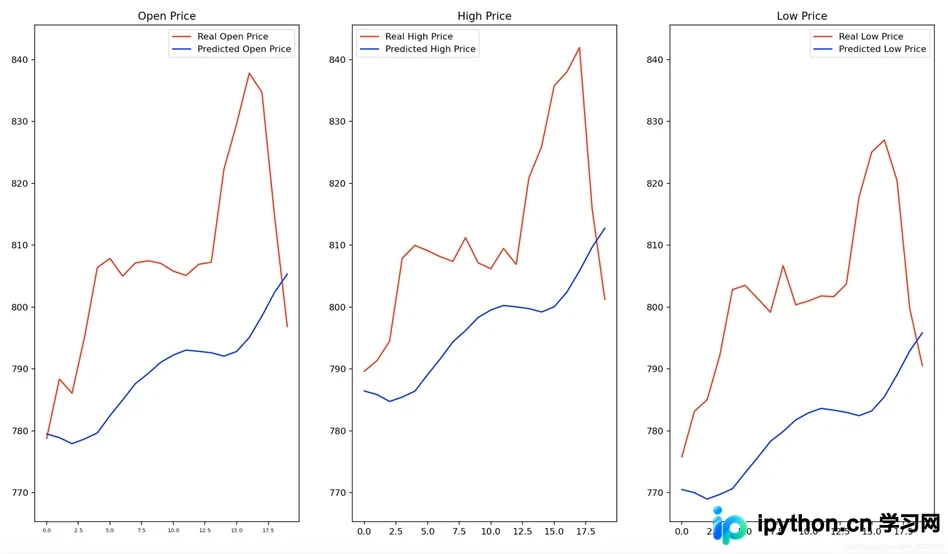
本文介绍如何利用matplotlib库的subplot函数绘制1x3子图,并通过sharey参数实现Y轴共享。示例展示了将DataFrame与ndarray数据的对应列分别绘制在同一子图中,对比真实与预测价格,适用于多变量趋势分析。
本文对比Matplotlib中subplot与subplots两种子图绘制方式。虽然两者均能实现多图布局,但subplots通过一次性返回坐标轴数组并支持直接指定画板尺寸,简化了多子图操作;而subplot每次仅返回单个坐标对象,需多次调用。文章通过具体代码示例展示两者在实现相同视觉效果时的语法差异及适用场景。
本文介绍Python NumPy库中diag函数的用法。该函数可根据输入数组维度不同实现两种功能:当输入为一维数组时,生成以该数组为对角线的方阵;当输入为二维矩阵时,提取其对角线元素。文章还详细解析了参数v和k的具体含义及示例。
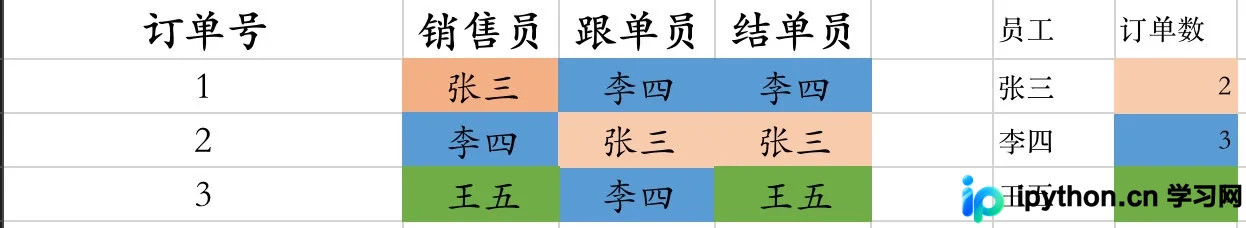
本文详解如何在Pandas中实现Hive的explode函数功能,用于处理员工销售记录统计。通过展开订单角色列表并去重,准确计算每位员工参与的不同订单数量,适用于复杂业务场景下的数据清洗与分析。
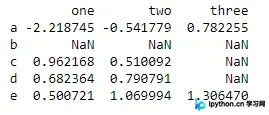
本文详细介绍Pandas库中pd.dropna()函数的用法,用于过滤DataFrame中的缺失数据(NaN)。文章解析了axis、how、thresh、subset和inplace等关键参数的具体含义,并通过多个代码示例演示了按行或列删除含空值数据、设定非空元素最低数量、指定子集判断以及原地修改等操作,帮助开发者高效进行数据清洗。
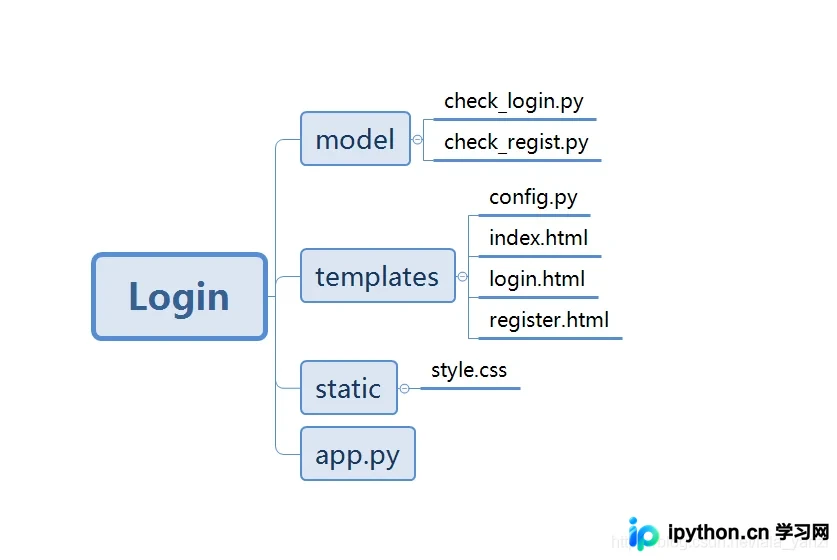
本文详细介绍如何使用Flask框架快速搭建一个包含用户登录和注册功能的小型Web项目。内容涵盖项目目录结构设计、数据库连接配置、HTML模板编写以及后端逻辑处理,包括登录校验、注册验证及路由设置,帮助开发者掌握Flask基础应用开发流程。
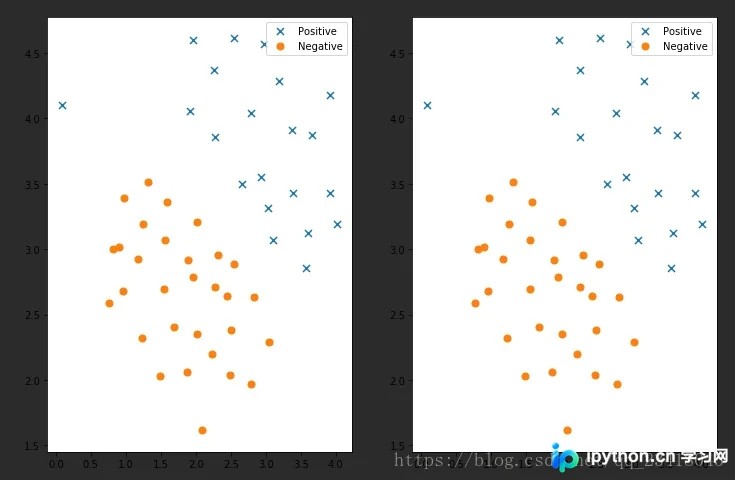
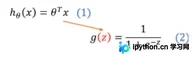
本文详细介绍在Python环境下使用逻辑回归解决二分类问题的完整流程。内容涵盖Sigmoid函数原理、对数损失函数的推导,并对比实现了梯度下降法与牛顿迭代法两种参数优化策略。通过具体实验数据,分析学习率对收敛速度的影响,展示如何计算分类边界及预测录取概率,为机器学习初学者提供从理论到代码的实操指南。
本文介绍使用Python实现自动清理文件夹中旧图片的功能。通过开启独立线程定期检测文件夹大小,当超过设定阈值时,按最后修改时间排序并删除最早的文件,直至符合大小要求。