

Python读取文本数据并转换为DataFrame的完整流程
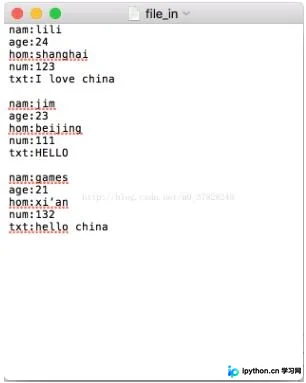
本文介绍如何使用Python和Pandas库,将包含“类别:内容”格式的纯文本文件转换为结构化的DataFrame表格。通过遍历文件行、利用冒号分割键值对并构建字典,最终生成包含指定列名的DataFrame对象,实现从非结构化数据到表格数据的便捷转换。
2026-10-13
21

本文介绍如何使用Python和Pandas库,将包含“类别:内容”格式的纯文本文件转换为结构化的DataFrame表格。通过遍历文件行、利用冒号分割键值对并构建字典,最终生成包含指定列名的DataFrame对象,实现从非结构化数据到表格数据的便捷转换。
本文介绍如何使用Python调用百度语音识别API。首先通过SDK安装包获取AipSpeech对象,配置APP_ID、API_KEY和SECRET_KEY。接着演示如何读取本地PCM/WAV文件或通过URL进行识别,支持8k/16k采样率及中文、粤语、英文。文章包含完整的请求参数说明及成功/失败返回JSON示例,帮助开发者快速集成语音识别功能。
本文详解Python Pandas中DataFrame的行列选择与切片方法。对比loc、iloc、at、iat及ix函数的用法,说明基于标签与位置索引的区别。通过实例展示正确与错误的代码写法,总结各方法的适用场景及常见错误,帮助开发者高效进行数据筛选。
本文介绍在pandas中如何将DataFrame转换为Series,以及利用astype方法结合numpy模块修改列中值的数据类型。通过具体代码示例展示了创建Series时指定索引的技巧,以及使用np.int64等类型参数进行数据格式转换的实际操作,适用于需要处理数据格式的场景。
本文介绍如何利用Python的select模块实现Socket全双工异步通信,解决传统TCP通信中收发不能并行的问题。通过管理多个套接字连接,代码示例展示了服务器与客户端的一对一聊天功能,并探讨了基于服务器中转的多对多通信思路。
本文详解Python3中open函数的newline参数在读写文件时的行为差异。读取时,None将统一转为\n,空字符串保留原样;写入时,None自动转换为系统默认换行符,其他值控制具体转换逻辑。结合GBK与UTF-8编码异常处理及Makefile修改案例,提供实用的文件操作方案。
在使用Pandas处理CSV文件时,Excel中的空白单元格可能被解析为空字符串而非NaN,导致dropna()或fillna()失效。本文介绍通过正则替换空字符串为NULL,并在read_csv中指定na_values参数将其识别为缺失值,从而正确执行缺失值处理的操作流程。
本文详细介绍Django中实现文件下载的三种主要方式:HttpResponse、StreamingHttpResponse和FileResponse。通过对比源码与适用场景,指出FileResponse作为StreamingHttpResponse子类,利用迭代器处理大文件流传输的优势,并推荐在实际项目中优先使用FileResponse以获得更好的性能与内存管理。
本文介绍如何在Python中将二维数组转换为图片进行可视化展示。通过导入matplotlib库并使用imshow函数,可以直观地将数值矩阵渲染为图像,适用于数据分析和图像处理场景。
本文探讨Python中max函数在处理二维列表时的具体行为。通过实例测试发现,当对包含子列表的二维列表使用max函数时,其比较逻辑基于子列表的首个元素。若首元素相同,则继续比较后续元素。理解这一机制有助于在算法开发中正确提取最大子列表。
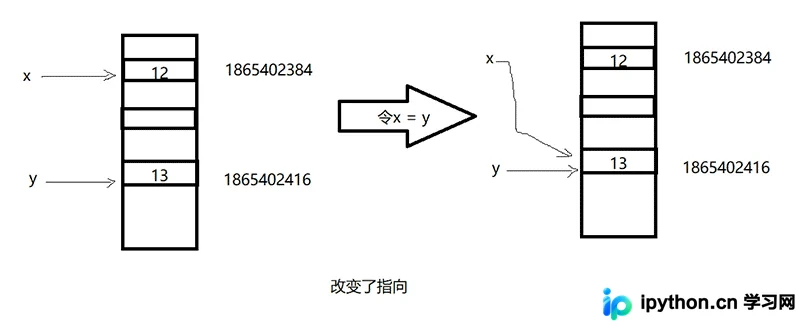
本文深入解析Python中的变量赋值机制,通过id()函数查看内存地址,揭示Python采用引用传递而非值传递的特点。对比C语言直接修改内存值的方式,说明Python赋值即改变变量指向的行为,帮助开发者理解变量绑定与内存管理的关系。
本文介绍Python Num库中nonzero()函数的核心用法。该函数用于返回数组中非零元素的索引坐标,结果以元组形式呈现,分别对应各维度的位置信息。通过示例代码展示了如何提取非零元素的行列坐标及其对应的值,帮助开发者高效处理矩阵数据。