

Python实现Beta分布概率密度函数及可视化方法
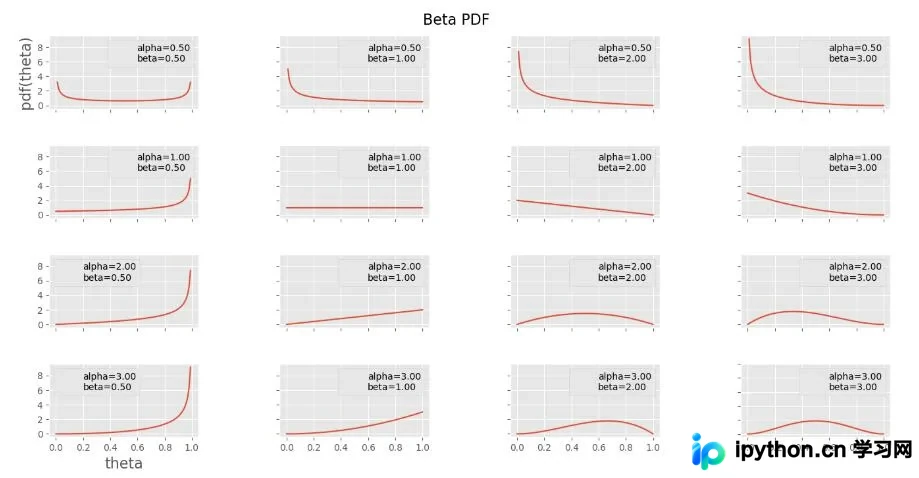
本文介绍如何使用Python的Scipy库计算Beta分布的概率密度函数,并通过Matplotlib绘制不同参数组合下的分布形态。代码展示了如何生成网格图以观察Alpha和Beta参数对分布形状的影响,包括U形、类正态及均匀分布等特征。
2026-10-13
21

本文介绍如何使用Python的Scipy库计算Beta分布的概率密度函数,并通过Matplotlib绘制不同参数组合下的分布形态。代码展示了如何生成网格图以观察Alpha和Beta参数对分布形状的影响,包括U形、类正态及均匀分布等特征。
本文介绍在 pandas DataFrame 中对指定列进行逻辑处理并生成新列或覆盖原值的方法。通过 df.apply 结合 lambda 函数,可实现按行处理数据。示例展示了如何根据列内容匹配特定关键词,利用正则表达式判断条件并赋值,适用于自动化测试分类等场景。
本文详解在pandas中读取CSV文件时如何查看和修改各列的数据类型。通过对比Numpy的dtype与Pandas的dtypes,介绍使用astype、to_numeric及infer_objects等方法进行类型转换的技巧,包括处理无效值和批量转换多列的实用方案。
本文介绍如何利用Python的pynput库模拟鼠标点击与键盘输入,实现自动登录QQ客户端。通过指定坐标定位并执行点击操作,结合Tab键切换焦点与键盘类型功能输入账号密码,最后模拟回车键完成登录。代码包含完整路径配置及延时控制,适用于Windows环境下的桌面应用自动化测试与操作。
本文介绍Python中zip函数如何同时迭代多个序列。解析zip在Python 2与3中的行为差异,演示生成元组迭代器的用法,并针对序列长度不一致的情况,介绍使用itertools.zip_longest的解决方案,帮助开发者高效处理多数据源遍历。
本文详解Python colorlog库中ColoredFormatter类的用法,涵盖安装、核心参数(format、log_colors等)、颜色转义码语法及secondary_log_colors的高级配置,并提供dictConfig、fileConfig及自定义日志级别的完整代码示例。
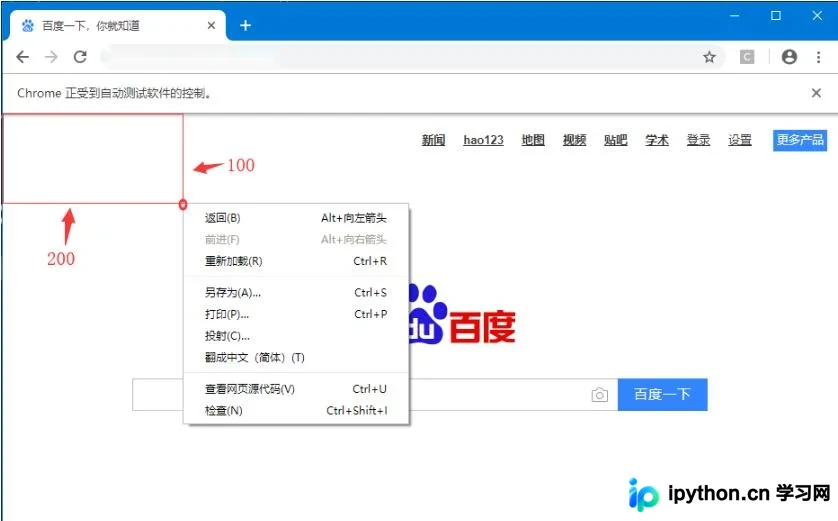
本文介绍如何使用 Python Selenium 的 ActionChains 库通过坐标点击网页元素。重点解析 move_by_offset 导致的坐标累积问题,并提供封装函数恢复鼠标位置的解决方案,适用于元素定位困难但位置固定的场景。
本文详解如何利用Python PIL库读取图像EXIF中的Orientation信息,自动修正因拍摄角度导致的图像旋转问题。通过解析EXIF数据并调用rotate方法配合expand参数,确保图像在后续处理中保持正确的显示方向与尺寸。
本文介绍在Linux系统中升级Python至3.x版本后,yum工具因默认调用新解释器而引发的SyntaxError错误。通过修改/usr/bin/yum及urlgrabber相关脚本的首行解释器路径,强制指定使用python2.7,可恢复yum正常安装软件功能。
本文介绍利用pandas库中的drop_duplicates方法提取重复数据的技巧。通过分别执行keep=False和keep='first'两种去重操作,获取完全去重与保留首条记录的差异结果,进而通过合并与再次去重找出所有重复项。
本文详细介绍Pandas中用于数据分析的累积计算(cum系列)与滚动计算(rolling系列)函数。cum系列作为DataFrame或Series的方法,用于生成前n项的累计和、积、最大值等;rolling系列则通过指定窗口大小k,对数据进行滑动窗口统计,如计算滚动均值、方差等。文章提供了具体的代码示例和输出结果,帮助开发者掌握这两种常用统计技巧。
本文详细介绍如何使用Python读取Excel文件(包括xlsx和xls格式)并进行数据分类统计。通过openpyxl和xlrd两个库,分别演示了基础数据提取与复杂通话记录的分类统计方法,涵盖按地点、类型及号码汇总时长的完整代码实现。