Python爬取智联招聘数据分析师岗位信息实战
本文介绍如何利用Python爬虫技术抓取智联招聘网站上的数据分析师岗位信息。通过浏览器开发者工具分析网络请求,定位Ajax接口并构造请求参数,最终使用Python代码实现数据提取与保存,为求职分析提供数据支持。
2026-10-13
21

本文介绍如何利用Python爬虫技术抓取智联招聘网站上的数据分析师岗位信息。通过浏览器开发者工具分析网络请求,定位Ajax接口并构造请求参数,最终使用Python代码实现数据提取与保存,为求职分析提供数据支持。
本文探讨Python2中常见的中文乱码问题,特别是当Unicode字符串被错误地按GBK系列编码解码时产生的现象。通过分析repr()输出及字节序列,揭示“会员”等汉字显示为“盲录職氓聭聵”的原因,并提供使用encode('raw_unicode_escape').decode()进行修复的具体方法。
本文详细介绍如何使用Python编写爬虫程序,通过知乎开放API获取话题下的回答列表,并利用百度云人脸检测接口对图片进行颜值评分。教程涵盖环境配置、API调用、反爬策略处理及图片保存逻辑,帮助开发者实现自动化筛选高颜值图片的功能。
本文介绍如何利用Python的re模块,通过一行正则表达式代码高效过滤文本中的中英文标点符号及特殊字符。详细解析了\W匹配规则及自定义字符集的方法,提供完整代码示例与测试结果,帮助开发者快速实现文本清洗功能。
本文介绍在Django中,当视图传递包含嵌套字典及模型对象的复杂数据结构至模板时,如何通过自定义过滤器解决直接访问问题。通过定义get_key和get_attr两个过滤器,实现从字典中提取对象并获取其属性值,适用于处理深层嵌套数据场景。
本文对比了Django中直接使用Q对象进行条件查询与使用django-filter插件生成动态查询界面的两种方法。通过展示filter.py配置、widget样式设置及前端form渲染,详解如何利用django-filter自动生成文本框、下拉框等查询控件,提升开发效率。
本文提供基于Python的简易图书管理系统完整代码。系统采用面向对象设计,实现书籍查询、借阅、归还、用户借阅记录查看及系统退出等核心功能。代码包含书籍库存与学生借阅数据的初始化逻辑,并通过控制台交互循环处理用户指令,适合Python初学者参考学习基础数据结构与流程控制。
本文详细讲解在Python中利用Pandas处理时间序列数据时遇到的日期缺失问题。通过示例代码展示如何构建连续日期序列,并将原始数据映射至完整时间轴,实现缺失日期的自动填充与插值替换。适合需要进行时间序列分析且遇到数据预处理瓶颈的开发者参考。
本文详解Python内置doctest模块的使用方法。通过扫描模块内的文档字符串并执行其中的示例代码,doctest能够验证代码输出是否与文档一致。文章包含average函数的完整测试代码及运行结果分析,展示如何配置verbose参数以查看详细测试报告,帮助开发者快速掌握基于文档的自动化测试技巧。
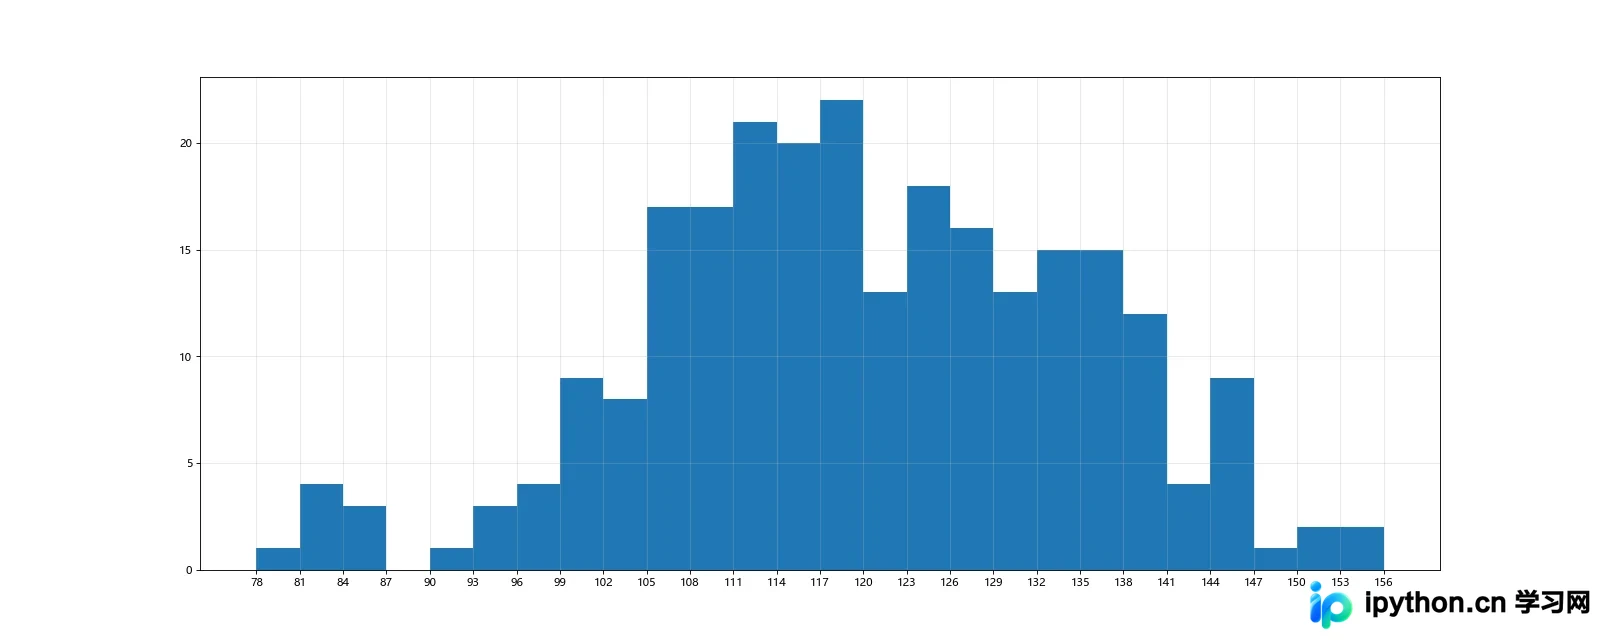
本文通过统计250部电影时长的实例,详解如何使用Python matplotlib库绘制频数分布直方图。重点讲解组距、组数的计算逻辑,以及plt.hist()函数的参数配置,包括如何设置中文显示、调整图片尺寸及网格透明度,帮助读者掌握数据分布可视化的核心技巧。
本文解决Django中自定义App的Models表在同步数据库时未成功创建,且对应Migrations目录为空的问题。通过执行makemigrations --empty生成初始迁移文件,再运行makemigrations和migrate命令,即可正常同步数据库并创建表结构。
本文详细介绍Django ORM中的聚合查询与分组查询功能。通过aggregate()函数实现Avg、Sum等全局统计,返回字典结果;利用annotate()为QuerySet添加聚合字段,结合filter进行条件筛选。文章包含Publisher、Book、Author模型定义及具体代码示例,解析如何计算书籍价格统计及作者关联数量,帮助开发者高效处理数据库复杂查询。