

Python爬虫遭遇反爬报错:通过添加User-Agent伪装浏览器请求
本文针对Python爬虫突然报错Http 800 Internal internet error的问题,分析原因为目标网站启用了反爬虫程序。通过对比修改前后的代码,演示如何为urllib.request.Request对象添加User-Agent头部信息,伪装成浏览器请求以绕过限制,恢复爬虫正常运行。
2026-10-13
22

本文针对Python爬虫突然报错Http 800 Internal internet error的问题,分析原因为目标网站启用了反爬虫程序。通过对比修改前后的代码,演示如何为urllib.request.Request对象添加User-Agent头部信息,伪装成浏览器请求以绕过限制,恢复爬虫正常运行。
本文详解如何利用Python的PIL库生成随机验证码。内容涵盖从安装Pillow依赖库开始,逐步演示创建画布、绘制点线圆、添加文本及特殊字体文字等基础操作,最终整合为包含干扰元素和随机字符的完整验证码生成函数,提供可直接运行的代码参考。
本文详解Python中利用正则表达式替换匹配成功组的方法。通过re模块的sub()和subn()函数,结合反向引用语法(如\1),实现字符串模式的灵活替换。文章包含Python 3.6环境下的代码示例,演示如何将文本中的特定标记替换为HTML标签,并展示完整的执行结果与输出分析。
本文介绍如何在Python中使用threading模块获取多线程函数的返回值。通过封装MyThread类,利用trace_func包装目标函数,捕获执行结果并汇总至ret_flag。该方法解决了标准threading未直接提供返回值获取接口的问题,适用于需要并行执行并验证所有操作成功状态的场景。
本文通过Python标准库中的turtle模块,逐步演示如何绘制一朵精美的花卉。从引入模块、创建窗口与海龟对象,到定义菱形函数并循环旋转360度,最终生成包含长茎的完整花朵图形。适合初学者理解函数封装与循环逻辑,附带完整可运行代码。
本文介绍了如何使用Python的urllib库实现简单的句子翻译功能。通过向百度翻译接口发送请求,并将翻译内容作为参数传递,最终获取并打印翻译结果。文章还详细讲解了urlopen、Request等核心用法及响应处理,适合Python初学者参考。
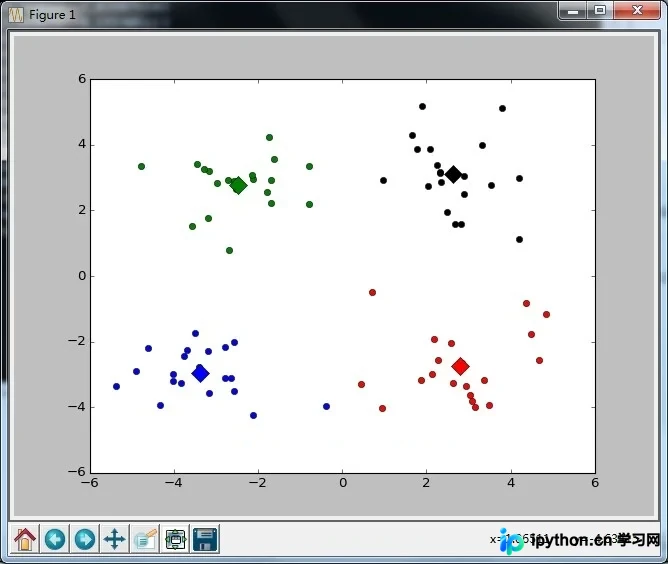
本文详细解析Python中K-Means聚类算法的实现过程,涵盖算法优缺点、核心思想及关键步骤。通过提供完整的Python代码示例,展示如何加载数据、计算欧氏距离、生成初始质心并迭代优化。同时结合可视化结果,直观展示聚类效果及局部最优问题,帮助开发者深入理解并应用该算法。
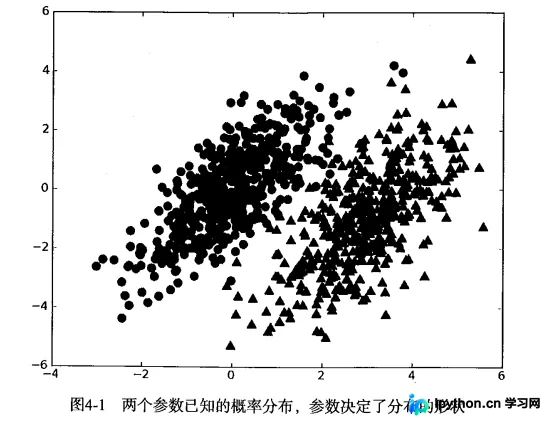
本文深入解析基于概率论的朴素贝叶斯分类算法。从贝叶斯定理与条件概率基础入手,阐述核心决策理论,并详细演示在Python中构建词向量、计算特征概率及训练分类器的完整流程。通过社区留言过滤案例,展示如何处理标称型数据,帮助读者掌握这一高效的多类别分类方法。
本文深入解析Python的内存管理机制,重点探讨引用计数与分代垃圾回收算法的协同工作原理。文章详细说明了如何处理循环引用问题,解析了gc模块中gc_refs字段在识别不可达对象中的作用,并讨论了包含__del__方法的对象(Finalizer)在回收过程中的特殊处理策略及性能开销。
本文介绍了Python实现购物车功能的方法,通过列表和元组存储商品信息,利用enumerate函数遍历商品列表,实现用户购买、查看购物车和退出等功能。
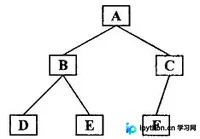
本文介绍如何使用Python实现二叉树的先序遍历。通过定义TreeNode类构建二叉树结构,并利用递归方法按“根-左-右”顺序访问所有节点。文章包含完整的代码示例及遍历结果分析,帮助开发者理解并应用该经典算法。
本文系统梳理Python中文件操作的核心方法。涵盖以'r'、'w'、'a'模式进行读写与追加,详解read、readline及readlines的读取差异。深入讲解tell()与seek()的光标定位机制,以及flush()实时写入和truncate()截断功能。通过代码示例展示不同模式下的行为差异,帮助开发者掌握文件处理的最佳实践。